


本文标题为《Development and External Validation of a Contrastive Learning Foundation Model for ECG-based Prediction of Cardiovascular Diseases and Outcomes》,作者为Michael Ko、Matteo Gadaleta、Eric J Topol、Evan D Muse、Giorgio Quer,发表于The Lancet Digital Health。本研究基于Scripps Health GE MUSE系统的大规模回顾性12导联心电图(ECG)数据集,构建了心电基础模型ECG-CLIP,其预训练采用"掩码心电重建+心电—文本对比学习"两阶段框架,并首次将心内科医师审核(clinician-overread)后的自由文本ECG报告纳入预训练监督信号;模型在独立外部数据集MIMIC-IV上完成心血管疾病检测、心血管疾病预测与不良健康结局预测三类共九项下游任务的系统验证,并与两个监督基线模型、一个非心电基础模型(OpenAI CLIP)以及三个心电信号类基础模型(ECGFounder、DeepECG-SL、DeepECG-SSL)横向比较。结果显示ECG-CLIP在所有检测与预测任务上均取得最优或并列最优表现,且具备极高的标签效率与导联效率。作者最终提示,ECG-CLIP是一个可泛化的心电基础模型,能够从ECG与其配套报告中学习具有临床意义的表征,从而实现准确、数据高效且可解释的风险预测,支持在真实世界与资源受限环境中规模化部署。
01 摘要
心血管疾病评估通常始于12导联心电图,全球每年实施超过3亿次,但人工判读存在技能差异、难以客观比较同一患者多份ECG等局限;而基于AI的心电分析多聚焦高度特异的单项任务,依赖大量精细标注。本研究旨在开发大规模心电基础模型ECG-CLIP,以提升ECG分析的泛化能力与临床可用性。
研究使用Scripps Health GE MUSE系统2008年1月至2019年1月院内采集的超过170万份ECG及配套医师审核报告(542 288例患者),以掩码心电重建与心电—文本对比学习两阶段框架预训练,并在独立外部数据集MIMIC-IV(超过80万份ECG)上评估心血管疾病检测、心血管疾病预测与不良健康结局预测三类共九项任务,以五折交叉验证的AUC报告结果,并通过改变阳性标签数量考察标签效率。
ECG-CLIP在全部检测与预测任务上持续优于监督基线模型与非心电基础模型。当仅有10个阳性标签时,急性心肌梗死检测AUC为0.910(95%CI 0.903–0.916),显著优于次优模型的0.884(0.876–0.892),心脏淀粉样变(0.790 vs 0.777)、肥厚型心肌病(0.772 vs 0.754)与心房颤动预测(0.777 vs 0.765)亦均领先;在心血管疾病检测任务中达到最佳对比模型的同等AUC平均只需减少90.8%的训练数据。作者指出,ECG-CLIP能学习具有临床意义的表征,支持在真实世界与资源受限环境中规模化部署。本研究由VoLo基金会与美国国立卫生研究院资助。
02 研究背景
心血管疾病评估通常始于12导联心电图,全球每年实施超过3亿次,但人工判读存在技能差异大、难以客观比较同一患者多份ECG等局限,由此产生的诊断错误后果严重;而基于AI的心电分析通常聚焦高度特异的单项任务,依赖大量精细标注,在缺乏临床专业知识的场景下难以推行。大型基础模型的出现使模型能够以少量标签泛化到多种任务。
作者在PubMed检索了2016年1月至2026年4月的相关文献,共识别出22篇开发心电基础模型的研究。既有模型虽多能提升诊断与预测性能,但多数仅依赖信号单模态预训练,仅3项引入文本监督且多使用机器生成或结构化的报告字符串;跨多样临床应用的系统评估仍然稀缺,也缺少对ECG表征与医师审核报告之间对齐的探索。本研究据此提出ECG-CLIP,直接利用原始文本标注分析12导联ECG与其配套报告,以与临床知识实现更丰富的整合,并聚焦三类任务:心血管疾病检测(急性心肌梗死、心脏淀粉样变、肥厚型心肌病)、心血管疾病预测(从窦性心律预测心房颤动)与不良健康结局预测(30天急诊与术后死亡、3年慢性肾脏病与2型糖尿病发病)。
03 模型设计
1.任务建模思路
本研究将模型构建与验证拆解为"预训练—微调—评估"三阶段范式。预训练属于自监督/多模态表征学习任务,目标是仅凭ECG波形与其配套临床报告学习可迁移的通用心电表征;下游阶段则建模为监督二分类任务,即在预训练心电编码器之后接线性分类头并端到端微调,用以区分患病与否或结局发生与否。研究设定三个递进目标:验证以临床报告为监督信号的预训练能否带来更强表征能力;评估模型在三大类任务上的可迁移性;从标签效率、导联效率与跨数据集泛化三个维度刻画其实用边界。与"一个任务训练一个模型"不同,本研究追求一个共享表征底座支撑多个异质临床任务,价值定位是通用心电智能底座与低成本本地化开发能力,而非某一疾病的专用诊断器。
2.双阶段预训练与模型架构
这是全文方法学核心。模型由心电编码器—解码器与临床文本编码器组成:编码器为适配一维ECG信号的Transformer(12层、8个注意力头、512维嵌入),解码器为类似架构但仅6层,文本编码器基于BioClinicalBERT。第一阶段的掩码心电重建以75%的掩码比例遮挡心电信号片段,以平均绝对误差损失驱动模型从残缺波形中重建原始信号,使其在无标签条件下压缩波形结构、捕捉心电形态学与节律学规律。第二阶段为重建与心电—文本对比学习的联合优化:将ECG与配套报告分别编码,通过投影后心电嵌入与文本嵌入之间的余弦相似度构造对比损失并与重建损失联合优化,把波形空间的结构表征拉向临床语言空间的语义表征。微调阶段采用统一而简洁的适配方式——在预训练编码器的最终表征之上添加线性分类头并端到端微调,以检验预训练表征本身的迁移质量,而非依赖任务专用结构。
3.对比模型与评估策略
研究构建四类共六个对比模型,形成能力递增的参照链:监督基线为在原始ECG信号上训练的ResNet与使用年龄、性别及常规心电特征的线性模型(baseline);为分离"心电特异性预训练"的贡献,纳入OpenAI CLIP作为未经心电预训练的通用视觉—语言基础模型;为与同期心电基础模型对标,纳入ECGFounder(预训练语料超过1000万份ECG、使用人工提取的临床标签)、DeepECG-SL与DeepECG-SSL。
评估以AUC为主要指标,MIMIC-IV下游任务采用以个体分层的五折交叉验证(无患者重叠),超参数经Optuna贝叶斯优化搜索10组试验,最终指标取五折测试均值,置信区间与显著性检验采用非参数bootstrap重抽样10 000次(p<0.05为显著)。研究另设三项边界能力实验:标签效率在保持患病率不变的前提下于对数尺度选取10至1000个阳性标签之间的11个评估点,以"达到次优模型全量数据同等表现所需数据量的相对比例"量化;导联效率仅输入单一导联,考察模型能否从对某类心肌梗死并不典型的导联中检出病灶(III、aVR、aVL、aVF因是I导与II导的精确线性组合而排除);跨数据集泛化以MIMIC-IV为外部测试队列、Scripps为内部微调队列,微调后不作额外适配直接评估。
4.模型可解释性策略
研究采用SHAP值采样为微调模型生成解释图,通过随机扰动输入并观察输出变化计算归因分数。针对信号时序特点,作者以R峰前175 ms至R峰后275 ms为窗口构造以单个心搏为中心的结构化扰动,将归因对齐到R峰中心窗口后对各个心搏及全部记录求平均,使显著性图不被心搏间时间抖动淹没。
04 实验设置
1.研究设计与数据来源
本研究为回顾性队列研究,心电数据来自Scripps Health的GE MUSE系统,纳入2008年1月15日至2019年1月15日院内采集的超过170万份匿名12导联ECG,来自50万余例个体;人口学数据取自随每份ECG导出的结构化患者字段。研究经Scripps Health机构审查委员会批准(IRB 20–7504),因使用回顾性去标识化数据而豁免知情同意。外部评估数据来自MIMIC-IV的三个模块,其中MIMIC-IV-ECG包含2008至2019年间采集的800 035份诊断性ECG、来自161 352例患者,MIMIC-IV与MIMIC-IV-Ext-MDS-ED提供用于派生下游诊断与结局标签的关联电子健康档案数据。附加的急性心肌梗死定位与心房颤动预测任务在Scripps的微调分区与留出测试分区上完成。
2.纳入与排除标准及数据集划分
纳入标准为上述时间窗内院内采集的匿名12导联ECG,排除重复以及数据损坏或缺失的ECG:1 704 047份中剔除24 163份,最终纳入1 679 884份ECG(538 028例患者)。数据划分严格遵循患者层面互斥原则:全部患者先按90:10随机分为开发分区与留出测试分区,开发分区再按90:10拆分为预训练分区与微调分区。每份ECG均与一份医师审核报告配对,该报告定义为初始自动分析经复核编辑后由医师最终确证的解读结果,经正则表达式、命名实体识别与人工复核完成标准化。本文的核心验证属"内部大规模数据预训练+独立外部数据集评估"组合:MIMIC-IV提供了与训练来源机构、采集系统、人群构成均不相同的外部检验,这是其区别于多数仅报告内部验证的心电AI研究的关键设计。
3.统计学分析方法
性能以AUC评价并报告均值与95%置信区间;置信区间估计与显著性检验采用非参数bootstrap重抽样10 000次,多模型比较亦通过bootstrap检验判定"与最优模型无显著差异"的集合。超参数优化使用Optuna贝叶斯优化框架(10组试验),标签效率量化基于对数尺度线性插值,R峰检测使用WFDB Python包。研究由VoLo基金会与美国国立卫生研究院国家转化科学促进中心(UM1TR004407)资助。
05 结果与分析
1.研究队列基线特征
最终纳入1 679 884份ECG(538 028例患者),数据集具备相当的人口学多样性:36.0%来自18–59岁个体,19.2%来自非白人个体,49.4%来自女性。医师审核报告显示正常窦性心律占58.2%,异常窦性心律26.3%,房性心律失常14.6%,室性心律失常6.1%。这些比例并非人工构造的实验分布,而是真实临床流程中自然形成的报告统计,这是以自由文本报告作为监督信号的前提,也意味着队列天然包含大量共病、边缘性与表述模糊的样本。
2.心血管疾病检测与预测性能
在MIMIC-IV评估中,ECG-CLIP在所有检测任务上持续优于全部监督模型与非心电基础模型。急性心肌梗死检测AUC为0.963(0.959–0.967),显著优于OpenAI CLIP(0.940)与ResNet(0.945)(均p<0.0001);在训练集患病率低于0.4%的心肌病检测中,心脏淀粉样变AUC为0.852(0.835–0.869),肥厚型心肌病为0.861(0.843–0.877)。值得注意的是,心脏淀粉样变检测中ResNet(0.752)的表现与仅用人口学与常规心电特征的基线模型(0.738)相当,说明纯监督深度学习在极罕见病上几乎无法提取有效模式。预测任务上,从窦性心律ECG预测未来心房颤动的AUC为0.867(0.864–0.870),优于ResNet(0.858)、OpenAI CLIP(0.838)与基线(0.787)。不良结局预测同样全面领先:30天急诊死亡0.855(次优0.820),30天术后死亡0.797(次优0.762),3年慢性肾脏病发病0.802(次优0.785),3年2型糖尿病发病0.729(次优0.701)。
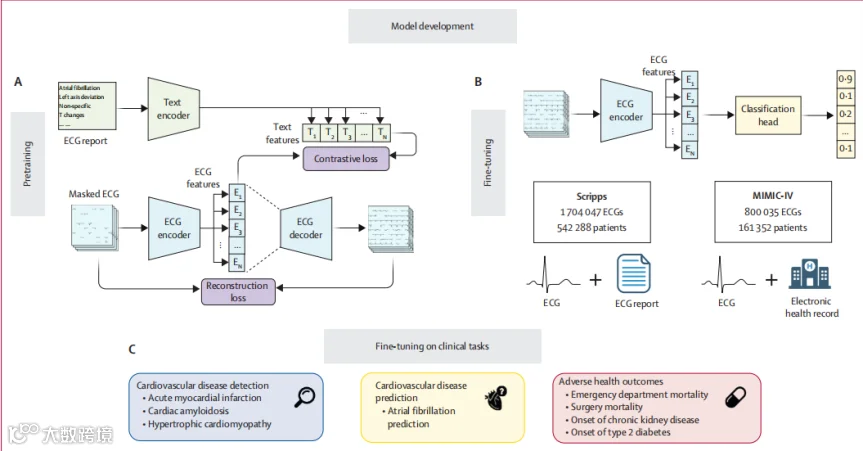
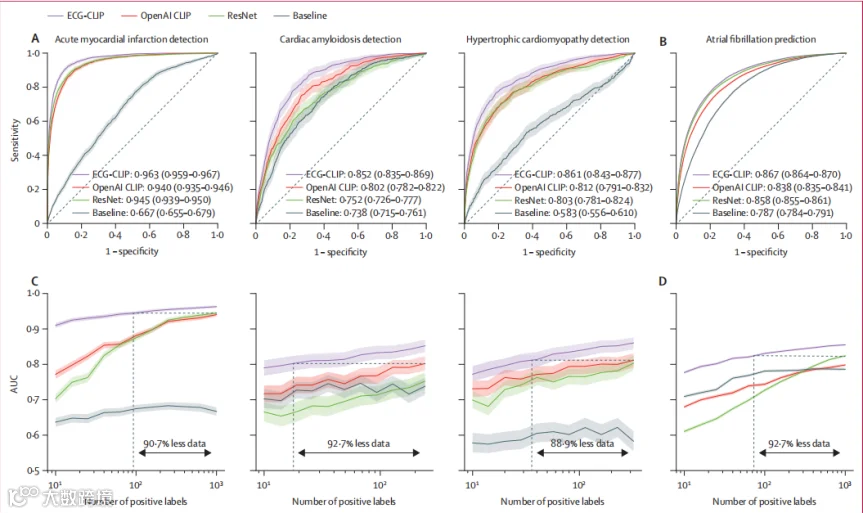
图2 心血管疾病检测与预测任务的性能与标签效率。
(A)三项检测任务性能;(B)窦性心律下心房颤动预测性能;(C)(D)相应任务的标签效率曲线(横轴为对数尺度阳性标签数)。
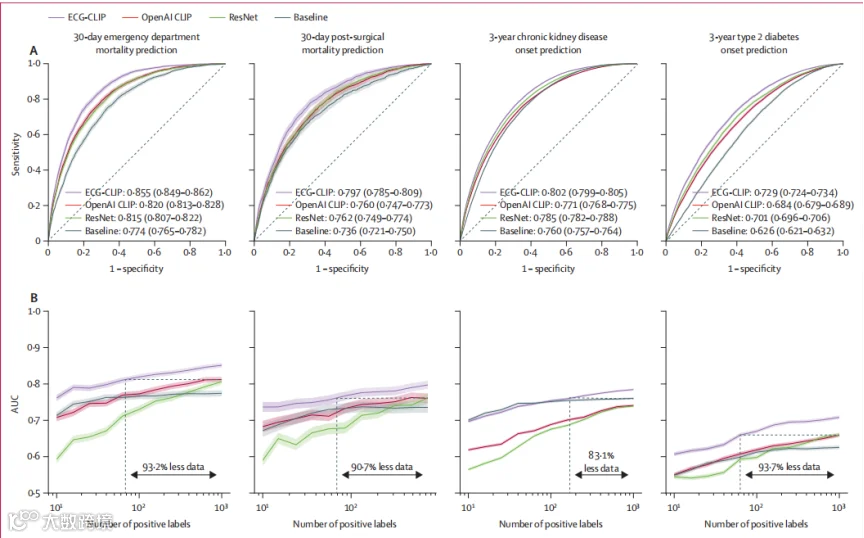
图3 不良健康结局预测任务的性能与标签效率。
(A)四项结局预测任务性能;(B)相应任务的标签效率曲线。
3.标签效率与心电基础模型横向比较
标签效率是本文的核心量化结论。以"达到次优模型全量数据同等表现所需数据量"衡量,ECG-CLIP在急性心肌梗死检测上少用90.7%的数据,心脏淀粉样变检测少用92.7%,肥厚型心肌病检测少用88.9%,心房颤动预测少用92.7%;结局预测任务中,30天急诊死亡少用93.2%,30天术后死亡少用90.7%,3年慢性肾脏病发病少用83.1%,3年2型糖尿病发病少用93.7%——即在心血管疾病检测任务中平均只需减少90.8%的训练数据即可达到最佳对比模型的同等AUC。
与三个心电基础模型的比较显示,ECG-CLIP在低标签设置下一致取得数值最优表现,且增益在仅有10个阳性标签时最为突出;随标签增加差距逐渐缩小,但ECG-CLIP在部分任务的全量数据设置下仍保持优势,最典型的是肥厚型心肌病检测,其AUC 0.861显著优于次优模型DeepECG-SSL的0.829(p<0.0001)。值得注意的是,DeepECG-SSL在10个阳性样本时相对较强,但其性能并未随数据量增加而同步扩展,提示"低标签优势"与"可扩展性"并不等价;作者还主动披露该模型的预训练语料包含MIMIC-IV-ECG,可能因数据泄漏导致性能估计偏高。更具说服力的对比是:ECGFounder的预训练语料超过1000万份ECG并使用人工提取的临床标签,而ECG-CLIP仅约170万份,却在心脏与非心脏预测任务上普遍取得更优表现——这一"以少胜多"是"自由文本监督信号优于离散标签提取"这一核心论点的最直接证据。
4.跨数据集泛化、导联效率与可解释性
在跨数据集评估中,作者以Scripps微调、在外部MIMIC-IV上测试,未作额外适配即取得与同队列评估一致的结果,性能下降很小,并显著优于其他受测模型——这一点尤其重要,因为监督模型在应用于不同设备或机构采集的数据时性能往往显著下降。导联效率评估中,全部模型在前壁急性心肌梗死上精度最高的均为V2、V3、V4导联,下壁对应I导与II导,与临床预期一致;当改用I、II及V5–V6等通常信息量较低的导联时AUC明显下降,但ECG-CLIP仍维持0.755至0.815,而OpenAI CLIP与ResNet仅为0.466至0.679;用V1–V6导联检测下壁急性心肌梗死时,ECG-CLIP为0.799至0.857。OpenAI CLIP在低信息量导联下最低跌至0.466,已低于随机水平,这一"负对照"强化了结论的说服力。可解释性方面,显著性图显示前壁急性心肌梗死的正向贡献区域定位于V2、V3、V4导联的ST段,下壁定位于I导与II导的ST段,与心内科医师的判断依据完全吻合。
5.与现有风险分层工具的关系
作者将ECG-CLIP与现行风险计算器作了明确区分。PREVENT公式与修订心脏风险指数之所以被广泛采用,是因为其依赖常规诊疗中普遍采集的数据、可快速标准化分层;作者认为ECG-CLIP与它们是互补而非替代关系:ECG在绝大多数临床场景中同样易得,却能额外提取超越传统风险评分的潜在生理信息,从而支持更准确、更敏感的风险估计与更早期的个体化诊疗。作者同时审慎指出,模型在受控医院环境、由受训人员采集的数据上开发与评估,其在多中心、不同种族与共病特征人群、可穿戴与小型设备等更广泛场景中的潜力尚待确立;预训练依赖医师编辑的报告,而报告受机构书写规范影响、详细程度不一且偶有错误,可能引入额外偏倚与噪声,因此仍需前瞻性临床试验才能确立其真实世界适用性。
06 结论
本研究构建并外部验证了心电基础模型ECG-CLIP,其预训练融合掩码心电重建与心电—文本对比学习,首次将心内科医师审核报告作为监督信号纳入心电基础模型预训练。基于1 679 884份12导联ECG与配套报告的预训练,使模型在上述九项任务上于独立外部数据集MIMIC-IV中一致优于两个监督基线模型、一个非心电基础模型与三个心电信号类基础模型。模型达到对照模型全量数据同等性能平均仅需减少90.8%的训练数据,在仅有10个阳性标签时依然领先;同时具备良好导联效率与跨数据集泛化能力,并通过显著性图证明其关注区域与临床判断依据一致。作者认为ECG-CLIP是一个可规模化、可适配的心电基础模型,在低患病率、小样本标注与少导联等当前医疗AI的关键难点场景下具备优势。
07 论文评价
✅方法创新亮点
-
首次把心内科医师审核的自由文本报告用作心电基础模型的预训练监督信号。 -
以"掩码重建+心电—文本对比"的两阶段设计构造"先学结构、再学语义"的表征路径,并给出模块效用的可分离证据。 -
把标签与导联效率提升为一等评估维度,并以多轴压力测试精确刻画适用边界。
⚠方法不足
08 参考资料
Article:
编辑:杨梦洁
审核:吴朝
