

最近大家一直在谈 RSI,简单说就是 AI 自己改进自己。以前这更多是论文和访谈里的概念,最近有个开源项目 Raven 把它做成了能跑的工程。

Raven 的中文海报:让 AI 改进 AI,每一轮都从上一轮的终点出发(图源:EverMind-AI/Raven 仓库)
Raven 是 EverMind AI 做的,Apache 2.0 协议,5 月建库,现在 4800 多星,配了一份 82 页的技术报告。README 自己标的是 pre-alpha,接口和配置还会快速变化。
01Raven 自己不干活,它是"包工头"
你给它一个任务,它负责拆解、派活、验收。拆出来是一张有依赖关系的任务图,哪些能并行、哪些要等上一步,它来排。
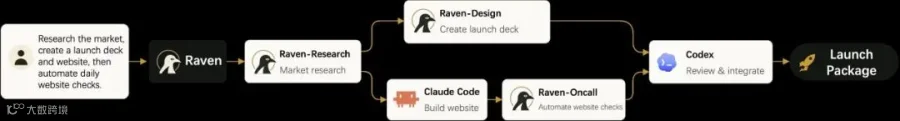
给 Raven 一句话:调研市场、做发布演示和网站、再每天自动检查网站。它拆成五个子任务,分给调研、设计、Claude Code、值守、Codex 各自去做,最后汇成一个发布包(图源:Raven README)
手下有四个自带的 Agent:
- ▪Raven-Research
:调研,出带可追溯来源的结构化报告 - ▪Raven-Code
:写代码,从需求到能跑、测过的代码 - ▪Raven-Design
:做设计,PPT、品牌物料、图表、网页界面 - ▪Raven-Oncall
:无人值守跑流程,实验、优化、持续监控,能连续跑几个小时甚至通宵,只在需要人拍板时找你
它还能把现成的 Agent 拉进来一起干,通过 ACP、命令行或 OpenAI 兼容接口接入,预置了 13 家:Claude Code、Codex、OpenCode、Hermes、OpenClaw、MiroThinker、GitHub Copilot、Qwen Code、CodeBuddy、Qoder、Grok Build、Kimi Code、Pi。作者把它叫作 harness of harnesses,意思是管 Agent 的 Agent。
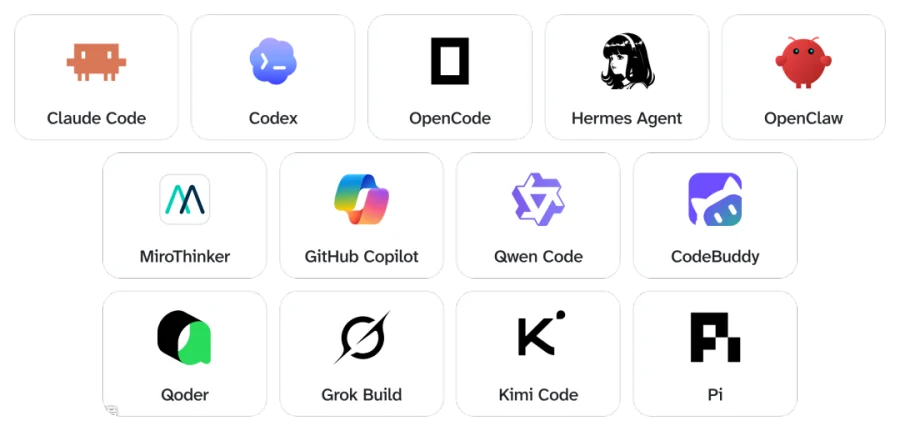
预置的 13 家第三方 Agent(图源:Raven README)
报告里有一个专门测"拆任务、排依赖"的多 Agent 编排基准。同一个底座模型下,Raven 拆出来的任务图比 Hermes 和 Claude Code 更接近标准答案。

多 Agent 编排基准:同一底座下,Raven 的节点、依赖边、先后顺序、完全匹配四项都最高(图源:Raven 技术报告)
02它改的是 harness 的做事方法
Raven 做 RSI 时模型权重一动不动,改的是模型外面那层做事方法。报告把它拆成四个可以替换的模块:
- ▪Memory
:这一轮能看到什么,也就是记住什么 - ▪Planning
:怎么规划这件事 - ▪Capability
:这一轮能调用哪些工具 - ▪Action
:下一步干什么,以及动手前怎么检查
改进流程分四步:先诊断失败原因,再提出改法,接着拿基准测试去验证,只有比原来好的改动才会被保留。
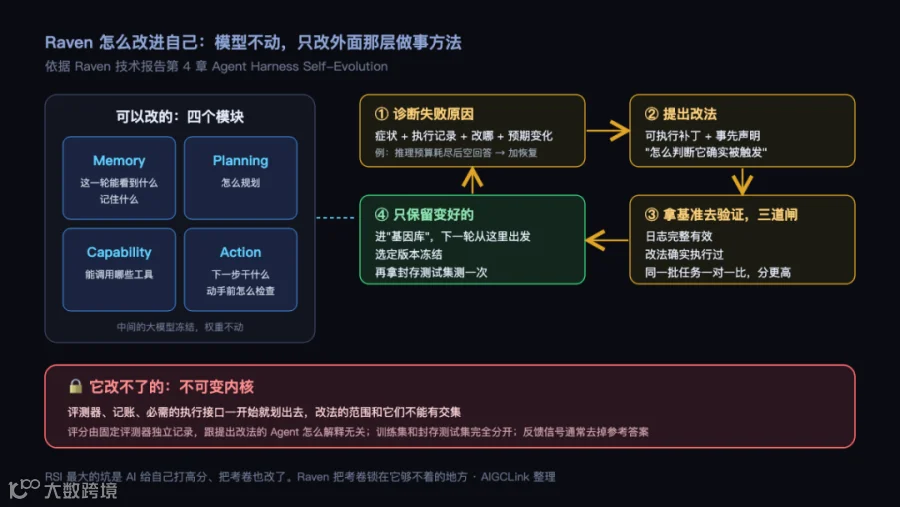
Raven 的 harness 自我进化循环,以及它改不了的那一块
报告里写得更细。诊断要指出症状、支撑它的执行记录、准备改哪个位置、预期会改变什么行为,比如"推理预算用完后给了空回答"就该加一个恢复机制,"改了代码却没测"就该加一个收尾检查。每个改法在评测前就要声明"怎么判断它确实被触发了"。验证分三道闸:日志完整有效,改法确实执行过,同一批任务上跟原版一对一比分数更高。最后选出来的版本冻结,再拿一个它从没见过的测试集去测。
03有个关键设计:评分标准它自己改不了
这点很重要。RSI 最大的坑是 AI "给自己打高分",把考卷也改了。
Raven 的做法是把可改的位置和不可改的位置在一开始就划清。报告的原话是一个"不可变内核",保护的正是评测、记账和必需的执行接口。评分由一个固定的评测器来做,它记录分数和"改法有没有被触发",跟提出改法的那个 Agent 怎么解释无关。训练用的任务集和最终测试集完全分开,测试集是封存的。README 里另一处也提到,每轮反馈给它的信号通常会去掉参考答案。
这个设计避免了踩这个坑。
04呈现的结果
1. nanochat 预训练:AI 自己把训 AI 的方法调得更好了。 7 轮跑了 172 次训练,一次没崩。同样是单卡 20 分钟的预算,val_bpb 降了 5.8%。
报告里还有一组同类实验,让 Raven-Oncall 和 Claude Code 在同一底座、同样 5 个 GPU 小时的预算下各跑一次,从 1.108 开始往下压:
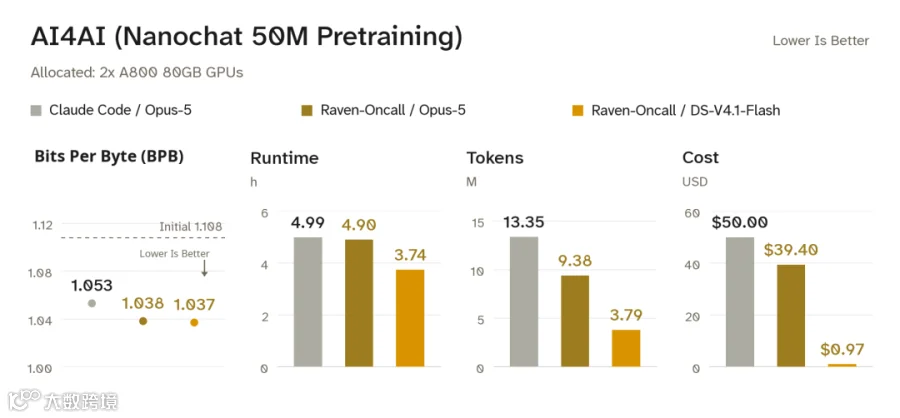
nanochat 5000 万参数预训练:Raven-Oncall 用 Claude Opus 5 压到 1.038、花 39.4 美元,Claude Code 是 1.053、50 美元;换成 DeepSeek-V4.1-Flash 压到 1.037,只花 0.97 美元(图源:Raven 技术报告)
2. 溃坝流体仿真: 把超调量压低了三个数量级。同一套流程还用 8 轮二分法完成了一个有限元极限载荷搜索。
3. 连续约 4 天、42 轮,独立做完一个 FPS 游戏。 用 Godot 4 做的第一人称射击,核心是一场竞技场 Boss 战,外加海报、PPT 和官网,全部是它自己出的。

Raven 独立做完的游戏 THRESHOLD 的海报(图源:Raven README)
报告还单独测了 harness 进化本身:模型冻结不动(Qwen3.6-27B),只进化 harness,在 7 个基准的留出测试集上全部提升,最大的是 AppWorld 提高 15.4 个百分点、BrowseComp+ 提高 13.9、LiveCodeBench 提高 13.7。其中 SWE-bench Verified 也有提升,但它的测试集只有 26 题,没过报告自己设的显著性门槛,作者如实写了出来。

05对 AI 圈、技术圈、商业的影响
一、对 AI 圈:提升能力的杠杆从模型转移到 harness
过去提升能力主要靠训更大的模型,现在出现了第二条路:模型不变,让外面那层"做事方法"自己进化。这意味着 harness 工程会成为一门独立的手艺。
更深一层的变化是,评测会变成最核心的资产:AI 能自己改进以后,往哪个方向改,完全由评测决定。谁定义了评测,谁就掌握了进化方向。
二、对应用圈:护城河在验收标准
以前做 Agent 应用,壁垒是提示词和工作流。这些东西以后 AI 能自己调、自己优化,壁垒会变薄。
真正的壁垒会搬到三样东西上:
- ▪
行业里的验收标准,也就是"什么叫做对了" - ▪
长期记忆 - ▪
真实场景里的数据反馈
开发者的工作也会从"写流程"变成"写验收标准"。垂直行业的 know-how 反而更值钱了,因为只有懂行的人才定义得出"什么叫好"。
三、对商业:谁当包工头,谁拿分配权
当一个调度层能同时指挥 Claude Code、Codex、Kimi 干活的时候,底下的模型和 Agent 就变成了"分包商",可以随时替换。价值会往两头集中:一头是入口和调度,另一头是对结果负责的交付。
收费模式也会跟着变:从按席位、按 token 收钱,走向按结果收钱。企业买的不再是一个工具,而是一个能交付、可审计、改动前经过验证的 AI 员工。
06放到同一条线上看
"让 harness 自己变强"这条线上,之前写过 Proteus(让任意 harness 改写自身源码)和 NVIDIA 的 SoL-Pi(在能力不掉的前提下让 harness 更省)。Raven 多走了一步:它同时是调度 13 家外部 Agent 的包工头,又是给自带 Agent 做进化的那一层,两件事用同一套可替换的模块串起来。
两点提醒。一是 README 里说的"Curator"(持续改写 Agent 的那个角色)目前是实验性的,随源码仓库提供,不在安装包里;负责进化的 Evolver 也是一个单独的工具,把 Raven 当库来调用。二是项目还在 pre-alpha,装之前要有心理准备。
RSI 目前改的是 harness 而不是模型权重,离"AI 自己造出更强的 AI"还有距离,但方向已经很清楚,值得 AI 从业者认真看一眼。
项目地址GitHub:https://github.com/EverMind-AI/Raven官网:https://raven.evermind.ai技术报告:https://github.com/EverMind-AI/Raven/releases/download/tech-report-v1/technical-report.pdf文档:https://evermind-ai.github.io/Raven/

