Lightricks 把 LTX-2 系列推进到 2.5 版本,提供文本/图像/音频到视频与音频的统一生成,在 Hugging Face 上累计 3.67k likes、超过 150 万次下载,并把「会说话、有环境声、有配乐」的视频生成塞进了一个可从 ComfyUI 调用的开源权重里。
现有文本到视频扩散模型可以生成连贯画面,但通常缺少声音:人物对白、环境氛围、动作配乐这些由音频承载的语义与情绪线索被整体丢弃。补上音频,不仅是要「配一段 BGM」,而是要让声音与画面在角色、场景、风格、情绪上保持一致并时序同步。

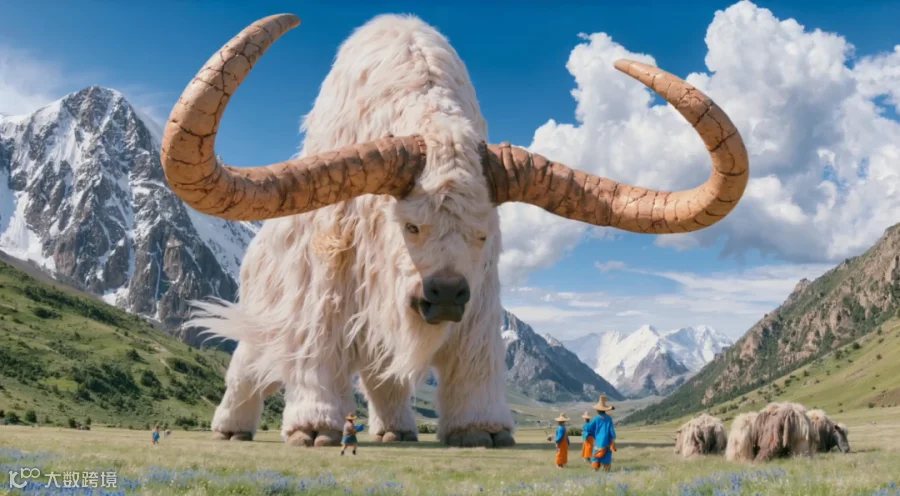
LTX-2.5是一款开放世界模型,采用开放权重,专为本地执行和微调而设计。它已应用于从文本、图像和视频输入生成同步的高保真视频和音频;其在机器人和物理人工智能等新兴领域的应用正在不断发展。
LTX-2.5 的新特性
-
原生多镜头生成——一次生成连接场景:多个镜头在剪辑中保持角色身份、环境、光照、声音和视觉风格(以前的版本生成单个连续镜头)。 -
扩散保真度渲染——我们的模型不会将每个场景锁定为一个压缩率,而是根据场景的复杂性和预算动态分配计算,在重要的地方渲染出完美的细节,在其他所有地方则保持高效。 -
新的扩散视频解码器——取代了 VAE 重建阶段;在要求苛刻的场景中,面部、纹理和屏幕文字更加清晰,运动效果更好,伪影更少。 -
自定义 Gemma 4 12B 文本编码器——将复杂的提示信息(多个字符、摄像机移动、光照、动作)放在一起,而不是在较长的序列中丢失细节。 -
提示增强器——以最小的额外计算量将简短的提示扩展为更丰富的电影式指令。 -
持续时间预测器(可选) — 一个可选节点,可根据提示预测剪辑的长度,并为您设置帧数,而不是依赖固定的持续时间参数。 -
大幅改进的精简模型——在更小、更快的检查点中保留了完整模型更多的视觉质量、快速的贴合性和运动一致性。
相关链接
-
论文:https://arxiv.org/abs/2601.03233 -
代码:https://github.com/Lightricks/LTX-2 -
主页:https://ltx.io -
权重:https://huggingface.co/Lightricks/LTX-2.5 -
试用:https://console.ltx.video/playground
内容介绍
LTX-2.5 定位为一个统一的音视频基础模型,而非单纯的视频生成器。它的输入面覆盖文本、图像、音频三种模态,输出面同时产生视频与同步音频——画面中的人物会开口说话,场景会带有符合环境的背景声与拟音(foley),整体情绪与风格跟随 prompt。
从工程落地看,LTX-2.5 提供了相对完整的开源使用链路:Hugging Face 权重、GitHub 推理代码、ComfyUI 节点,以及 distilled / DFR 两档推理管线。与多数只发布权重、需要自行拼装 pipeline 的项目不同,Lightricks 给出了从权重下载、VAE/upsampler 装配到具体推理命令的端到端示例,降低了复现门槛。
方法概述

1. 非对称双流 Transformer

模型主干由两条流构成:一条 14B 参数的视频流负责画面生成,一条 5B 参数的音频流负责声音生成,合计约 19B 参数。两流并非简单并联,而是通过双向音视频 cross-attention 相互交换信息,并引入 temporal positional embedding 保证时序对齐,再用跨模态 AdaLN 共享 timestep 条件。非对称容量分配的逻辑是「视频比音频需要更多建模容量」,从而在不显著增大音频流的前提下维持联合训练与联合推理的效率。
2. modality-CFG 与跨模态条件
为提升音视频之间的对齐与可控性,LTX-2 引入 modality-aware classifier-free guidance(modality-CFG)。与标准 CFG 只区分「有条件/无条件」不同,modality-CFG 按模态分别调节引导强度,使生成结果在「画面质量」「声音质量」「音视频一致性」之间可独立权衡。多语言文本编码器则负责把 prompt 映射到跨语言的语义空间,支撑 9 种语言的提示理解。
3. 两档推理管线:distilled 与 DFR
LTX-2.5 给出两套可切换的推理路径。distilled 管线面向速度,默认生成 121 帧,适合预览与迭代;DFR(Detail-Fidelity Refinement)管线面向保真度,在 base 生成之后接入一个 22B 的 IC-LoRA Pixel-Spatial-Upscaler(需单独下载 LTX-2.5-22b-IC-LoRA-Pixel-Spatial-Upscaler 权重,strength 固定 0.5),并可叠加 temporal 2x/4x 上采样,换取更细的纹理与更高的细节一致性。两档设计让同一权重既能跑通快速验证,也能产出可交付的高保真片段。
结论
LTX-2.5 把「画面+同步声音」的统一生成从闭源演示推进到了可本地部署的开源权重,双流 Transformer 与 modality-CFG 是其实用性的核心。对关注视频生成与音视频一致性的读者,它是一个值得跟进的基线。
把「会说话的视频」做成一个能本地跑的开源权重,是音视频生成从炫技走向工具的关键一步;真正决定它能否落地的,往往不是生成质量的上限,而是协议与算力门槛的下限。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~