


导读MiniMind-3 把约 6400 万参数语言模型的预训练和指令微调做成可运行的入门项目。官方给出的约 3 元,是在单张 3090、精简数据、两个阶段各跑 1 个 epoch 时估算的 GPU 租金;仓库脚本默认却是各跑 2 个 epoch。本文把这笔账、训练步骤和最终模型能力拆开,帮助想动手的读者判断要准备什么、能学到什么。
本文 1859 字,阅读约 5 分钟|3 元,具体算了哪两段训练 → 从随机权重到能对话 → 为什么直接运行默认命令,不等于花 3 元 → 跑完后得到什么,怎样判断值不值
3 元,具体算了哪两段训练
MiniMind-3 于 2026 年 4 月发布。它的主线模型约有 6400 万参数,项目把预训练、指令微调以及多种后训练方法的代码放在同一个仓库。时至今日,它仍适合回答一个实际问题:如果想从头走一遍语言模型训练,最低限度需要做哪些事?
先看最容易被记住的“3 元”。官方 README 给出一组经验估算:租用单张 NVIDIA 3090,按约 1.3 元/小时计价,使用精简数据,两段训练各跑 1 个 epoch。epoch 指把当前训练集完整走过一遍。
预训练:约 1.21 小时,约 1.57 元。
指令微调(SFT):约 1.10 小时,约 1.43 元。
合起来是约 2.31 小时、约 3 元。两份精简数据分别约 1.2GB 和 1.6GB。这是一组特定训练条件下的 GPU 租金估算,不是下载、安装、调试和所有后训练阶段的总账单。租卡平台的价格、计费单位和运行环境一变,实际支出也会变。
这笔账可以再拆成两层:训练脚本消耗多少 GPU 时间,是项目给出的经验值;租卡平台怎样收费,是读者自己的订单条件。下载约 2.8GB 精简数据、安装依赖、等待环境就绪、训练失败后重跑,都可能占用时间或产生其他成本。若平台按整小时、最低消费或预付时长计费,最终付款也未必恰好等于计算所得的 3 元。
从随机权重到能对话:钱花在什么地方
“从零训练”里的“零”,首先指模型权重的起点。预训练脚本默认 from_weight=none,从随机初始化的权重出发,读取 pretrain_t2t_mini.jsonl。模型在文本里学习预测下一个 token,训练结束保存 pretrain_*.pth。这里的 token 是分词器切出的文本单位;预测它,是模型学习语言模式的训练目标。
从“预测下一个 token”开始,系统读懂 decoder-only
接着,SFT 脚本默认读取刚保存的 pretrain 权重,再用 sft_t2t_mini.jsonl 训练,保存 full_sft_*.pth。这批数据让模型接触用户与助手的对话格式、指令回答和部分工具调用样本。SFT 接在预训练权重之后,才构成这条最小路线;单独下载一份已训练模型来聊天,不算走过“从零训练”。
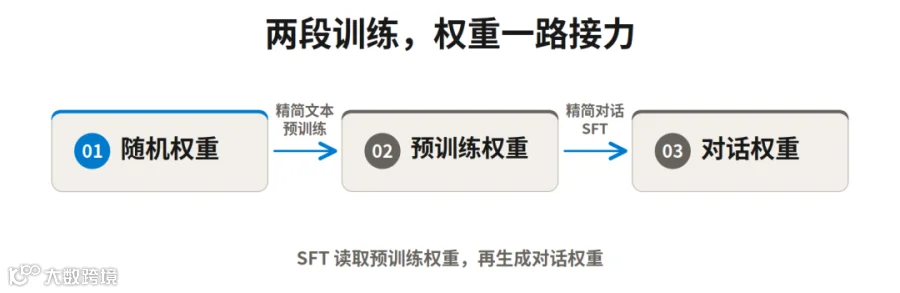
但“从零权重”也不等于从零准备所有东西。项目已经提供代码、分词器和整理好的数据;数据还包含公开语料与合成内容。读者省下了搭框架和大规模清洗数据的工作,换来的是能观察权重怎样从预训练走到对话微调。
这也解释了为什么项目会同时提供精简集和完整集。仓库列出的完整预训练集约 10GB、完整 SFT 集约 14GB,适合更充分的主线训练;约 3 元估算用的却是 1.2GB 与 1.6GB 两份精简集。换成完整集,数据量和训练时间的前提一起变了,不能沿用精简版账单,也不能把完整模型展示的效果直接算到精简 Zero 路线上。它适合学习训练链路,不能据此推断“个人用 3 元就能训练出可靠的通用助手”。
为什么直接运行默认命令,不等于花 3 元
关键差别在训练轮数。官方成本表写的是两段各 1 个 epoch,而当前 train_pretrain.py 和 train_full_sft.py 的 --epochs 默认值都为 2。仓库里的训练示意图也把精简版路线画成预训练 2 轮、SFT 2 轮。
 图片说明:看下方 MiniMind-Zero 路线,预训练与 SFT 均标为 2 epochs;上文约 3 元的官方分项表则按两段各 1 epoch 估算。图中的其他路线和时间不用于推算本文账单。图片来源:MiniMind 官方仓库,dataset.jpg
这意味着,只照 README 的无参数命令运行,不能预设账单仍是 3 元。若要对齐估算的轮数,在项目的 trainer/ 目录依次运行 python train_pretrain.py --epochs 1、python train_full_sft.py --epochs 1。即使轮数对齐,速度仍会随 GPU、批次大小、数据读取和环境而变;不能把两轮的用时机械翻倍,报成自己的实测账单。
官方 README 对“2 小时”还有一处口径冲突:开头将其解释为 SFT 单独跑 1 轮,分项表却列 SFT 约 1.10 小时、两段合计约 2.31 小时。本文用可逐项相加的分项表说明约 3 元估算,不把两种说法拼成一组精确实测结果。
仓库还提供 LoRA 微调、知识蒸馏和强化学习等后续实验,但约 3 元只估算精简预训练与 SFT。继续跑其他脚本,需要另算数据、时间与算力。SFT 数据虽已混入工具调用样本,也不能仅凭这一点断定精简 Zero 模型能可靠完成复杂工具任务。
跑完后得到什么,怎样判断值不值
这条最小路线的产物是一份预训练权重和一份 SFT 后的对话权重。你可以比较两阶段生成内容的变化,查看训练损失、数据格式与脚本如何连接。对刚开始读 Transformer 训练代码的人,能把“数据→训练目标→权重→对话输出”串起来,比单独记住项目名或参数量更有学习价值。
效果边界也要一起看。项目在 README 中展示了早期 Zero 权重的对话样例,同时提醒其事实知识与泛化能力有限。那是项目方提供的示例,不是本文独立测试,更不能保证换一道题、换一种语言或换个任务仍答得稳。精简数据、短时间训练得到一个会基本对话的模型,和训练出可靠生产助手,是两种不同目标。
如果准备自己跑,我会先做三项检查:确认能拿到匹配的精简数据与可用 GPU;确认两个阶段的 --epochs、数据路径和 SFT 所依赖的预训练权重;最后把实际租价、占卡时长与输出样例单独记下来。这样既能复现训练过程,也能知道自己的账单和效果与官方估算差在哪里。
具体看结果时,不妨固定几道相同的提示,分别加载预训练权重和 SFT 权重观察回答形式,再记录训练日志中的损失变化。损失下降表示模型更适应相应训练数据,不能直接证明事实问答、长推理或工具使用已经可靠。若目标是学习代码,就去找清楚数据如何变成 token、损失如何算、参数如何更新、权重如何被下一阶段读入;若目标是得到能上线的助手,还需要独立任务集、错误分析和部署成本评估。这些都超出了 3 元练习账单。
如果目标是拆开训练链路,精简数据和两段各跑 1 轮已经能提供观察点;如果目标是评估模型能否可靠使用,就要为更多训练和独立测试另立预算。约 3 元回答的是入门练习的算力门槛,不能替模型可用性报价。
参考资料
MiniMind 官方仓库与 README: https://github.com/jingyaogong/minimind
MiniMind 预训练脚本: https://github.com/jingyaogong/minimind/blob/master/trainer/train_pretrain.py
MiniMind 指令微调脚本: https://github.com/jingyaogong/minimind/blob/master/trainer/train_full_sft.py
蘑菇头表情图片来源:蚊子动漫
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!