

哈喽,大家好~
最近有同学提到:训练集准确率都到 99% 了,为什么上线后效果还是不行?
事实上 很多时候,不是模型学得不好,而是数据拆分出了问题。测试数据提前参与训练、类别比例失衡,都会让评估结果看起来很漂亮,实际却经不起检验~
这里,我们就来聊聊机器学习中的数据拆分。先把训练集、验证集和测试集的作用讲清楚,再用数据训练一个随机森林模型,并通过两组分析图观察拆分效果和模型表现~
数据为什么要拆分
机器学习模型本质上是在学习一个映射关系:
其中, 是输入特征, 是模型预测结果, 是模型从数据中学到的参数。
如果模型训练完后,仍然用训练数据评估,就像让学生拿做过的原题参加考试。分数很高,却不能说明他遇到新题时也会做。
因此,我们通常把数据分成三部分:
-
训练集:用于学习模型参数。 -
验证集:用于选择参数、模型和分类阈值。 -
测试集:只在最后使用一次,评估模型面对新数据的能力。
常见比例是 60%/20%/20% 或 70%/15%/15%。没有固定答案,数据量越大,测试集占比通常可以越小。
数据拆分
数据拆分真正想模拟的是:模型在未来遇到未见数据时,会表现得怎么样。
假设总样本量为 ,按照 60%/20%/20% 拆分,那么:
对于分类问题,我们还要关注类别比例。比如原始数据中正样本占 30%,拆分后最好让三个集合中的正样本比例都接近 30%。
这就是分层抽样,在 train_test_split() 中通过 stratify=y 实现。通俗来说,就是拆数据时别把某一类样本都分到同一个集合里。
还有一个关键点:标准化、特征选择、PCA 等操作只能在训练集上拟合,然后应用到验证集和测试集。否则模型就提前看到了测试数据的信息,这叫数据泄漏。
完整案例
下面生成一个带噪声、类别不完全平衡的数据集,并按照 60%/20%/20% 分层拆分。
模型使用随机森林,它通过多棵决策树投票完成分类,对非线性数据比较友好。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.decomposition import PCA
from sklearn.metrics import (
    roc_curve, precision_recall_curve,
    roc_auc_score, average_precision_score
)

# 1. 数据
X, y = make_classification(
    n_samples=3000, n_features=12, n_informative=8,
    n_redundant=2, weights=[0.65, 0.35],
    class_sep=1.15, flip_y=0.04, random_state=42
)

# 2. 先拆出40%,再平分为验证集和测试集
X_train, X_temp, y_train, y_temp = train_test_split(
    X, y, test_size=0.4, stratify=y, random_state=42
)
X_val, X_test, y_val, y_test = train_test_split(
    X_temp, y_temp, test_size=0.5,
    stratify=y_temp, random_state=42
)

print("样本量:", len(y_train), len(y_val), len(y_test))
print("正样本比例:",
      y_train.mean(), y_val.mean(), y_test.mean())

# 3. 训练随机森林
model = RandomForestClassifier(
    n_estimators=300, max_depth=10,
    class_weight="balanced", random_state=42
)
model.fit(X_train, y_train)

# 4. PCA只在训练集上拟合,用于二维可视化
pca = PCA(n_components=2)
Z_train = pca.fit_transform(X_train)
Z_val = pca.transform(X_val)
Z_test = pca.transform(X_test)

# 图1:拆分后的PCA空间
plt.style.use("dark_background")
plt.figure(figsize=(10, 7))

sets = [
    ("Train", Z_train, y_train, "o"),
    ("Validation", Z_val, y_val, "^"),
    ("Test", Z_test, y_test, "s")
]
colors = {0: "#00E5FF", 1: "#FF2D95"}

for name, Z, target, marker in sets:
    for cls in [0, 1]:
        mask = target == cls
        plt.scatter(
            Z[mask, 0], Z[mask, 1],
            c=colors[cls], marker=marker,
            s=25, alpha=0.55,
            label=f"{name} - Class {cls}"
        )

plt.title("PCA View of Train / Validation / Test")
plt.xlabel("Principal Component 1")
plt.ylabel("Principal Component 2")
plt.legend(ncol=2, fontsize=8)
plt.tight_layout()
plt.show()

# 5. 对比三个数据集的ROC与PR曲线
datasets = [
    ("Train", X_train, y_train, "#00E5FF"),
    ("Validation", X_val, y_val, "#FF2D95"),
    ("Test", X_test, y_test, "#FFD600")
]

fig, axes = plt.subplots(1, 2, figsize=(13, 5))

for name, X_part, y_part, color in datasets:
    prob = model.predict_proba(X_part)[:, 1]

    fpr, tpr, _ = roc_curve(y_part, prob)
    precision, recall, _ = precision_recall_curve(y_part, prob)

    auc_score = roc_auc_score(y_part, prob)
    ap_score = average_precision_score(y_part, prob)

    axes[0].plot(fpr, tpr, color=color, linewidth=2,
                 label=f"{name}: AUC={auc_score:.3f}")
    axes[1].plot(recall, precision, color=color, linewidth=2,
                 label=f"{name}: AP={ap_score:.3f}")

axes[0].plot([0, 1], [0, 1], "--", color="white", alpha=0.5)
axes[0].set(title="ROC Curve Comparison",
            xlabel="False Positive Rate",
            ylabel="True Positive Rate")

axes[1].set(title="Precision-Recall Comparison",
            xlabel="Recall", ylabel="Precision")

for ax in axes:
    ax.grid(alpha=0.2)
    ax.legend()

plt.tight_layout()
plt.show()

第一张图把 12 维特征压缩到二维空间。
颜色表示类别,形状表示训练集、验证集和测试集。
我们重点不是看类别能不能完全分开,而是观察三个集合是否覆盖了相似的数据区域。如果测试集集中在一个完全不同的位置,随机拆分就未必合理,需要检查数据来源或采样方式。
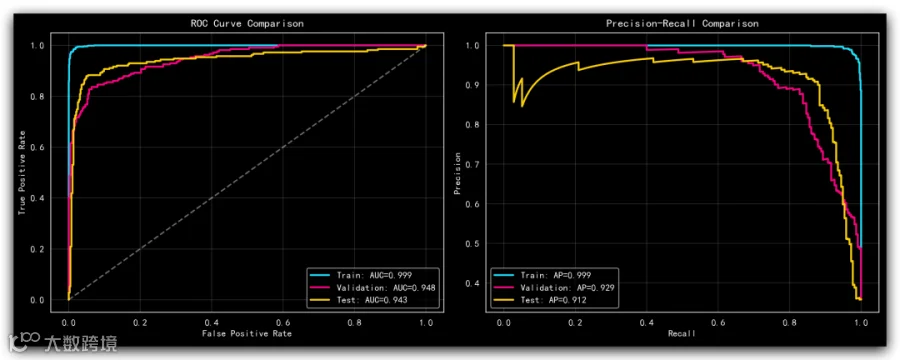
第二张图同时比较 ROC 和 PR 曲线。
ROC-AUC 衡量模型区分正负样本的能力,PR 曲线更关注正样本识别,在类别不平衡时更有参考价值。
如果训练曲线远高于验证和测试曲线,通常说明模型过拟合。验证集和测试集表现接近,则说明当前评估结果相对稳定。一句话概括,三个集合不是分完就结束,还要检查它们是否“来自同一个世界”。
注意点
普通随机拆分适合相互独立的样本,但不是所有场景都能直接使用。
时间序列必须按时间先后拆分,不能拿未来数据训练过去;同一个用户、患者或设备产生的多条记录,应按组拆分,避免同一主体同时出现在训练集和测试集;所有预处理步骤也应只在训练集上拟合。
验证集可以反复用于调参,但测试集不要跟着反复看。否则调着调着,测试集也会变成另一种验证集。
最后
数据拆分不是简单地切三刀,而是在模拟模型未来面对新数据的场景。训练集负责学习,验证集负责选择,测试集负责最后验收,同时还要防止类别失衡和数据泄漏。
接下来大家可以尝试把随机森林换成 XGBoost,对比不同模型的验证曲线;也可以进一步学习时间序列拆分和分组拆分,让评估方式真正贴近业务上线环境~