

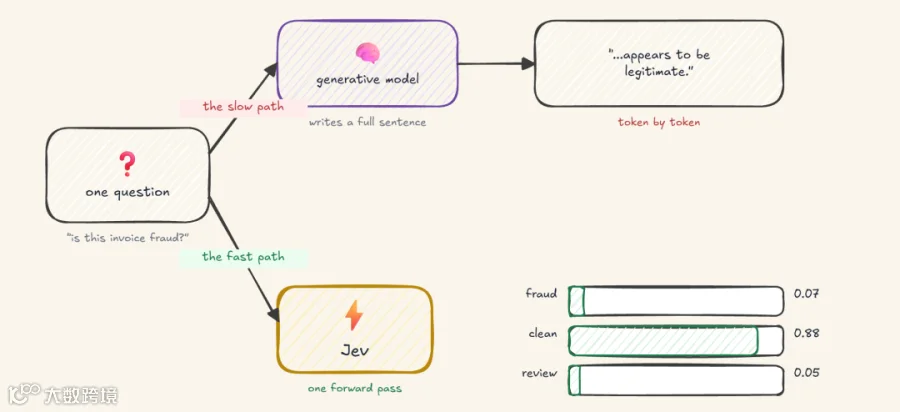
假设我有一个应用,需要判断一张发票看起来是否像欺诈。我可以把发票和供应商历史交给一个语言模型,问它怎么看。
它可能会回复类似 “Based on the line items and vendor history, this invoice appears to be legitimate,” 这样的话,一个 token 接一个 token 地生成。然后我的代码必须读它、猜它是什么意思,并祈祷措辞永远不会破坏我的 parser。
或者,我可以让另一种模型只对我关心的三个结果打分:fraud、clean、review,并在一次 pass 中拿回三个数字。没有需要解析的句子,只有 fraud 0.07、clean 0.88、review 0.05。
下面这张图展示了整个思路:在一个真实 ticket 上完整走一遍,最后落到实际运行的那一行代码。

只放大这张图的第一步,也就是“写出一个答案”和“给一个答案打分”之间的选择,看起来是这样。
第二种模型就是 Jev,这是 TypeSafe AI 今年发布的一个决策引擎。它不能对话,不能写段落,也不能生成一行代码。
TypeSafe 称它为 “System One model”,也就是快速、本能式的思考,而不是缓慢、审慎式的思考。它回答的是我们的代码不断需要的那些小型、即时判断,绝不回答任何需要深入思考的问题。
我想理解它是如何工作的,而不是照单全收发布公告里的说法。所以我们会自己构建同样的技巧,看看让模型跳过文本生成的机制,并检查公开数字在哪些地方站得住脚。
我们一直在为之支付全价的问题
软件从语言模型那里需要的大多数东西不是一段话,而是一个判断。这个 support ticket 是否紧急?哪个模型应该处理这个请求?这个 shell 命令危险吗?这段文字是否回答了问题?这些都不需要 prose,只需要从少数几个已知答案里选一个。
问题在于,无论问题是什么,我们都习惯拿同一个工具来处理:把它发给一个完整的 generative model,等待一个句子或 JSON object,然后再把它解析回我们一开始就想要的 label。把这放进 agent loop 里,成本会迅速叠加,因为 agent 会不断调用模型来做这种小决策。
    while not task_done:
    action = llm(context)          # full generation, just to pick a tool
    result = run_tool(action)
    context += result
    task_done = llm(context)       # full generation again, just to check "done or not"
这些调用中的每一次都在为 generative model 付费,一个 token 接一个 token,即使答案本质上只有几个 bit。

两者之间的差距,归根结底就是模型必须运行多少次的字面计数。
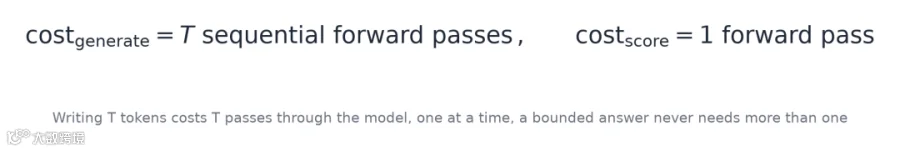

generate 分支中的每一次 pass 都依赖上一次 pass 刚写出的 token,所以它们只能一个接一个运行。score 分支没有任何东西需要等待。
Jev 的赌注是:当代码已经知道所有可能答案时,语言生成就是错误的接口。如果我能提前枚举结果,我需要的是一个打分的模型,而不是一个写作的模型。
Jev 是什么
对 Jev 最简短且准确的描述是:一个 semantic decision engine。我向它发送 state,也就是当前情况,以及一个或多个关于该 state 的 questions。它返回一个带 probability 的 typed answer,而不是一个句子。
这就是本文开头那张图。State 和 questions 进去,每个 question 在同一次 pass 中被评估,返回的 probability 是我自己的代码用于分支判断的依据,而不是模型来做分支。
每个 question 都会预先声明它的答案形状。Jev 支持这三种 primitive。
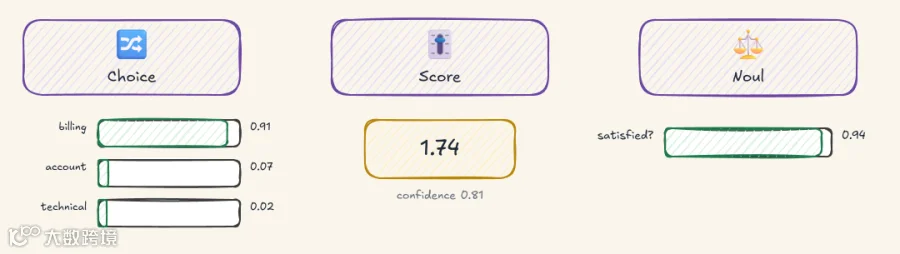
Choice 从我定义的列表中选出一个选项,并返回每个选项的 probability,而不仅仅是 winner。Score 将输入放到我定义的有序尺度上,所以我会拿到类似 missed-to-resolved 尺度上的 1.74。Noul 通过返回某事为真的 probability 来回答 yes/no 问题,这是 TypeSafe 给这种 boolean-flavored primitive 起的名字。
比名字更重要的是,每个答案都会以 0 到 1 之间的数字返回,我的代码可以直接据此行动。
这个 1.74 值得再看一眼,它不是 rounding artifact。Score 计算的是尺度上每一级的 probability-weighted average,而不只是 top pick。
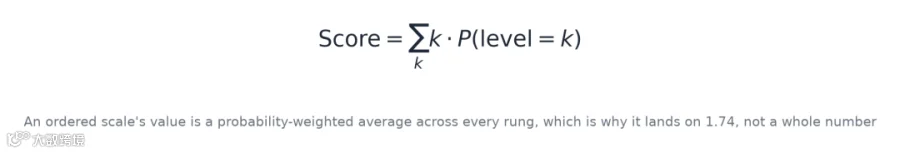
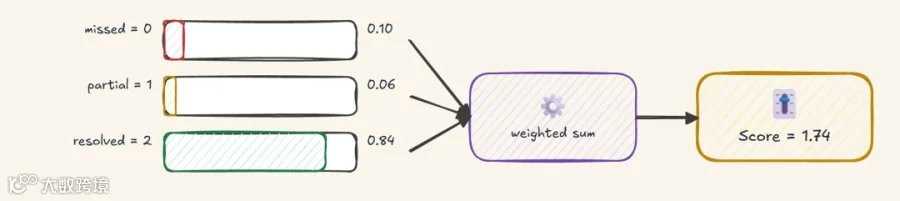
如果模型确定这个 ticket 已经 resolved,score 会接近 2.0。它落在 1.74,说明它强烈倾向于 resolved,但仍然给 partial 保留了真实权重,而这些信息是单个 label 会丢掉的。
下面是一个 request 的样子,使用的是我会在本文剩余部分一直沿用的 support ticket。
    {
  "model": "jev-latest",
  "state": "I was charged twice for the same subscription.",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "Does this need attention right now?"
    },
    "team": {
      "type": "choice",
      "instructions": "Which team should own this ticket?",
      "criteria": {
        "billing": "Charges, invoices, refunds",
        "technical": "Product bugs and errors",
        "account": "Login and access problems"
      }
    }
  }
}
每个 question 都在同一次 pass 中被评估。response 完全不包含 prose,只有 labels 和它们背后的 numbers。
    {
  "urgent": {"probability": 0.61},
  "team": {
    "choice": "billing",
    "probabilities": {"billing": 0.91, "technical": 0.06, "account": 0.03}
  }
}
下面是对这个确切 ticket 的端到端追踪:一次 forward pass 同时变成两个可直接用于分支的数字。

我的代码会直接读取这个 response。模型没有机会发明第四个 team,team 永远只能是我给它的三个名字之一。
这不同于要求模型给出 structured output。structured-output 调用仍然是一次一个 token 地 decode,schema 只是约束这些 token 所形成的 shape。Jev 的 scoring path 从不进入这个 decode loop,它从一次 forward pass 中直接读取答案。
如果沿着同样五个检查点排列:output、sampling、best fit、control、failure mode,这两种方法从第一行开始就分道扬镳,并且再也不会汇合。

Structured output 和 fixed-answer scoring 的分裂方式也是一样的。前者在 schema 之下仍然运行完整的 autoregressive loop,后者在这个 loop 开始之前就退出。

Probability 从哪里来
要理解为什么 Jev 可以跳过 decode loop,回忆一下普通 generation step 做了什么会很有帮助。tokenizer 会把我的 prompt 转成 token IDs,模型为下一个位置产生一个 vector,其中包含词表中每个 token 的一个 score,也就是 logit,数量可能是数万个。
把 logit 转成 probability,意味着要针对整个词表中的所有其他 logit 运行 softmax。

那里的 V 是整个 vocabulary。普通 generation 甚至不会运行这个朴素版本,它会先把每个 logit 除以 temperature,从而在选择 token 之前让分布变得更尖锐或更平坦。
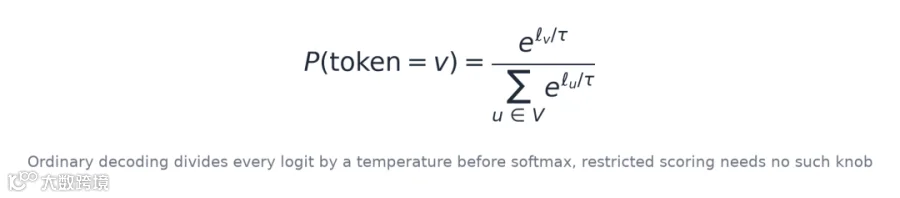
这个旋钮存在,是因为 generation 必须决定在 open-ended answer 中注入多少随机性。Restricted scoring 从不问这个问题,所以它只报告 raw logits 已经暗示的比例。
整个循环:forward pass、decoding rules、追加一个 token,会一直重复,直到 stop token 或长度限制结束它。
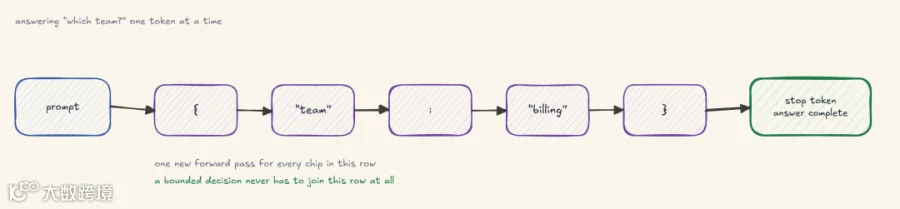
但如果我只关心一个有界决策,我只需要第一个 vector,并且只需要其中三个 entries。
假设我在 prompt 中把三个答案标记为 A、B, C,并且在模型通常会开始写 label 的位置结束 prompt。模型仍然会为这个位置产生它通常的 vector,其中包含 A、B、C` 以及所有其他 token 的 logits。
我忽略其他所有项,只保留我关心的这三个,并且只对这三个应用 softmax。
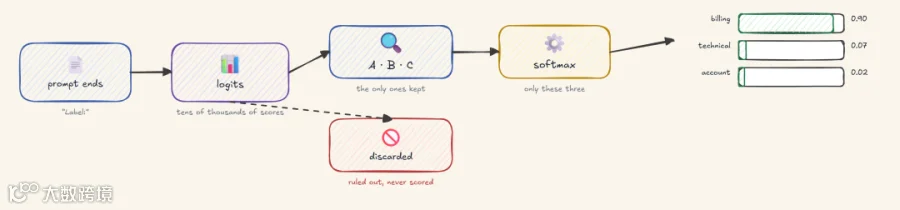
公式本身几乎没有变化,变的只是分母。

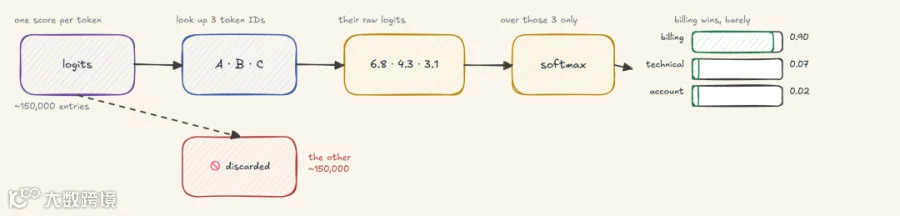
假设这三个 logits 是 A = 6.8、B = 4.3、C = 3.1,运行这个 restricted softmax 大致会得到 billing 0.90、technical 0.07, account 0.02`。
我问的不是 billing 在整个词表中有 90% probability。我问的是,在我的代码允许的确切三个选项之间,模型如何分配它的偏好,把对 150,000 项求和换成对 3 项求和。
逐一走过同样的五个检查点,会更容易看清楚词表的其余部分到底在哪里被丢掉。
labels 使用单个字母而不是完整单词,是有真实原因的。一个单词不一定是一个 token,billing 对一个 tokenizer 可能是一个 token,对另一个可能是多个 token,而 technical support will definitely span more than one position.
单字母 label 无论我关心哪些词,都位于恰好一个输出位置;真正的含义仍然位于 prompt 中每个字母旁边。

还有一个值得先了解的小陷阱。Tokenizers 经常会把前导空格折叠进一个 token,所以 A 和 A 可能映射到两个完全不同的 token IDs,而 chat template 可能会在我没注意到的情况下插入这个 whitespace。
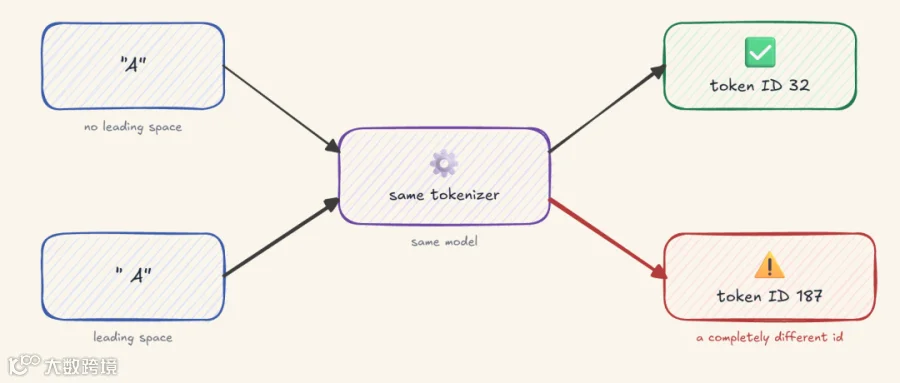
修复方法是通过模型自己的 chat template 渲染整个 prompt,检查它期望的确切 continuation,并在信任针对这些 labels 的 scoring call 之前,验证每个 label 确实是一个 token。
还有一件事值得从第一天就内置进去。如果我交给模型的 choices 并不穷尽,restricted softmax 仍然会把所有 probability mass 强行放到最接近的那个已声明答案上,即使没有一个是对的。
一个 security incident 如果落到一个只知道 billing、technical、account 的 router 上,仍然会被自信地归入这三者之一,所以添加一个 OTHER 或 ESCALATE 选项是一种便宜的保险。
让我们自己构建同样的技巧
光读机制只能让我走到这里,所以我们来运行它。Jev 本身是 closed 的,但这个确切的 scoring trick 已经存在于开源 serving stacks 中,所以我可以在一个完全由我控制的模型上复现它。我会使用 SGLang 作为 server,使用 Qwen2.5–0.5B-Instruct 作为 model,并且一点点构建 client。

启动模型服务器
首先,创建一个干净环境并安装我需要的两个 packages。
    python3 -m venv .venv
source .venv/bin/activate
pip install "sglang[all]==0.5.10.post1" "requests==2.34.2"
然后启动模型服务器本身,这是唯一执行 GPU 工作的进程,下面的 client script 只是通过 HTTP 与它通信。
    python -m sglang.launch_server \
    --model-path Qwen/Qwen2.5-0.5B-Instruct \
    --host 127.0.0.1 \
    --port 30000
第一次启动会从 Hugging Face 下载模型,然后它会保留在内存中,在端口 30000 上服务后续每个 request。
定义 Choices 并构建 Prompt
现在是 client,decide.py,一次构建一个 block。首先是 labels 和我要 routing 的 ticket。
    # decide.py
import json
import requests

BASE_URL = "http://127.0.0.1:30000"
MODEL = "Qwen/Qwen2.5-0.5B-Instruct"

# A is the token I actually score, "billing and payments" is what my
# application does with the answer once it comes back
choices = {
    "A": "billing and payments",
    "B": "technical support",
    "C": "account access",
}
ticket = "I was charged twice for the same subscription."
dictionary order 必须在 tokenizing、scoring,以及将结果映射回去的整个过程中保持不变,所以我直接从它构建 prompt,而不是把 labels 手动输入两遍。
    # decide.py (continued)
choice_lines = "\n".join(
    f"{label} = {meaning}" for label, meaning in choices.items()
)
prompt = f"""Ticket:
{ticket}
Question:
Which category matches the ticket?
Allowed labels:
{choice_lines}
Return only the label.
Label:
"""
print(prompt)
    #### OUTPUT ####
Ticket:
I was charged twice for the same subscription.
Question:
Which category matches the ticket?
Allowed labels:
A = billing and payments
B = technical support
C = account access
Return only the label.
Label:
prompt 正好在 Label: 处结束,这就是我即将读取的 vocabulary vector 所在的确切位置。我从不要求 SGLang 生成通常会跟在它后面的 token。
解析 Label Token IDs
在我能给任何东西打分之前,我需要知道 A、B、C 各自背后的真实 token ID,也就是这个 tokenizer 眼中的 ID,而不是从其他模型的 tokenizer 中假设出来的。
    # decide.py (continued)
label_token_ids = []

for label in choices:
    response = requests.post(
        f"{BASE_URL}/tokenize",
        json={
            "model": MODEL,
            "prompt": label,
            "add_special_tokens": False,
        },
        timeout=30,
    )
    response.raise_for_status()
    token_ids = response.json()["tokens"]
    if len(token_ids) != 1:
        raise ValueError(f"{label!r} is not a single token: {token_ids}")
    print(f"{label!r} -> {token_ids}")
    label_token_ids.append(token_ids[0])
    #### OUTPUT ####
'A' -> [32]
'B' -> [33]
'C' -> [34]
每个 label 都返回一个单独的整数,因此每个选项恰好占据一个 vocabulary position。如果任何 label 返回两个或更多 IDs,上面的 raise ValueError 会立刻把我拦住。
给这三个位置打分
确认 token IDs 之后,decision 本身就是一次 HTTP call。
    # decide.py (continued)
response = requests.post(
    f"{BASE_URL}/v1/score",
    json={
        "model": MODEL,
        "query": prompt,
        "items": [""],
        "label_token_ids": label_token_ids,
        "apply_softmax": True,
    },
    timeout=120,
)

response.raise_for_status()
score_response = response.json()

print(json.dumps(score_response, indent=2))

scores = score_response["scores"][0]
query 承载整个 prompt。items 中的空字符串告诉 SGLang 给其后的位置打分,label_token_ids 指定要读取的三个位置,apply_softmax 将这些读数归一化为一个 proper probability distribution。
    #### OUTPUT ####
{
  "scores": [
    [
      0.67776233,
      0.310878605,
      0.011359035
    ]
  ]
}
SGLang 对 prompt 做了 tokenize,运行 Qwen 一次,然后按我传入 token IDs 的相同顺序返回三个数字。没有生成任何 token 来产生这个结果。
这次调用背后的 raw logits,在 apply_softmax 归一化之前,分别是 A、B、C 的 25.2776、24.4982 和 21.1888。把这些值手工代入机制部分的 restricted softmax,会落在 SGLang 刚刚打印出的同一个 0.678 上。

这个计算就是前面的同一个公式,只是运行在三个数字上,而不是数万个数字上。
将 Scores 映射回 Decision
最后一步是普通 Python,把三个 floats 转回我的应用理解的 labels。
    # decide.py (continued)
probabilities = {
    choices[label]: float(score)
    for label, score in zip(choices, scores, strict=True)
}

decision = max(probabilities, key=probabilities.get)

print(json.dumps({"decision": decision, "probabilities": probabilities}, indent=2))
    #### OUTPUT ####
{
  "decision": "billing and payments",
  "probabilities": {
    "billing and payments": 0.6777623295783997,
    "technical support": 0.31087860465049744,
    "account access": 0.011359035037457943
  }
}
把这三个 floats 并排画成 bars,会比 raw JSON 更明显地展示差距。
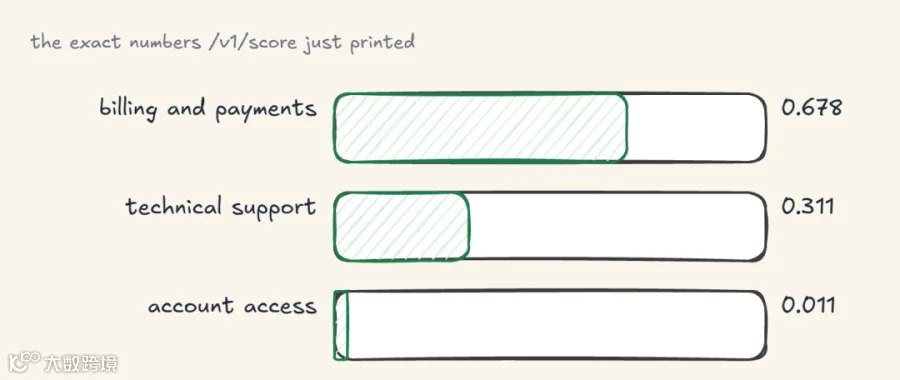
Billing 赢了,但只有 0.678,远不接近我可能期望的 0.99 以上,这正是 0.70 阈值应该捕获并送去二次检查、而不是盲目自动化的那类情况。
值得衡量一下,与以正常方式生成答案相比,这到底带来了什么。我在同一个 SGLang server、同一个 model、同样 100 个 support-ticket cases 上,对 Jev-style scoring path 和标准 chat-completion path 做了对比,并让它们在同一时刻开始。
在 scoring 完成全部 100 个 cases 的时刻,标准 generation,也就是每个答案最多 decode 32 个 tokens,完成了 54 个。平均下来,scoring 每个 case 花费 463 milliseconds,generation 花费 848 milliseconds,在相同硬件、相同 requests、相同时间下,实测差距为 1.83x。
答案旁边的数字为什么比答案更重要
typed answer 只解决了一半问题。label billing 告诉我谁赢了,probability 告诉我比赛有多接近,而第二个数字才是我的代码应该据以分支的东西。
    {
  "choice": "billing",
  "probabilities": {"billing": 0.52, "technical": 0.46, "account": 0.02},
  "confidence": 0.06
}
自动 routing 这个 ticket 会很鲁莽,billing 赢了但只赢一点点,而低置信度的获胜绝不应该走和压倒性胜利相同的分支。一个简单的数学定义 confidence 的方式,是 top answer 与最接近 rival 之间的 margin,而不是获胜 probability 本身。

billing 0.52 对 technical 0.46,margin 只有 0.06,几乎是抛硬币。0.52 的 winner 和 0.91 的 winner 绝不应该走相同分支,即使它们从技术上说都“赢了”。
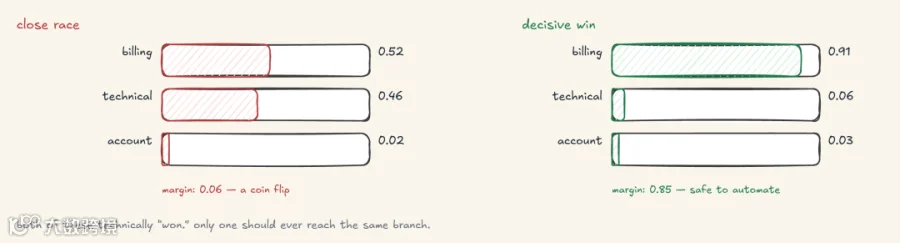

    if probabilities["billing"] > 0.9:
    route_automatically(ticket, team="billing")
elif confidence < 0.3:
    send_to_human_review(ticket)
else:
    escalate_to_larger_model(ticket)
简化之后,整个 if/elif block 就是一个带有两个可调旋钮的小规则。
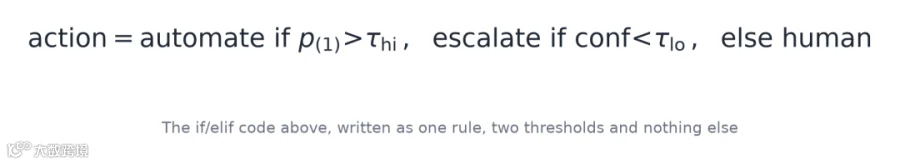
thresholds 位于代码中,可以被 review、test 和 change,而不是埋在模型 weights 里。dashboard label 也许可以容忍不稳定的 prediction,但删除客户数据的命令就应该要求高得多的门槛。
TypeSafe 用它称为 Reinforcement Learning for Calibrated Decisions 的方法训练 Jev,简称 RLCD。目标是 calibration,而不只是 accuracy:一批都带有 90% confidence 的答案,最终应该大约有 90% 是正确的。将每个 prediction 按它声明的 confidence 分 bin,然后比较每个 bin 的 average confidence 与该 bin 实际正确的频率。
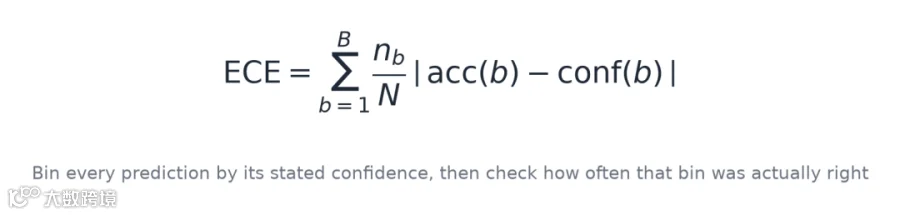
一个模型可以平均而言很准确,同时仍然是 miscalibrated,在我原本最信任的区间里自信地犯错。不能跟踪真实 correctness 的 confidence 只是装饰,不是我可以设置阈值的 signal,而检查它需要我自己的 labeled evaluation set。
关于 Hallucination 的说法,更谨慎地讲
TypeSafe 说 Jev 不能 hallucinate。这是真的,但只在一个狭窄定义下成立。
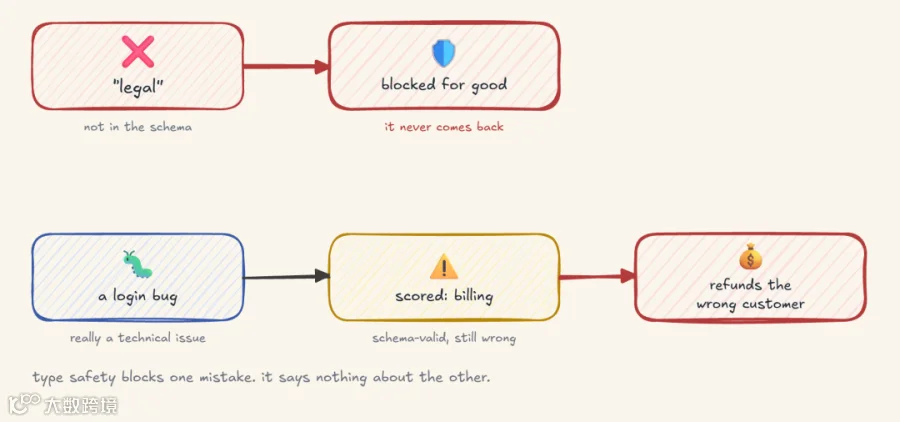
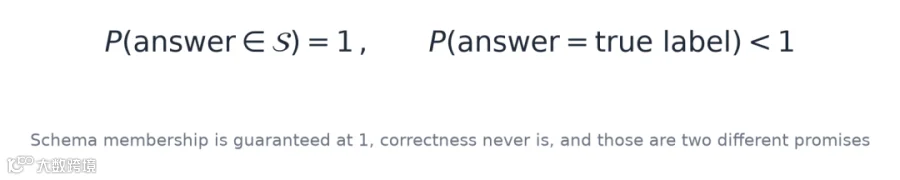
如果我把 billing, technical, account声明为唯一有效答案,Jev 的 response 永远不会返回legal`,这个选项在 schema 中根本不存在。它也不能给我 malformed prose。hallucination 问题的这一部分确实消失了。
但 Jev 仍然可能自信地选择错误的有效选项。一个 login bug 被打分为 billing instead of technical` 是 schema-valid 的,仍然是错的,而现在有人会因为一个从来不关于 charge 的问题给错误的客户退款。schema 只排除了不存在的答案,并不说明存在的答案是否正确。
比“Jev cannot hallucinate”更谨慎的一句话是:它不能破坏自己声明的 output schema,但它仍然可能是错的。Type safety 和正确判断是两种不同的保证,只有前者是免费获得的。
Jev 在 Agent 内部哪里最有价值
Jev 最适合与 generative model 搭配使用,而不是替代它。generative model 负责 planning、writing、explaining 和 calling tools,这些是真正需要语言的工作。Jev 处理围绕这些工作的高频小决策。
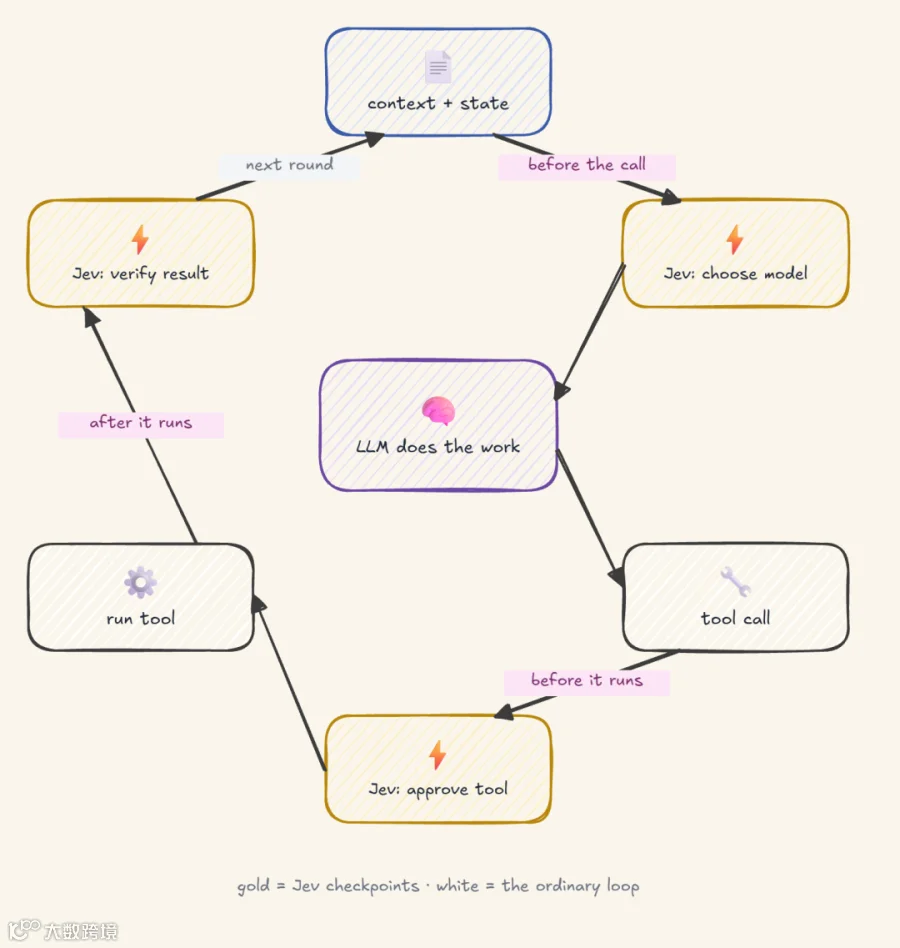
Model routing. 一个简单 lookup 不需要和困难的 architecture review 使用同一个模型。Jev 对 incoming request 打分,并选择可能完成任务的最低成本模型;router 决定哪个模型应该回答,而不是决定答案本身。
Tool risk gating. 在 agent 运行 shell command 之前,Jev 可以把它分类为 read-only、reversible 或 destructive,同时判断它是否触及 production 或离开 sandbox。高 confidence 的 read-only command 继续运行,destructive 或 uncertain 的命令暂停等待人工。

Verification. agent 可能声称任务已经完成,而它的 tests 仍然失败。Jev 检查 state 并回答有界问题:tests 是否通过,agent 是否在重复同一个失败动作,output 是否遵守 policy。硬性 test 仍然捕获它被设计来捕获的东西,Jev 则为硬规则无法覆盖的内容增加一个 semantic check。
Jev 今天能解决的问题
Jev 真正有帮助的 workloads 共享三个属性:我能提前说出每个可能答案;一个谨慎的人可以手工快速判断输入;这个 decision 发生得足够频繁,以至于 latency 或 cost 开始变得重要。
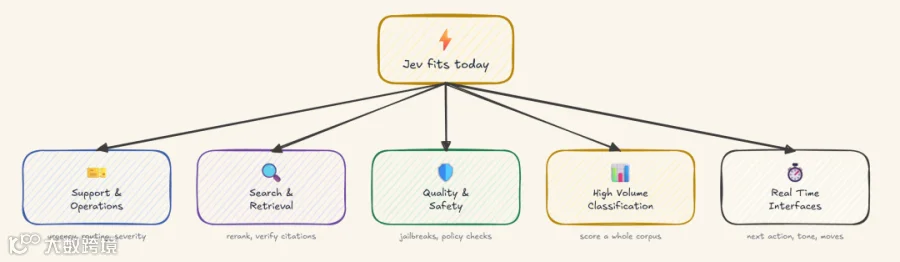
Support and operations. 一次 pass 中分类 intent、urgency、department、spam 和 frustration。通过多个小检查 routing refunds,而不是一个巨大的 prompt。在人工阅读之前按 severity 排序 incidents。
Search and retrieval. 根据 passage 是否回答 query 来 rerank,而不仅仅是 semantic closeness。检查 citation 是否真正支持 claim。在 irrelevant chunks 到达 expensive model 之前过滤它们。
Quality and safety. 筛查 prompts 中的 jailbreak attempts 或 injection。根据 written policy 检查 generated content。在 risky code change 或 tool call 执行前 flag 它,放在 deterministic checks 旁边,而不是替代它们。
High volume classification. 以以前根本负担不起的规模标注 documents 或 customer messages。把 free text 转成 traditional ML model 的 features。用同一套 rubric 给 corpus 的每一行打分。
Real time interfaces. 从一组已知 page elements 中选择下一个 browser action。在用户仍在 typing 时给 tone 打分。Jev 今天是 text-only,所以这些都需要先把 environment 转成 text。
这些是否站得住脚
TypeSafe 自己的数字值得怀疑,公司 benchmark 自己的产品时会选择对自己有利的比较。它报告的 latency 为 70 到 500 milliseconds,价格为每 million input tokens $0.042 且 output 免费,并声称比可比 workflows 大约快 200 倍、便宜 400 倍。
把这当成 ceiling,而不是 promise;机制是真实的,就像我上面实测的一样,但 marketing multiples 有意处在有利端。
我想要的是由某个不依赖 Jev 好看而获益的人来做的比较。LangChain 正好做了这种测试:用他们自己的 Deep Agents harness 和 LangSmith 数据集,将 Jev 与三个 LLM judges 对比:GPT-5.6 Luna、GPT-5.6 Terra 和 Claude Sonnet 4.6。
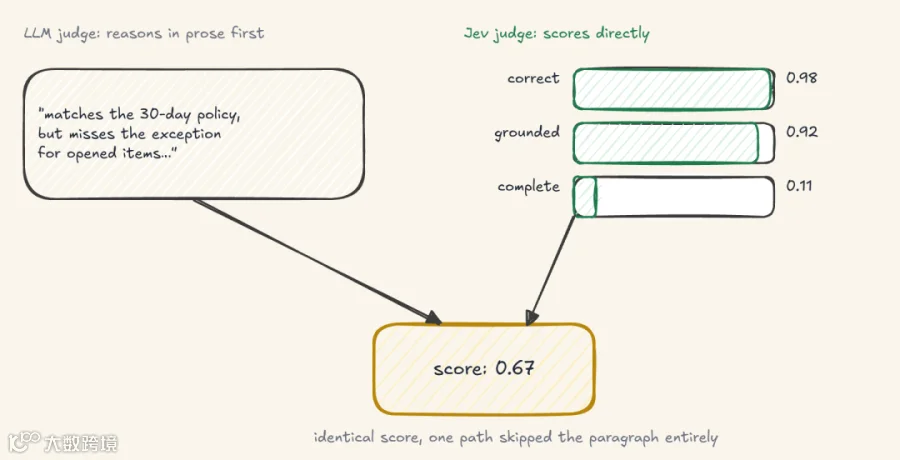
在数字之前,一个例子能更生动地展示机制差异。面对同一个 refund-policy 问题,LLM judge 会先推理出一段文字,然后再给出 0.67 的 score。
The answer gives a 30-day window, which matches policy, but leaves out the
A Jev-style judge skips that paragraph entirely and returns three calibrated probabilities directly, correct 0.98, grounded 0.92, complete 0.11, which combine to the exact same 0.67.
exception for opened items, so it is accurate but not complete.
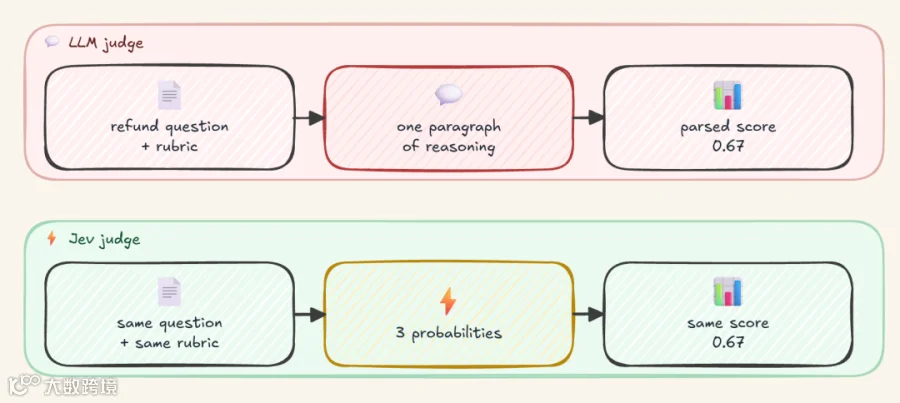
如果画成 bars 而不是 icons,同样的收敛会更清楚:一条路径先写一段话,另一条路径完全不写,两者都到达 0.67。
在与 human oracle 对比的 500 次重复 pass/fail judgments 中,Jev 与人类匹配了 100.0 percent,GPT-5.6 Terra 为 99.8 percent,GPT-5.6 Luna 为 96.4 percent,Claude Sonnet 4.6 为 80.0 percent。

accuracy 只讲了一半故事,一个 judge 可以平均是对的,但在同一个输入上每次运行却剧烈摆动。对一个 frozen case 重复 100 次测量 variance,真正的差距就打开了。
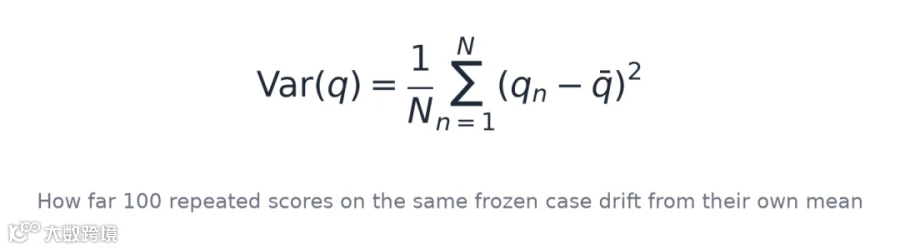
Jev 的 mean variance 为 0.0000149。Claude Sonnet 4.6 高出 92 times,GPT-5.6 Luna 高出 433 times,GPT-5.6 Terra 高出 913 times。仅仅更低的 variance 并不能证明 judge 是对的,它可能始终如一地错,但一旦 judge 是准确的,低 variance 才能让这种 accuracy 成为可以在其上构建 automation 的东西。
cost 和 latency 遵循同样的模式。Jev 平均每次 call 为 $0.00035 和 0.44 seconds,相比之下,GPT-5.6 Luna 是 $0.00039 和 2.50 seconds,GPT-5.6 Terra 是 $0.00289 和 2.83 seconds,Claude Sonnet 4.6 是 $0.02811 和 2.16 seconds。
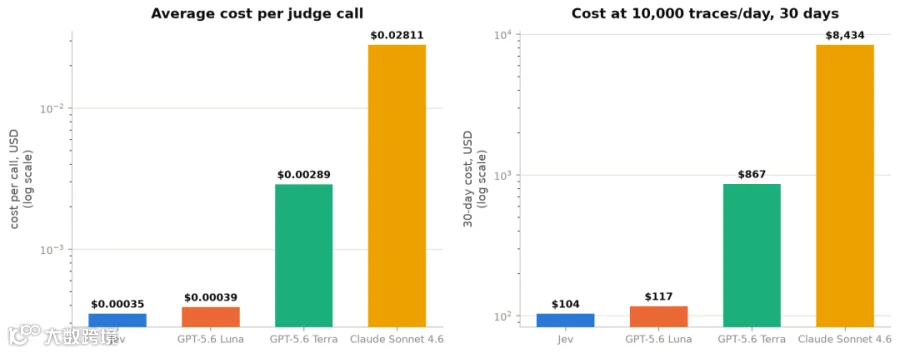
按每天 10,000 traces、持续 30 天来预测,这个差距会变成真正不同的运营成本:Jev 为 $103.59,Claude Sonnet 4.6 为 $8,434.08,GPT-5.6 Luna 为 $117.24,GPT-5.6 Terra 为 $866.61。
LangChain 还计算了一个 signal value:oracle agreement 乘以 repeatability,也就是对同一个 frozen trace 的两次独立调用落在相同 verdict 上的概率。
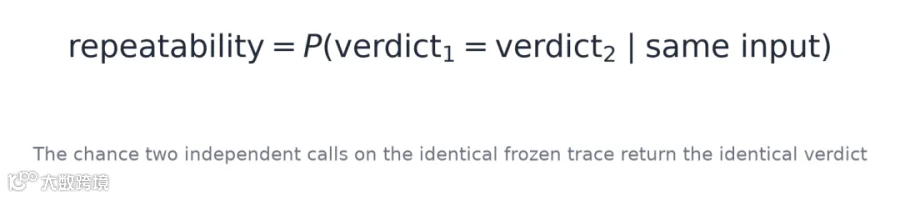
将它乘以 oracle agreement,会奖励既正确又可重复的 judge,并惩罚那种自信且稳定但错误的 judge。
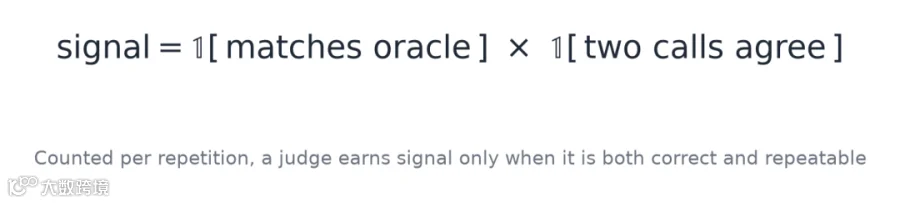
根据这个定义,一个只在有时正确,或者只在错误时可重复的 judge,什么也得不到。Jev 的 signal value 为 100.0 percent,GPT-5.6 Terra 为 99.4 percent,GPT-5.6 Luna 为 90.1 percent,Claude Sonnet 4.6 为 80.0 percent。
这个实验使用了一个 agent、五个 test cases,以及一个狭窄的 evaluation slice,所以我不会把它视为对所有 workload 的最终结论。但它是一个独立测量,而不是 vendor 自己的 benchmark,并且它指向了与机制本身预测相同的方向。
Jev 在哪里会失效
一旦 answer space 不再是提前已知的,Jev 就会变得不那么有用。
它不能写 response、summarize document、generate code,或解释自己的 reasoning。
它在 arithmetic、counting、date comparison 或 exact string manipulation 上不可靠,这些应保留在普通代码里。
当一个 decision 需要串联多个隐藏 reasoning steps 时,它会吃力;请把 judgment 拆成更小的问题,或使用 reasoning model。
它不能直接从 text 中 extract 一个 unknown value;先用别的东西找到 candidates,然后再让 Jev 在它们之间选择。
irrelevant context 会降低它的 accuracy;只发送 decision 需要的 state。
closed weights、early access window、text-only input,以及仍然有限的 independent calibration data,意味着现在还太早,不能在有真实后果的 decision 上盲目信任它。
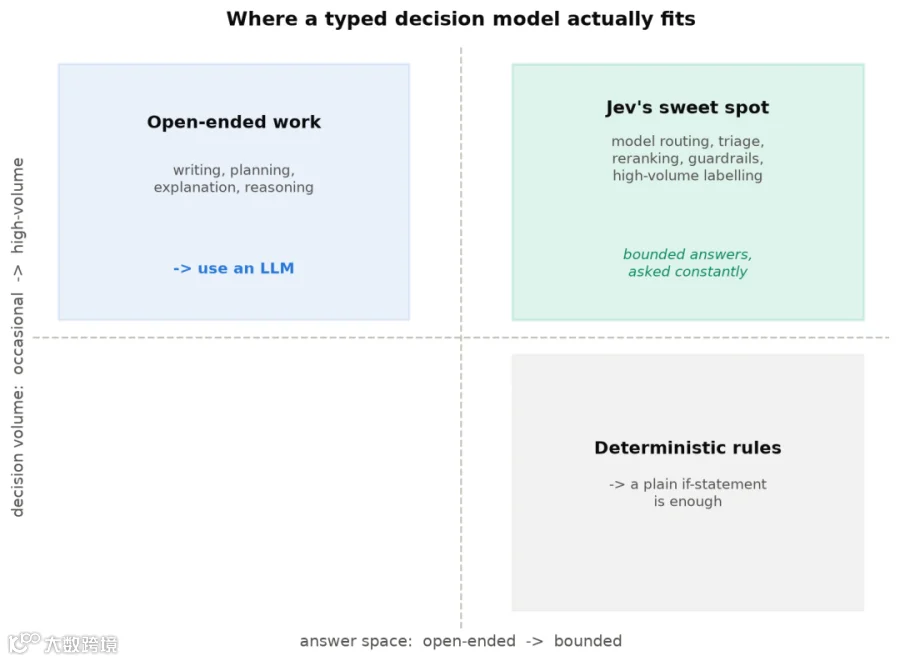
在所有这些之下,还有一条更简单的规则。如果 deterministic code 已经能正确解决问题,就保留代码;一个普通的 if statement 比任何模型都更快、更便宜,也更容易测试。
一种理性的上线方式
如果一个 cheap model 的错误会产生 retries、manual review 或 incident,它仍然可能变得昂贵,所以 rollout 必须衡量整个 workflow,而不只是 token price。
选择一个有界、低风险的 decision。 一小组命名清晰的可能答案,而不是 pipeline 中最危险的东西。
在调用模型之前写下 rubric。 用文字决定每个 option 里应该包含什么;rubric 是系统的一部分,不是事后补充。
先收集有代表性的 examples。 有意包含 ambiguous 和 adversarial cases。
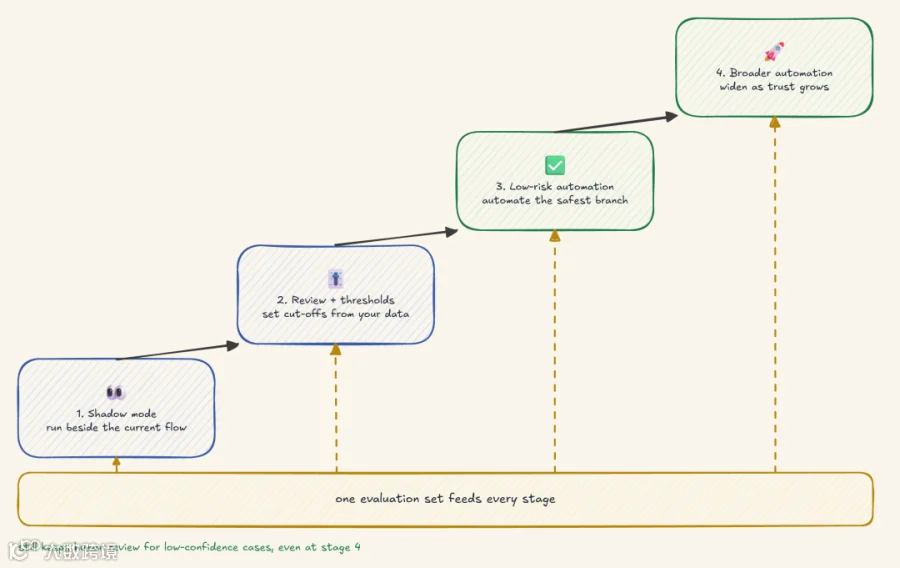
以 shadow mode 运行。 让它回答每个真实 case,但不改变任何东西,并把它的 probabilities 与当前 outcome 一起记录下来。
绘制 accuracy 与 confidence 的关系,并根据该数据设置 thresholds。 cut-off 应该来自 shadow-mode numbers,而绝不是猜测。
先自动化最安全的 branch。 对任何被 thresholds 标记为 uncertain 的内容,保留 human 或 stronger model 作为 fallback。
对一切进行 version。 将 model version、questions、criteria 和 thresholds 一起 pin 住,这样一次变更可以在同一个 evaluation set 上 replay。
第五步在做真正的工作。我想要的是在仍能自动化足够业务量的前提下最高的门槛,而不是抽象意义上的最高门槛。
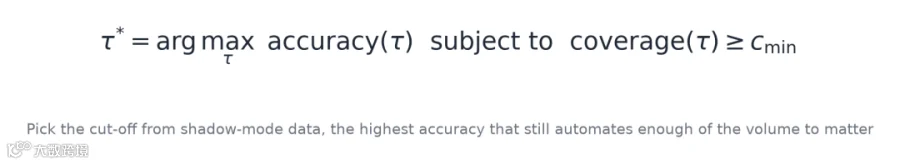
把门槛提得太高,系统永远不会犯错,因为它永远不做任何 decision;那不是 automation,而是昂贵的 logging。coverage constraint 会让这一点保持诚实。
这里证明了什么
机制本身已经被证明:我在上面构建并运行了它,使用真实 token IDs 和真实 restricted softmax 产生了一个真实的 0.678。独立 evaluation numbers 也是真实的,由一个没有动机美化 Jev 的第三方发布。
尚未证明的内容更长:
Jev 自身的 weights 是 closed 的,所以我验证的机制是在 open model 上的忠实重构,而不是对 Jev 本身的 inspection。
TypeSafe 自己的 latency 和 cost claims 位于它们自身比较中的有利边缘。
除了这里引用的那个 evaluation 之外,独立 calibration data 仍然很薄。
access 仍处于 early 阶段,interface 是 text-only,因此 image、UI 或 raw sensor data 都需要先通过单独步骤变成 text。
这些都不说明底层思路是错的。它只是让围绕它的 claims 更精确,而不是已经盖棺定论。
这把我们带到哪里
Jev 有趣之处不在于它比语言模型更会写作。它有趣是因为它完全拒绝写作:fixed answer types、每个答案上都有 explicit uncertainty、每个 question 并行评估,以及由代码保留 branching logic,而不是把它交给模型。
这使它成为 generative models 的 companion,而不是 replacement。generative model 仍然产生 plan、explanation 或 code。Jev routing request、gating risky action、checking result,并在 uncertainty 高到需要 human 查看时做出决定。
如果你要从这篇文章中构建一个东西,不要一开始就围绕 typed decision model 重建整个 agent。找一个你的代码为了得到一个 one-word answer 而支付完整 generative call 成本的地方,给它所需的最少 state,让它先赢得一个 branch,然后再交给它更多东西。
值得保留的 mental model 是最简单的:这种模型在一个普通 if statement 已经理解取值、但从未理解这些值含义的地方,恰好加入了 judgment。