国产GPU又打出一张硬核底牌!
一直以来,机器人、具身智能的强化学习训练,都是国产算力的“软肋”。不仅拼算力,更拼训练稳不稳、适配性强不强、落地能不能打。
近日,摩尔线程S5000交出了亮眼实测成绩单:在248路并行仿真训练环境中,它的AI训练收敛精度和国际主流GPU高度吻合,相关系数高达0.976;核心算子性能直接拉满,达到国际主流卡的1.6–2倍。
这组数据直白说明:国产GPU已经能稳稳跑通高端机器人训练,不再是样子货。
很多人不懂,机器人学动作,根本不靠人工一步步教。
真正的前沿训练,是让AI在虚拟环境里反复试错、自主学习。这次测试采用清华&无问芯穹联合研发的RLinf行业主流框架,是目前机器人训练最严苛的标准链路。
整套训练全程虚拟闭环:仿真出机器人动作、预判画面效果、判别对错优劣,反复迭代优化策略。
而强化学习最怕一件事:训练后期慢慢学偏、动作变形。
芯片微小的精度误差、浮点计算偏差,经过千万次迭代会无限放大,最后机器人学出来的动作完全不能用。
0.976的相关系数,就是稳定性的最好证明。
在完全相同的参数、随机条件下,S5000的训练收敛节奏、策略逻辑,和国际主流GPU几乎一致。后续真机测试中,机器人动作成功率也实现完美对齐。
简单说:国产芯片的训练精度、稳定性,已经跟上国际第一梯队,不会越学越歪。
客观来讲,这次测试未公布竞品具体型号、完整硬件参数,不能说已经全面超越对手。但足以证实:S5000完全适配高端具身智能训练,具备商用落地实力。
这次实测有个非常有意思的细节,也是很多行业人关注的重点:
S5000核心算子性能直接翻倍,但完整训练单步耗时,只优化缩短了26%。
看似“拉胯”,实则暴露了AI落地的真实真相:芯片算力强,不代表整体速度就快。真正的瓶颈从来不是核心计算,而是等待、调度、数据搬运。
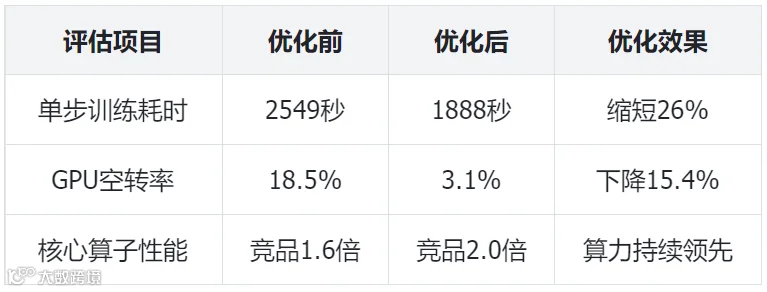
优化前,S5000近18.5%的时间都在空转摸鱼。
原因很简单:机器人训练既要渲染三维虚拟画面,又要做图像预处理。过去大量工作丢给CPU处理,高速GPU只能被动等待数据,算力再强也发挥不出来。
摩尔线程针对性做了三大工程优化:
● 所有图像处理工作全迁移至GPU,告别CPU拖后腿。
● 精简冗余计算步骤,去除无效数值校验。
● 升级底层计算方式,大幅提升高频运算效率。
优化后,GPU空转率暴跌至3.1%,算力彻底跑满。这也告诉我们:AI落地拼到最后,都是工程优化和链路打通的能力。
业内之所以看好S5000入局具身智能,核心原因只有一个:它是全功能GPU,碾压普通纯AI加速卡。
普通大模型训练,只需要简单的矩阵计算,纯加速卡就能搞定。
但机器人训练不一样!需要实时搭建3D虚拟场景、渲染仿真画面,给AI当“视觉传感器”。
市面上绝大多数AI卡,砍掉了图形渲染能力,只能靠外接CPU、显卡辅助渲染,再跨设备传数据。来回搬运数据,延迟高、损耗大、效率极低。
而S5000做到了单卡闭环:
一张卡既能渲染三维虚拟场景,又能高速跑AI模型计算,全程显存内完成,无需跨设备传输。完美适配机器人、世界模型的训练需求,这是普通AI算力卡比不了的核心优势。
比跑分更重要的,是生态的质变。
这次测试最大的行业价值:RLinf官方框架正式接入S5000,纳入CI常态化验证体系。
此前很多国产芯片的“适配成功”,都是临时调优、专属补丁的一次性成果。代码一更新、版本一迭代就翻车,根本没法商用。
现在不一样了!框架每一次迭代、每一次代码更新,都会自动在S5000上完成测试验证。兼容性永久在线,彻底告别适配翻车。
落地效果也足够硬核:基于该方案训练的机械臂装配任务,操作成功率从20%飙升至92%,真正实现从实验室走向真机实用。
摩尔线程S5000的这次实测,意义远超一组跑分数据。
它证明国产GPU不再只能做基础大模型训练,已经能深度适配机器人、具身智能、世界模型这类高端复杂场景。
从算力追平、精度稳定,到工程优化、生态常态化适配,国产AI算力正在完成从“能用”到“好用、够用、商用靠谱”的关键跨越。