

 PageIndex简介
AI/ML
PageIndex 是一个无向量数据库、基于推理的 RAG 引擎。它摒弃了传统的文本分块与向量相似度搜索,转而为文档生成层级化的树形索引,让大语言模型像人类专家翻阅长篇报告一样,通过多步推理在树结构中定位并提取信息。

它主要解决传统向量 RAG 在处理长篇幅、高复杂度专业文档时「相似但不相关」的检索痛点。通过上下文感知的推理检索,它在金融报告、法律合同、技术手册等场景中能提供更精准、可溯源且具备解释性的问答结果。
 亮点特性
01彻底告别向量库与分块
用层级树形索引替代传统的向量嵌入,从根本上消除「相似但不相关」的检索噪音
02类人阅读式推理检索
LLM 像人类专家翻阅目录一样在树节点中进行 Agentic 推理,检索过程透明且可溯源到具体引用
03极低的索引与查询成本
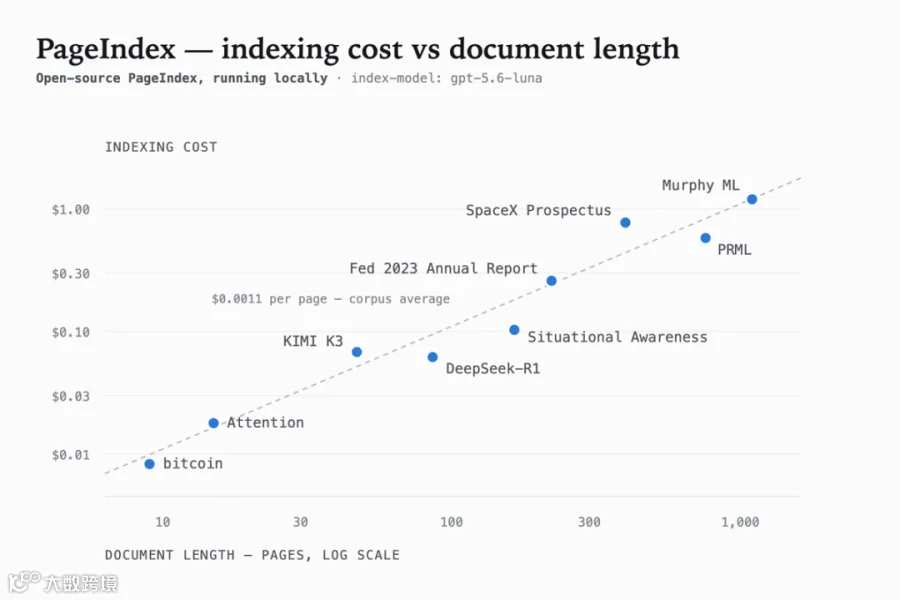
本地索引成本约每页 0.001 美元,千页教材仅需一美元左右;相比直接输入完整 PDF,查询成本最高可降低 16.6 倍
04突破上下文窗口限制
只读取推理路径到达的节点,轻松应对超出模型上下文窗口的超长文档(如 800+ 页)
05卓越的垂直领域表现
在金融文档问答基准 FinanceBench 上达到 98.7% 的准确率,远超传统向量 RAG 的 50%
 使用场景
场景 1金融财报分析
从数百页的年报或监管文件中精准提取特定财务指标(如营业利润率),避免语义相似性带来的误导
场景 2法律与合规文档审查
在长篇合同或法规中定位具体条款,支持结合对话历史和领域知识进行上下文感知检索
场景 3学术与技术文献研究
快速查阅厚重的教科书或技术手册,无需将整本书塞入上下文窗口即可实现低成本精准问答
 使用环境
 快速上手
安装依赖
|
本地模式基本用法
使用你自己的 LLM API Key,完全在本地完成索引构建、检索与对话:
|
云端模式用法
如需处理扫描件或图片丰富的文档,可切换至 PageIndex Cloud,由云端托管解析、OCR 和存储:
|
配置建议:index 参数使用基础模型即可,因为树结构主要从文档布局中提取;chat 参数建议使用能力最强的模型以保证推理检索的准确率。
 替代方案
对比 1LlamaIndex / LangChain
主流的 RAG 编排框架,默认依赖向量数据库和文本分块策略,处理复杂长文档时容易因切分不当丢失上下文,而 PageIndex 采用无向量的树形推理范式
对比 2RAPTOR (Recursive Abstractive Processing for Tree-Organized Retrieval)
同样采用树形结构的 RAG 方法,但侧重于对文本块进行递归聚类和摘要,PageIndex 则更强调利用文档原生布局并通过 LLM 实时推理遍历
对比 3Unstructured.io
专注于非结构化文档的解析与数据清洗,通常作为 RAG 管道的前置组件,本身不提供类似 PageIndex 的端到端推理检索机制
 相关资源
项目地址github.com/VectifyAI/PageIndex
文档docs.pageindex.ai