

9月23日,OpenRouter 上忽然多了一个叫 Space Bunny Alpha 的模型。开发者一栏只写着 stealth,背后的公司没有公布。公开页面显示,该模型免费开放,支持100万 token 上下文,支持推理强度调节和多模态输入能力,以及比较强的 Coding 能力。
仅仅三天后,这只具体来历仍然不清楚的兔子,就已经进入了 OpenRouter 调用量日榜第一名,同时也排到了新模型趋势榜第一名。

在 OpenCode 最近三天的模型用量榜单里面,它同样来到了第一名。
一个连厂牌都没有亮出来的模型,已经先依靠实际调用量,把 Space Bunny 这个名字推到了榜单最前面。

当然,榜单能够反映开发者的使用热度,却不能直接证明模型的任务质量。
为此,我将 Space Bunny、DeepSeek V4.1 Flash 和 GLM 5.3 Flash 放入同一套 OpenCode 环境,测试代码修复、数据仪表盘、财务研究和具身视觉理解四类任务。

最后得到的结果很有意思。Space Bunny 已经有资格进入 Flash 模型的实用候选名单。它在代码正确率、页面完成度和复杂交付能力方面的表现都能站得住,视觉呈现甚至达到了三个模型里面最好的一档。
而且在速度上并不输DeepSeek。
三模型最终结果
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
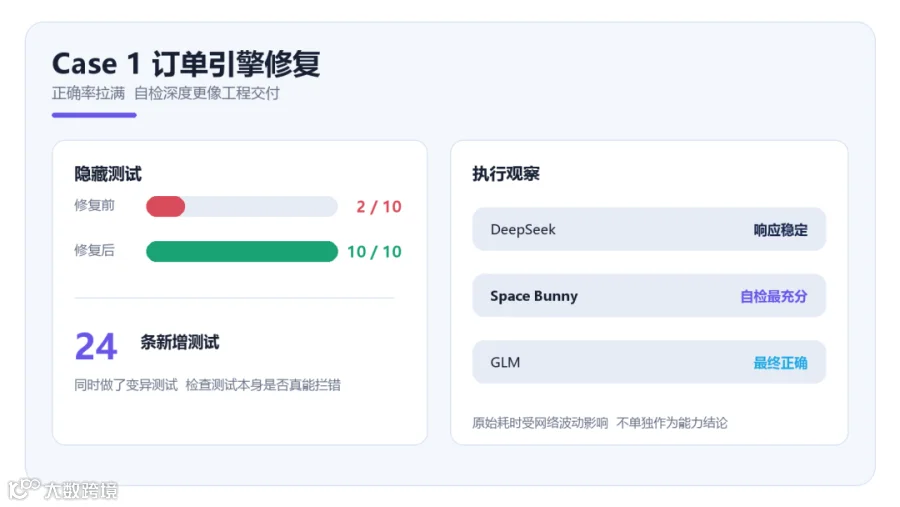
第一道题是一套存在缺陷的订单结算引擎。原始程序需要处理商品金额、优惠码、运费阈值和税费等内容,真正的错误隐藏在金额精度、四舍五入顺序、税基计算和非法输入处理这些环节里面。
任务要求模型在不破坏旧接口的前提下修复代码,并补充至少5项有意义的测试。

Space Bunny 最终通过全部10项隐藏测试,另外增加了24项测试,并用变异测试检查新增测试能否真正拦截错误。
DeepSeek 和 GLM 也通过了全部隐藏测试,三者在代码正确率上没有差距。不过,在自我检查的深度这一方面,Space Bunny 做得更加充分。
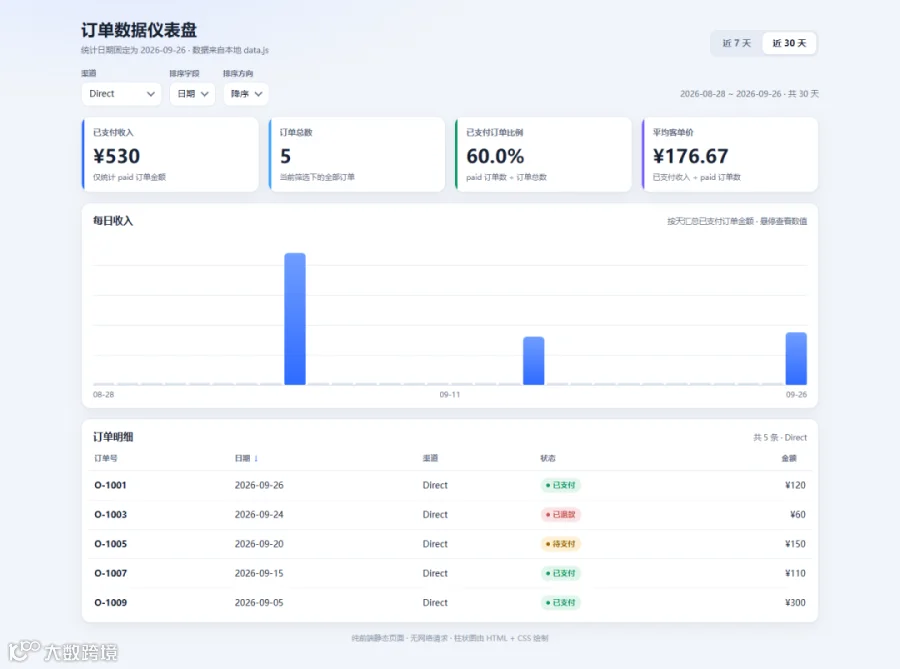
第二道题要求模型接手一个前端项目,制作可交互的订单数据仪表盘。页面需要支持 7 天和 30 天两个时间范围的切换,同时还需要提供渠道筛选、数据排序、收入图表、订单表格、空状态和错误状态。还要在390像素宽的手机屏幕上避免横向溢出。
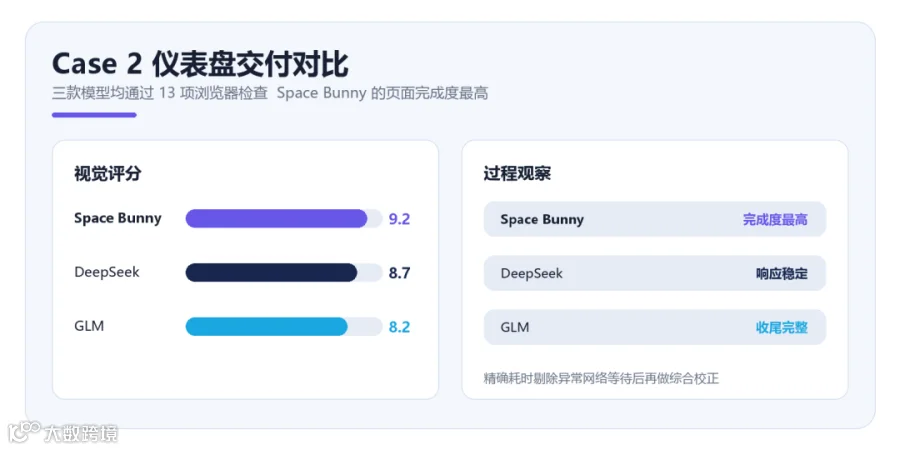
三个模型最终都通过了 13 项功能检查,筛选、排序、图表和手机端显示这些部分,都达到了任务提出的要求。视觉评分上,我给 Space Bunny 92 分、DeepSeek 87 分、GLM 82 分。
DeepSeek 制作出来的页面比较清爽,四个指标卡上面的数字显示得很醒目,每一项指标的下方也都写明了对应的统计口径,用户能够比较直接地理解这些数字代表什么。

GLM 的整体设计比较简洁,筛选区域、数据图表和订单表格都能够让人一眼看清楚,同时还支持用户点击表头进行排序。从实际使用的角度来看,这两个模型制作出来的页面都已经能够正常进行使用。
Space Bunny 能够让我在视觉评分上多加一些分,主要在于它把数据解释得更细。
比如,同样选择最近 30 天的 Direct 渠道,比如,在同样选择最近 30 天的 Direct 渠道以后,它会在筛选区域下方汇总当前筛选条件,以及符合条件的订单数量。
收入图除了把数据制作成柱状图以外,还会直接标出峰值金额和对应日期,并且在图表下方补充产生收入的天数和日均收入。到了订单表格底部,它还会同时列出已支付金额和全部订单金额,方便用户进行对照查看。
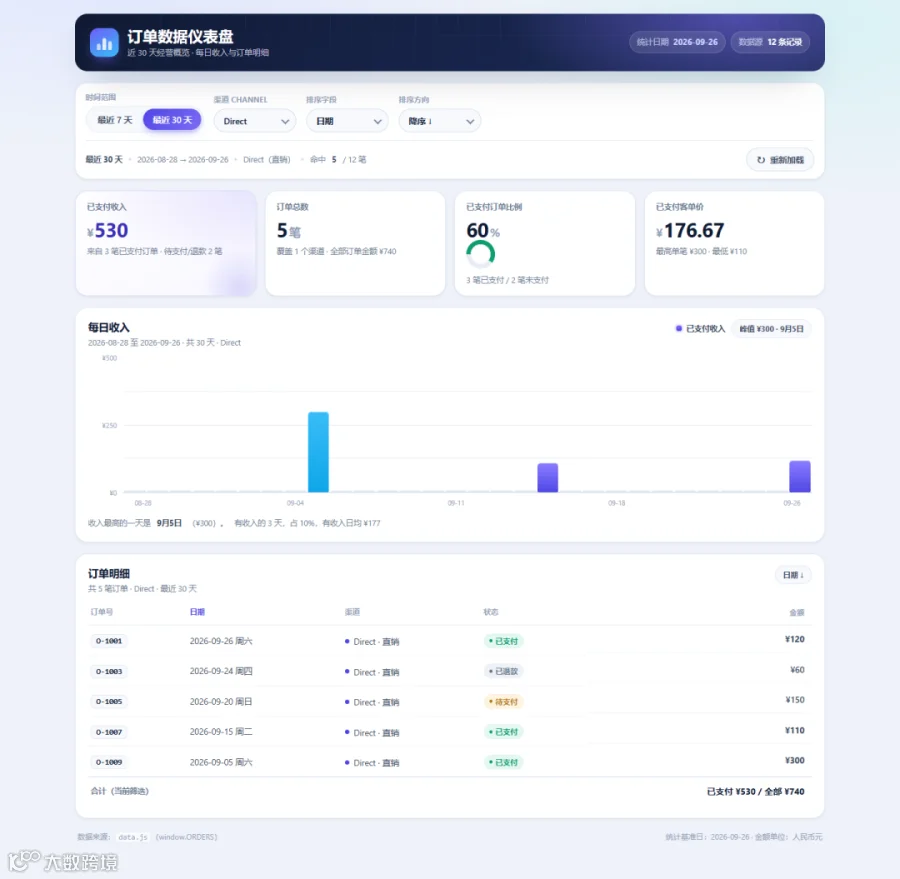
这些信息在 DeepSeek 和 GLM 的这一版页面里面,并没有采用同样集中的方式进行呈现。用户查看 Space Bunny 制作的页面时,可以直接读到几个比较关键的结论,减少一些来回查看图表和核对订单的操作。这也是我在这一项测试里面,更加偏向 Space Bunny 的主要原因。
第三道测试题的整个执行过程更长。模型需要读取 5 份资料,对其中的财务数据和估值口径进行整理,然后输出投资备忘录、DCF 模型、估值摘要,以及一张不依赖外部资源的 HTML 报告。
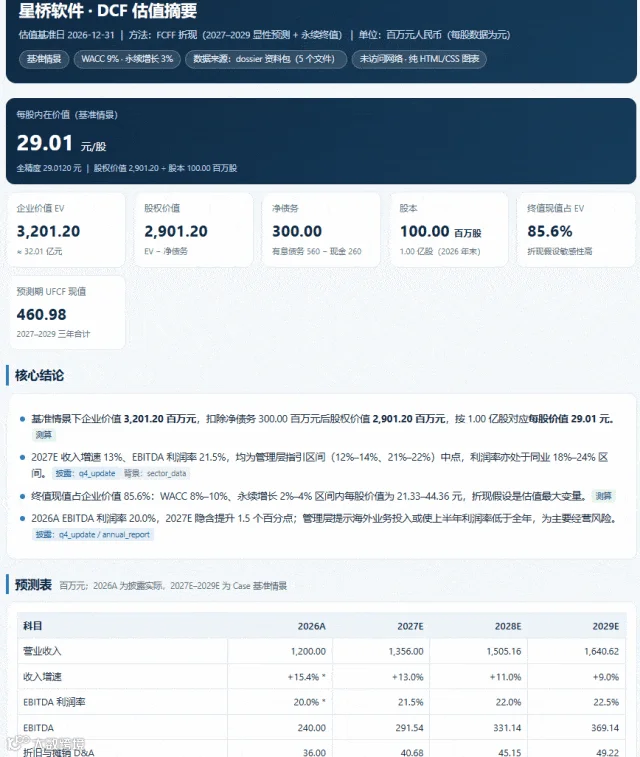
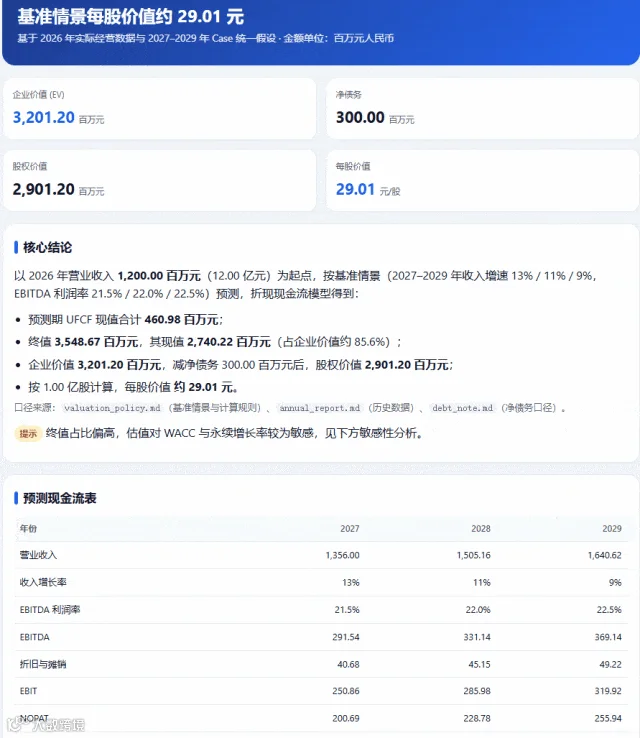
三款模型最后都通过了52项检查,核心估值完全一致。企业价值为3201.20百万元,扣除300百万元净债务以后,股权价值为2901.20百万元,对应每股价值29.01元。

Space Bunny 在这一项任务中交付的内容最为丰富。除了核心估值结论以外,它还制作了估值桥、经营趋势、三种情景、敏感性矩阵、估值口径说明和原始数据镜像。整个页面可以直接拿来进行复核,关键数字来自什么地方,在页面里面也说明得比较清楚。

Space Bunny 的财务报告
GLM 5.3 Flash 的财务报告
DeepSeek V4.1 Flash 的财务报告
如果只观察这一道财务任务,Space Bunny 很像一位愿意把附件和底稿整理完整的分析师。它除了把最终数字写出来,也把复核数字时需要查看的相关内容进行了整理。它的执行效率谈不上特别轻快,但是在交付意识这一方面真的很强。
机器人动作理解
最后一项测试使用一段28.1秒的人机协作视频。画面里,一名工作人员在桌面左、中、右依次放置杯垫,两台机械臂从托盘里取出三只杯子,再放到对应杯垫上。测试要求模型恢复动作顺序,判断任务完成状态,并根据最后画面提出下一步建议。

这一项中,DeepSeek 得到91分。它对可见事实和帧间不可见过程的区分最清楚,判断三组杯子已经落位,但末帧仍缺少夹爪完全松开和稳定性确认。它建议机械臂确认释放后垂直抬升、退回安全位,再进行视觉复核。

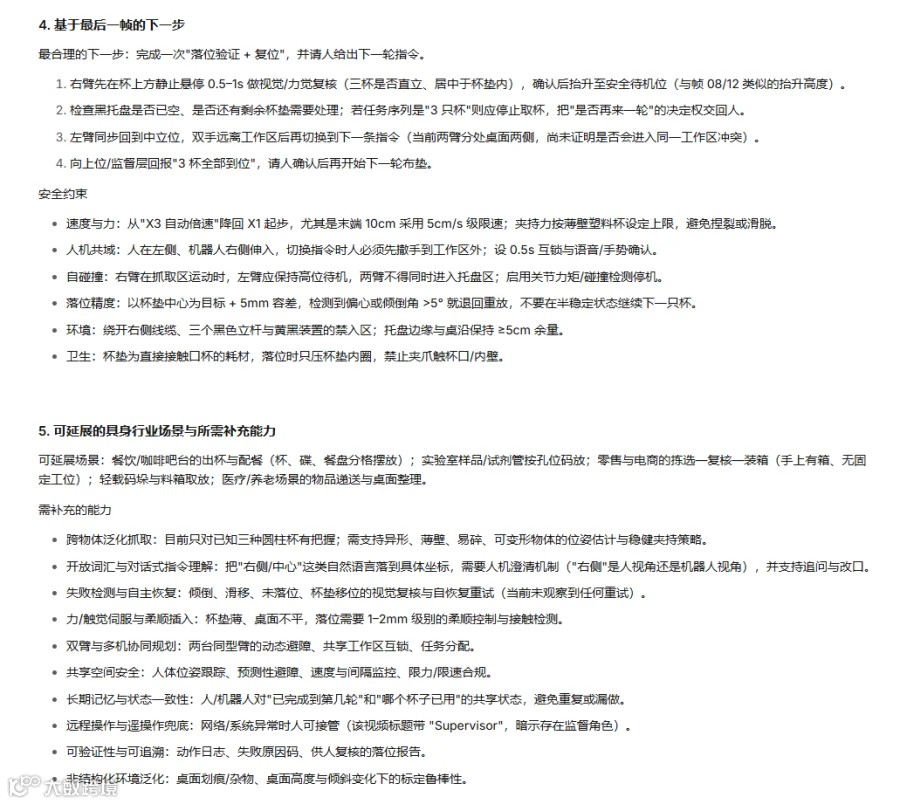
Space Bunny 得到90分。它对三轮人机协作和两台机械臂的动作分工还原得最完整,还把能力延伸到餐饮出杯、实验室器皿归位、仓储拣选和医疗递送。问题在于,它给出了每秒5厘米、5毫米容差和5度倾角等精确参数,而视频没有提供设备规格。这些内容只能算工程建议,不能作为画面事实。
GLM 得到88分。它正确识别了动作目标和最终状态,回答简洁,也没有添加过多精确参数。不过,它对异常恢复、人机交接和行业迁移的讨论较少。
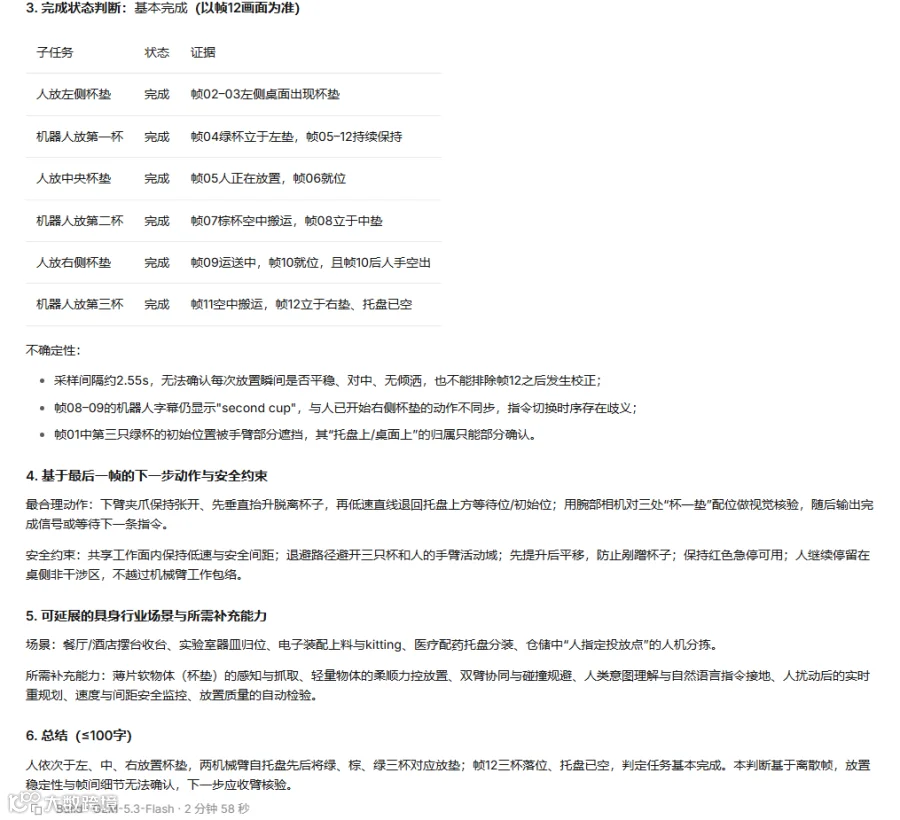
三款模型都能根据有序画面恢复任务流程,并从末帧提出下一步动作。DeepSeek 的证据边界最稳,Space Bunny 的动作链和场景延展最完整,GLM 的回答最简洁。它们的差距主要体现在分析深度和克制程度,而不是能否识别任务。
兔子背后是谁?
匿名模型一出,猜身份几乎是固定节目。名字叫 Space Bunny,兔子又住在月亮上,很多人自然往月之暗面方向猜。也有人把 Space 拆到 SpaceX,或者根据分词和工具调用风格猜 MiniMax。
不过,这些说法目前都没有得到官方确认,目前能确认的是,Space Bunny 免费开放,Coding 能力扎实,在前端审美和复杂页面交付方面也很突出,这个成绩已经足够让它进入实际项目的模型候选名单。
Space Bunny 适合放在哪里?
这轮测试下来,Space Bunny 已经有几个让我愿意继续使用的理由。
它完成了代码修复、数据仪表盘和财务研究三项任务,并且通过了全部最终验收。尤其是在页面呈现这一方面,它还补充了峰值提示、收入摘要和金额合计,让最后交付出来的结果更加方便查看,也更加方便实际使用。
如果你平时需要修改代码、制作网页,或者整理资料、生成报告,那么 Space Bunny 确实值得进行尝试。
趁着它目前仍然可以免费使用,可以拿一个自己手头真实存在的任务运行一遍,看看它交出的结果能不能直接使用。和单独查看榜单相比,这样的实际测试会更有参考价值。