

导语
“集智百科精选”是一个长期专栏,持续为大家推送复杂性科学相关的基本概念和资源信息。作为集智俱乐部的开源科学项目,集智百科希望打造复杂性科学领域最全面的百科全书,欢迎对复杂性科学感兴趣、热爱知识整理和分享的朋友加入,文末可以扫码报名加入百科志愿者!
↑↑↑扫码直达百科词条

黄一凡、杨明哲 | 作者
作者简介

目录
RealNVP(Real-valued Non-Volume Preserving,实值非体积保持变换)是一类基于标准化流(normalizing flows)的深度生成模型,由 Laurent Dinh、Jascha Sohl-Dickstein 与 Samy Bengio 于 2017 年提出[1]。它的核心思想可以概括为:用一个完全可逆的神经网络,将复杂的数据分布逐步变换为简单的高斯分布。由于变换可逆,模型既可正向精确计算数据的概率密度,也可反向直接从高斯分布采样生成新数据。在标准化流的谱系中,RealNVP 属于耦合流(coupling flow)分支,与NICE、Glow 同属一支,三者构成"加性耦合→仿射耦合→引入可逆

上图示意 RealNVP 的正向与反向流程:正向通过复合可逆变换将数据分布映射为标准高斯分布;反向则从高斯分布采样并逐层逆变换还原为数据。
1. 历史渊源
1. 历史渊源
RealNVP 的提出是沿着一条从数学工具到建模范式、再到具体架构的线索逐步成形的:先有密度估计的建模需求与变量替换公式这一数学工具,再有标准化流框架的正式提出,最后才落地为 RealNVP 等可训练的深度模型。
深度生成建模的一个核心需求,是既能精确计算数据的概率密度,又能从模型中高效采样。满足这一需求的数学工具是概率论中的变量替换公式:若变换可逆,变换前后的密度便由雅可比行列式精确联系。用可逆变换把复杂数据"归一化"到简单分布的尝试由来已久——从 1990 年代的独立成分分析(Independent Component Analysis,ICA),到 2000 年 Chen 与 Gopinath 的高斯化(Gaussianization)[2],都是这一思路的先驱。
这一思路被正式提炼为建模范式是在 2010 年:Tabak 与 Vanden-Eijnden 正式提出了"标准化流"(normalizing flow)的数学框架[3]:通过一系列可微可逆映射的复合,让基分布(base distribution,变换起点的简单分布,通常取标准高斯;与变换要逼近的目标分布相对)像水流一样"流动"成目标分布,密度则由变量替换公式精确给出。2015 年,Rezende 与 Mohamed 将这一框架引入变分推断[4],"标准化流"一词由此流行。作为一种建模范式,标准化流只规定变换必须可逆、基分布必须指定、密度由变量替换公式计算,而不限定变换的具体结构——这为不同的实现方案留出了空间。
最早把这一框架落到实处的是 2014 年 Dinh 等人提出的 NICE(Non-linear Independent Components Estimation)[5]。NICE 的关键创新是加性耦合层:将输入分成两半,其中一半直接保持不变,另一半则加上一个以第一半为条件的神经网络输出。由于该变换的雅可比行列式恒为 1,它保持体积(volume preserving),但表达能力因此受限。
2017 年的 RealNVP 在 NICE 的基础上将加性耦合扩展为仿射耦合,即以前一半变量为条件,对后一半变量先进行缩放再进行平移。这一改动使变换不再保持体积(non-volume preserving),增强了模型的表达能力,同时保留了计算上的便利性。后续的理论工作(Draxler et al., 2024)证明:体积保持的流不是分布的通用逼近器(universal approximator),而仿射耦合流在一定的良好条件下则是通用逼近的[6]。这从理论上解释了 RealNVP 相对于 NICE 的优势。除耦合流一支外,标准化流还有自回归流、连续流等其他实现路线(见"与相关框架的关系"一节);RealNVP 是耦合流支线上的关键一环。
值得一提的是,RealNVP 原论文通篇并未自称"标准化流"——该词在全文中仅出现于参考文献的标题里,作者当时将模型定位为基于变量替换公式、可精确计算似然的概率模型。将 RealNVP 正式归入标准化流大类下的耦合流分支,是由后来的综述文献确立的分类[7][8]。
2. 模型架构
2. 模型架构
RealNVP 是一类标准化流。标准化流是一类通过最大似然来估计分布的模型,其构造包含三个要素:一个可微的可逆映射、一个指定的基分布,以及由变量替换公式给出的精确密度。具体地,RealNVP 将一系列可逆映射
 。每一层变换的雅可比行列式都能高效解析计算,因此整体对数似然
RealNVP 把若干可逆模块按顺序堆叠,形成从数据空间到潜在空间的完整映射。其网络主体由四个功能模块组成:仿射耦合层(affine coupling layer)负责可逆的特征变换,每个耦合层输出后接批量归一化(batch normalization)以稳定训练;压缩(squeeze)负责降低空间分辨率并把信息重排到通道;变量分解(factor out)负责在每个尺度末尾抽取变量作为潜在变量。其中,仿射耦合层通过两种掩码实现输入的对半划分:空间棋盘掩码(checkerboard masking)像国际象棋棋盘一样按像素坐标的奇偶性把像素分成两组,通道级掩码(channel-wise masking)则按通道把变量分成前后两半;二者交替使用。
RealNVP 的多尺度架构如下图所示。输入图像
正向流程可概括为:
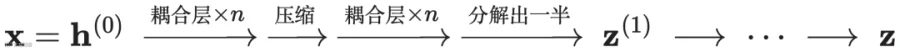
由于每个压缩和分解步骤都要对空间或通道维度进行对半划分,各尺度的空间尺寸与通道数都必须是偶数;实际应用中通常把图像尺寸调整为偶数,或通过填充、裁剪等预处理满足该条件。
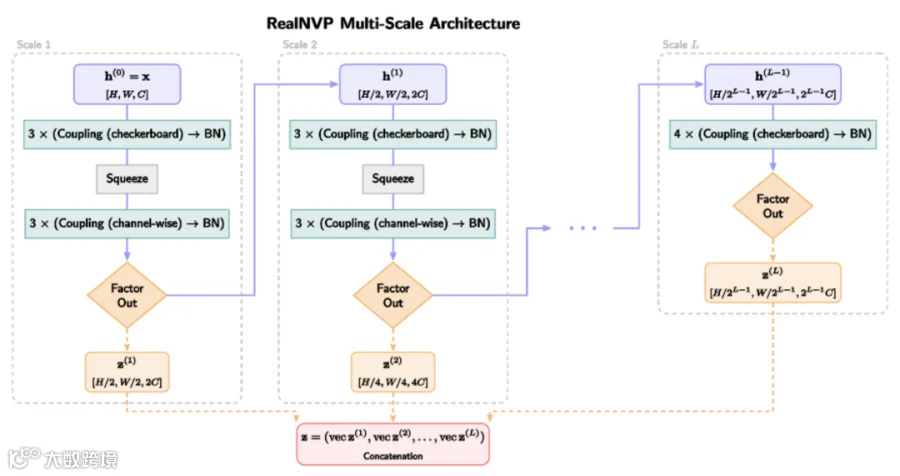
RealNVP 多尺度分层架构示意图。每个尺度(Scale)内数据自上而下流动,尺度间自左向右推进。图中 Coupling 即正文的仿射耦合层(括号内 checkerboard、channel-wise 分别为棋盘掩码与通道级掩码),块内"→ BN"表示每个耦合层输出后接批量归一化;Squeeze 为压缩,Factor Out 为变量分解,Concatenation 为拼接;h⁽ⁱ⁾、z⁽ⁱ⁾ 与正文符号一致。
2.1 仿射耦合层:可逆的"条件变形"
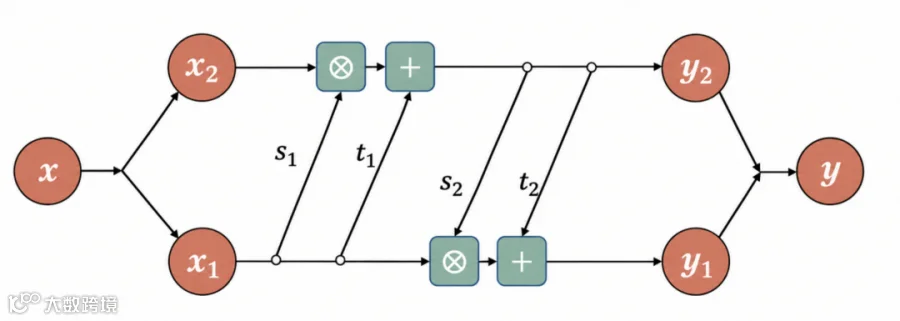
下图给出两个交替堆叠的仿射耦合层的前向流程。仿射耦合层是 RealNVP 的基本可逆变换单元;图中左半部分的符号与公式 (1) 一一对应。

这里
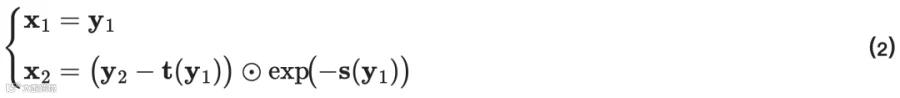
无需对
2.2 两种掩码分区模式
仿射耦合层要先把输入分成两部分:保持不变的一半称为被动部分,被变换的一半称为主动部分。针对图像数据,RealNVP 使用两种掩码来决定划分方式:
空间棋盘掩码(checkerboard masking):像国际象棋棋盘一样,按坐标
( i + j ) 通道级掩码(channel-wise masking):将前一半通道设为被动,后一半为主动。这通常在"压缩"操作后使用,因为此时空间分辨率已降低,通道间的语义分工更明确。
通过交替堆叠使用不同掩码的耦合层,每个维度都能在不同层中分别充当被动与主动变量,信息得以充分混合。原论文的多尺度架构中,每个尺度内同一掩码的耦合层固定为 3 层(末尺度为 4 层)[1]。
2.3 多尺度架构:分层打包潜在变量
如上图所示,多尺度架构依赖两个关键操作:压缩与变量分解。压缩:将空间上每个
1. 层次化表示:早期提取的
2. 梯度分散:损失信号能直接传递到所有尺度,避免梯度在深层消失。
3. 降低计算负担:越早提取的维度越多,后续层需要处理的特征图越小。
2.4 批量归一化:训练深层的稳定器
批量归一化(Batch Normalization,BN)应用于每个耦合层的输出之后。其映射为

其中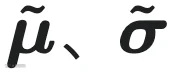 为均值与标准差——训练时按当前批次估计,推理时改用滑动平均(原因见下文)。由于 BN 对每个维度独立地缩放和平移,它本身也是一个可逆变换:其雅可比矩阵为对角阵,雅可比行列式即各维度缩放因子的乘积,可直接加入对数似然——这使 BN 可以像耦合层一样作为流中的一层。引入 BN 主要是为了稳定深层训练:它抑制了由缩放参数
3. 数学原理
3. 数学原理
RealNVP 的数学原理可分为两个层次。其一是标准化流的通用框架:变量替换公式给出精确似然的表达式,最大似然估计提供直接的训练目标,无需近似下界或辅助网络——这些结论对一切流模型成立,并非 RealNVP 特有。其二是 RealNVP 的特有设计:通用框架要求变换可逆且雅可比行列式可算,仿射耦合层的三角雅可比结构正是为满足这一要求而构造的,它使行列式计算开销与维度成线性关系,从而保证可处理性。本节先介绍通用框架,再阐述 RealNVP 的特化实现,进而比较加性耦合与仿射耦合在体积保持上的差异,最后讨论训练目标中两项各自的含义与实际训练配置。
3.1 标准化流与变量替换公式
标准化流的核心是概率论中的变量替换公式(change of variables)。设
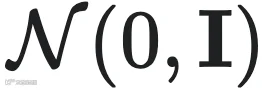 ),
 (3)
取对数得到训练用的目标:
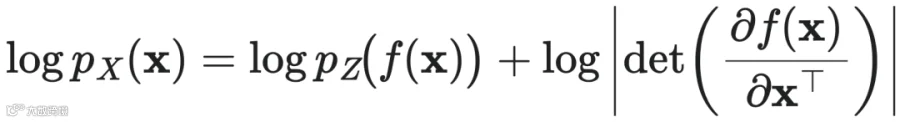 (4)
上式中,第一项
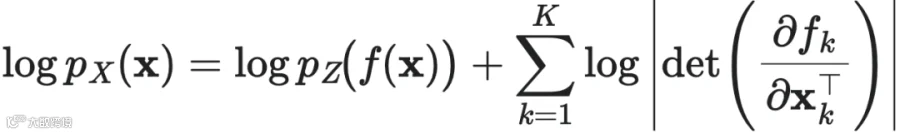 采样时通过逆向进行:
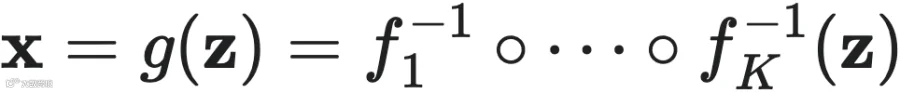 ,每层内部运算可并行,因此整体采样速度高于自回归模型(autoregressive model,如 PixelRNN):这类模型按固定顺序逐维生成数据、每个维度以先前各维为条件,采样必须串行进行——这与流模型对所有维度同时变换形成鲜明对比。
3.2 仿射耦合的雅可比行列式与可逆性
上一小节的结论适用于一切标准化流。RealNVP 要回答的问题是:如何构造一个既完全可逆、又满足行列式易算的变换?其答案就是仿射耦合层——它对被动半

由于左上角是单位阵,整个矩阵的行列式等于右下角对角阵的行列式:
 (5)
上述性质是 RealNVP 可处理性的关键:计算行列式不需要对神经网络
3.3 加性耦合、仿射耦合与体积保持
下表对比了三种耦合方式:

其中
3.4 损失函数与最大似然训练
RealNVP 通过最大化数据对数似然来训练(这也是标准化流的通用训练方式),等价于最小化数据分布与模型分布的前向 KL 散度(Kullback-Leibler divergence,KL):
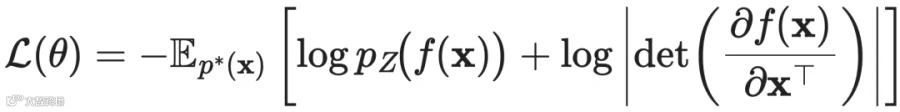 (6)
对于训练集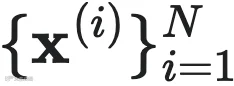 ,使用蒙特卡洛近似:
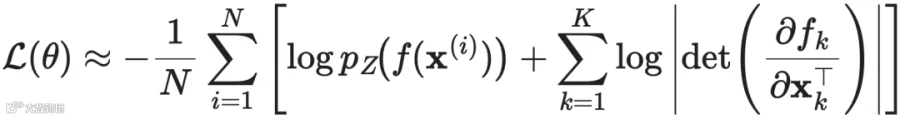 损失函数包含两项:
先验项
log p Z ( f ( x ) ) 行列式项:增大体积膨胀会提高似然,因此该项处处偏好扩张,与先验项的收缩压力相平衡——净效果是数据密集处扩张、稀疏处收缩,这与信息论中将码空间分配给高概率事件的原则一致。
从对偶视角看(Papamakarios et al., 2021)[8]:在数据上最小化前向 KL,等价于在潜在空间中最小化推前分布(即数据分布经
4. 应用
4. 应用
RealNVP 的应用对应着它的两个层面:作为完整的标准化流模型,它直接服务于密度估计、生成、异常检测与重建推断等任务;作为通用可逆部件,其仿射耦合层凭借解析可逆、雅可比行列式易算的性质,也被用于概率建模之外的场合。下文按此顺序介绍。
4.1 自然图像密度估计与生成
RealNVP 最直接的应用场景是连续高维数据的密度估计与无条件生成[1]。在图像生成任务中,模型一次性学习整个图像的联合分布,然后直接从标准高斯分布采样并通过逆映射得到新图像。在 CelebA 人脸生成任务中,RealNVP 能够生成全局连贯、五官清晰的人脸样本(见下图)。与变分自编码器(Variational Autoencoder,VAE)相比,RealNVP 不依赖固定的重建损失(如均方误差(Mean Squared Error,MSE)),因此不会过度平滑高频细节;与 PixelRNN 等自回归模型相比,RealNVP 的采样在维度上完全并行,速度更快。
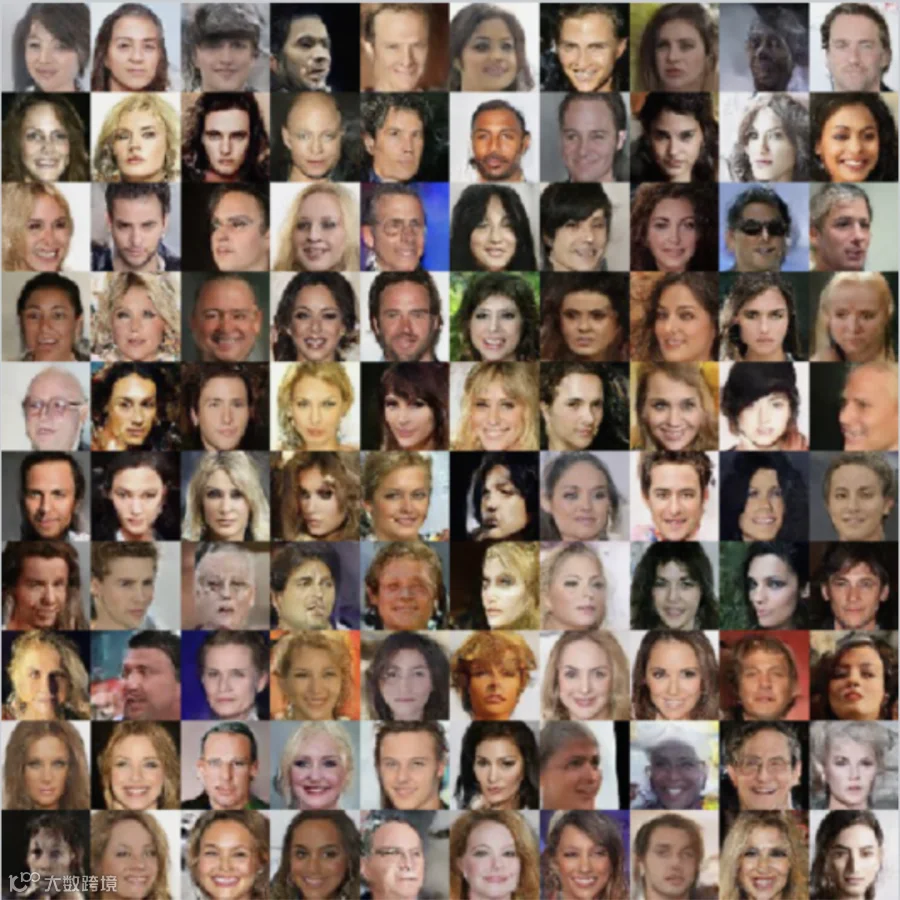
RealNVP 在 CelebA 上生成的人脸样本。
4.2 异常检测
RealNVP 能够给出数据的精确似然,这使它天然适合无监督异常检测:在仅含正常样本的数据上训练流模型,测试时将似然显著低于正常水平的样本判为异常。也可以把流与重建类模型结合起来,综合似然与重建误差构造异常分数——下文的 AE-FLOW 即属此类。医学影像领域尤其典型——正常扫描数量庞大,而病变样本稀少且难以标注。AE-FLOW 将自编码器与以 RealNVP 仿射耦合层为核心的标准化流瓶颈相结合,在胸部 X 光、光学相干断层扫描、皮肤镜与脑部核磁共振等多种医学影像数据上检测异常。模型同时利用重建误差与流模型给出的负对数似然构造异常分数:正常样本能被准确重建并获得较高似然,而病变区域会产生高重建残差与低似然[9]。
下图展示了 AE-FLOW 在胸部 X 光数据上的结果。左列为异常(肺炎)样本,右列为正常样本;每列自上而下依次为原图、重建图与残差图。正常样本的残差整体较暗,而异常样本的肺部区域出现明显亮斑,直观地反映了模型对异常模式的识别能力。
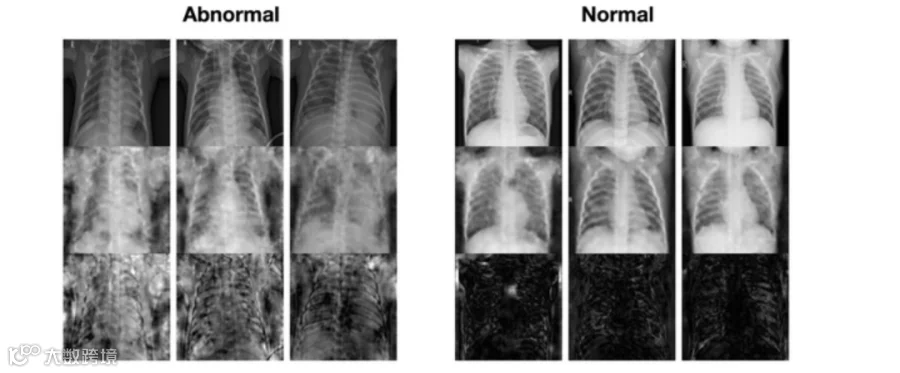
AE-FLOW 在胸部 X 光上的异常检测结果。左列为异常(肺炎)样本,右列为正常样本;自上而下依次为原图、重建图与残差图。
4.3 重建设置中的推断
由于编码器
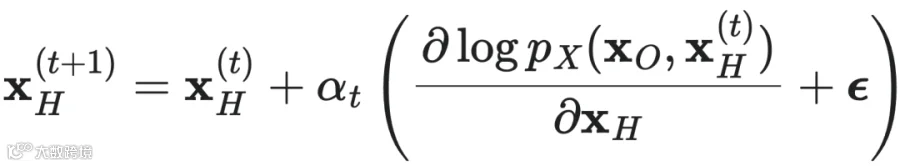
由于模型学习了全数据分布的精确密度,它能对任意形状的掩码产生合理的语义补全,而非仅记忆特定训练掩码[1]。在 LSUN 卧室数据集上,RealNVP 对缺失区域(红框)的补全结果在语义和视觉上均保持合理(见下图)。

RealNVP 在 LSUN 卧室数据集上的图像修复结果:红框标出被遮挡的原始区域,模型仅根据剩余像素和全分布密度完成补全。
4.4 在 NIS/NIS+ 因果涌现框架中的应用
在神经信息挤压器(Neural Information Squeezer,NIS)及其扩展 NIS+(Neural Information Squeezer Plus)中,RealNVP 的基础仿射耦合模块被用于构建可逆神经网络(Invertible Neural Networks,INN)编码器——堆叠 3 层,
1. 无损变换:由 RealNVP 耦合层堆叠构成的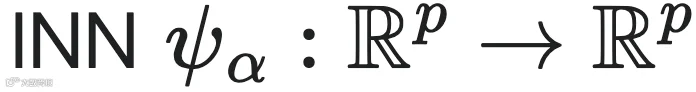 将微观状态
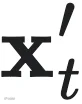 。该阶段信息不丢失。
2. 信息丢弃:投影算子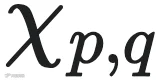 丢弃
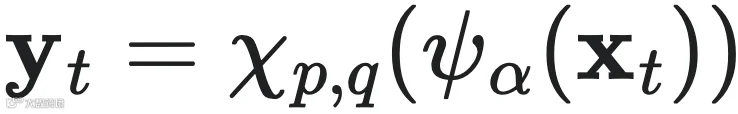 。
解码时,将宏观预测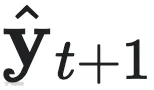 与
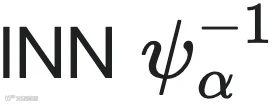 重构微观状态。由于 RealNVP 的编码器与解码器只是方向反转,参数完全共享——相较于使用独立编码器和解码器的方案,参数量减少一半,如下图所示。
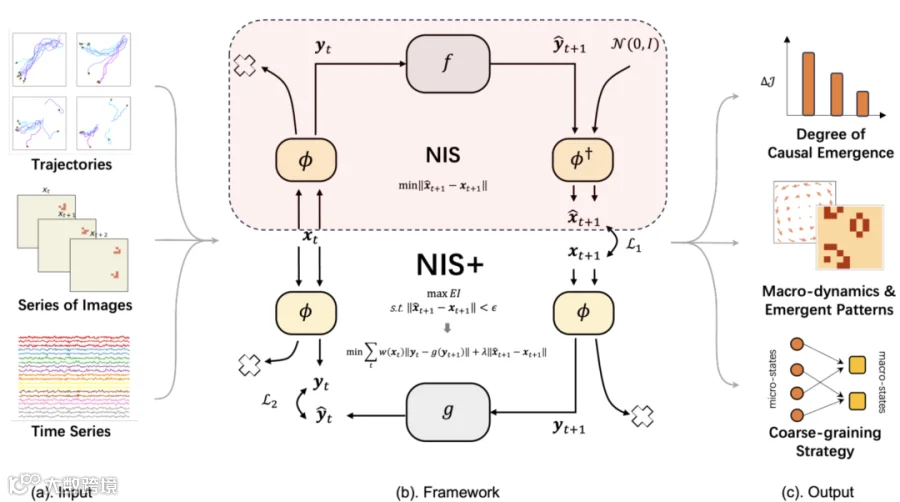
NIS/NIS+ 框架架构:RealNVP 的可逆神经网络(INN)实现编码器与解码器(图中记作 φ 与 φ†,分别对应正文中的
 ),信息丢弃与 EI 最大化在宏观动力学空间完成。
NIS 论文给出选用 RealNVP 的三点依据[10]:
1. 精确可逆性:微观到潜在的变换不损失信息,信息丢弃量
2. 参数共享:
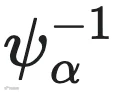 共用一套参数,显著压缩模型规模。
3. 行列式可解析:三角雅可比结构使有效信息(Effective Information,EI)上界和最优宏观维度
RealNVP作为NIS+中可逆表示学习模块,使粗粒化映射与反粗粒化映射共享参数,降低了模型复杂度,同时为有效信息最大化提供了可分析的数学框架。此外,基于可逆粗粒化结构构建的encoder具有通用逼近性质,能够表达不同复杂系统中的粗粒化映射。[13]。
5. 优缺点
5. 优缺点
5.1 优势
精确似然:RealNVP 能直接算出任意数据点的精确概率密度——不像 VAE 只能优化似然的一个下界,也不像生成对抗网络(Generative Adversarial Network,GAN)完全不给密度。因此异常检测、贝叶斯推断等需要显式概率值的任务可以直接使用它[8]。
并行采样与推断:自回归模型必须逐像素按顺序生成,而 RealNVP 编码和解码时所有维度同时计算,生成一张图像只需一次前向传播,采样速度快得多。
语义潜在空间:由于潜在分布是简单的标准高斯、且映射光滑可逆,在潜在空间中做插值等简单操作,就对应图像上有语义的连续变化(如人脸姿态、表情的渐变),适合表示学习与属性操控[1]。
架构灵活:耦合层只要求
s t 综合多种模型特性:RealNVP 同时具备了此前难以兼得的能力——自回归模型的精确似然、VAE 的一步采样,以及不依赖固定重建损失的生成质量。
5.2 局限
似然性能未达最优:RealNVP 对数据分布的拟合精度仍略逊于 PixelRNN 等自回归模型[1]。在以拟合精度为核心的任务(如密度估计、数据压缩)上,这是它的相对劣势——尽管它以并行采样换来了远快于对手的生成速度。
维度保持约束:可逆变换要求输入与输出同维,因此 RealNVP 不能像自编码器那样把高维图像压缩成低维向量——潜在变量的总维度始终与输入相同。多尺度架构中的变量分解并不改变这一点,它只是让后续层处理更小的特征图,并把潜在变量分配到不同尺度。
仿射耦合的表达力上限:仿射耦合每层只对一半变量做"缩放加平移",函数形式较为简单,拟合复杂分布往往需要堆叠很多层。后续工作把变换换成更灵活的函数形式——如 Flow++ 的 Logistic 混合 CDF 耦合[14]、Neural Spline Flows 的有理二次样条耦合[15]——用更少的层数即可达到更强的拟合能力。
均匀去量化的次优性:像素是 0–255 的离散整数,而 RealNVP 建模的是连续分布。RealNVP 的做法是给像素加上均匀噪声,把离散数据"抹平"成连续的——但这相当于让模型拟合一个被噪声模糊过的分布,与真实分布存在偏差。Flow++ 提出的变分去量化让噪声分布本身也由模型学习,缓解了这一问题[14]。
分区固定性:掩码决定哪一半变量被变换,而这一划分在训练前就已固定、训练中不再改变;若某层的划分不理想,只能靠后续层弥补。Glow(Generative Flow with Invertible 1×1 Convolutions)改用可学习的可逆
1 × 1 训练显存开销大:标准反向传播需要保存每个耦合层的激活值,层数一多显存占用显著上升;RevNet 的可逆残差结构正是为省去这部分存储而提出的[11]。
对分布外样本过度自信:上文的异常检测应用依赖"异常样本的似然更低"这一假设,但后续研究发现这一假设未必成立:例如在 CIFAR-10 上训练的 RealNVP,会给截然不同的 SVHN 街景数字图像赋予更高的似然[17]。似然高低与"是否属于训练分布"并不直接对应,因此基于似然的异常检测需要额外的校准手段。
6. 与相关框架的关系
6. 与相关框架的关系
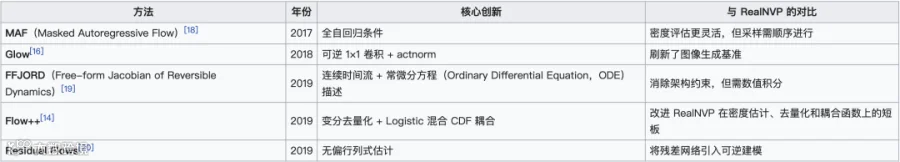
RealNVP 在标准化流的发展中处于承上启下的位置。下表列举前驱与后继的代表性工作:
前驱工作

后续发展
参考文献
参考文献可上下滑动查看
本词条由集智俱乐部众包生产,难免存在纰漏和问题,欢迎大家留言反馈,一经采纳,可以获得对应的积分奖励噢!
加入我们
亲爱的社区伙伴与知识探索者:
我们诚挚邀请热爱知识分享的您,加入集智百科词条编写志愿团队!无论您是领域专家,还是对特定主题充满热忱的学习者,这里都有您的舞台。通过编写百科词条,您将为全球读者传递权威知识,同时获得专家指导与个人能力跃升的双重成长。
📝 志愿者职责
创作新词条:覆盖复杂系统、人工智能等前沿领域
迭代经典内容:更新现有词条,守护知识的准确性与时效性
质量守护者:参与内容校对审核,共建精品知识库
🌟 我们期待您
集智读书会成员(需完成一期字幕任务)
拥有清晰表达复杂概念的写作能力
对特定领域有深度研究或强烈兴趣
具备信息检索与整合素养
怀揣责任感与协作精神,愿为知识共享赋能
🎁 您将收获
百科积分(支持兑换集智俱乐部周边:文化衫、复杂科学知识卡以及提现)
集智俱乐部创始人张江教授亲自指导写作
科研志愿者晋升通道:表现优异者可加入张江教授科研团队从事科研志愿者
你的百科贡献之路,从一字一句开始!
第一步,从成为一名字幕志愿者开始!
只需完成一期读书会讲座字幕任务,这不仅是贡献,更是一次深度的学习。字幕任务过关后,您将升级为“百科志愿者”,开启编辑词条、整理术语的进阶旅程。
从字幕到百科,这是一条清晰的成长路径。立即行动,从第一个任务开始你的升级吧!
扫码加入
因果涌现第七季——从理论到应用
在神经系统中意识的生成、城市交通的拥堵演化、全球产业系统的协同与失稳之中,始终潜藏着一条贯穿微观与宏观的因果脉络:个体行为本身或许简单,却能在尺度跃迁中孕育出高度组织化、难以还原的整体结构。复杂现象并非微观规则的线性叠加,而是源于多尺度动力学作用下逐步形成的因果组织。正是在这一背景下,因果涌现理论被提出,并在因果涌现 2.0、工程化涌现以及多尺度因果抽象等工作中推进,逐渐发展出一套融合动力学分析、信息论度量以及谱方法与人工智能工具的研究框架,从而将研究重心从“复杂性本身”转向“因果结构如何出现、如何被度量并在现实系统中发挥作用”。
为系统梳理因果涌现领域的最新进展,北京师范大学系统科学学院教授、集智俱乐部创始人张江老师领衔发起「因果涌现第七季」读书会,组织对该主题感兴趣的研究者与探索者共同研读前沿文献、交流研究思路。读书会将于2026年2月22日起每周日上午(创建读书会暂定时间为10:00-22:00)线上开展,持续约10周,包含主讲分享与讨论交流,并提供会后视频回放,诚邀相关领域研究者及跨学科兴趣者参与。
详情请见:因果涌现第七季——从理论到应用
加入我们
亲爱的社区伙伴与知识探索者:
我们诚挚邀请热爱知识分享的您,加入集智百科词条编写志愿团队!无论您是领域专家,还是对特定主题充满热忱的学习者,这里都有您的舞台。通过编写百科词条,您将为全球读者传递权威知识,同时获得专家指导与个人能力跃升的双重成长。
📝 志愿者职责
创作新词条:覆盖复杂系统、人工智能等前沿领域
迭代经典内容:更新现有词条,守护知识的准确性与时效性
质量守护者:参与内容校对审核,共建精品知识库
🌟 我们期待您
集智读书会成员(需完成一期字幕任务)
拥有清晰表达复杂概念的写作能力
对特定领域有深度研究或强烈兴趣
具备信息检索与整合素养
怀揣责任感与协作精神,愿为知识共享赋能
🎁 您将收获
百科积分(支持兑换集智俱乐部周边:文化衫、复杂科学知识卡以及提现)
集智俱乐部创始人张江教授亲自指导写作
科研志愿者晋升通道:表现优异者可加入张江教授科研团队从事科研志愿者
你的百科贡献之路,从一字一句开始!
第一步,从成为一名字幕志愿者开始!
只需完成一期读书会讲座字幕任务,这不仅是贡献,更是一次深度的学习。字幕任务过关后,您将升级为“百科志愿者”,开启编辑词条、整理术语的进阶旅程。
从字幕到百科,这是一条清晰的成长路径。立即行动,从第一个任务开始你的升级吧!
扫码加入
因果涌现第七季——从理论到应用
在神经系统中意识的生成、城市交通的拥堵演化、全球产业系统的协同与失稳之中,始终潜藏着一条贯穿微观与宏观的因果脉络:个体行为本身或许简单,却能在尺度跃迁中孕育出高度组织化、难以还原的整体结构。复杂现象并非微观规则的线性叠加,而是源于多尺度动力学作用下逐步形成的因果组织。正是在这一背景下,因果涌现理论被提出,并在因果涌现 2.0、工程化涌现以及多尺度因果抽象等工作中推进,逐渐发展出一套融合动力学分析、信息论度量以及谱方法与人工智能工具的研究框架,从而将研究重心从“复杂性本身”转向“因果结构如何出现、如何被度量并在现实系统中发挥作用”。
为系统梳理因果涌现领域的最新进展,北京师范大学系统科学学院教授、集智俱乐部创始人张江老师领衔发起「因果涌现第七季」读书会,组织对该主题感兴趣的研究者与探索者共同研读前沿文献、交流研究思路。读书会将于2026年2月22日起每周日上午(创建读书会暂定时间为10:00-22:00)线上开展,持续约10周,包含主讲分享与讨论交流,并提供会后视频回放,诚邀相关领域研究者及跨学科兴趣者参与。
推荐阅读
6. 高考分数只是张入场券,你的科研冒险在这里启航!
7. 加入集智字幕组:成为复杂科学知识社区的“织网人”
#原创
点击“阅读原文”,报名读书