

基于 SGLang
f4de6abee6(2026-09-28)与 vLLM8b365ff949(2026-09-25)。SGLang 与 vLLM 各讲一半:容量怎么记账、准入怎么判断、打满之后发生什么,最后回到题目里的现象。
监控面板上,L2 的曲线一直趴在底部:HiCache 的 host 内存(或 LMCache 的 CPU 池)大半空着,命中率看着也不差。按直觉,缓存健康、容量富余,服务应该高枕无忧。但 P99 TTFT 已经从 2 秒爬到 40 秒,告警群里吵成一团。
这类问题的排查方向常常一开始就偏了:大家盯着 L2 找问题,而瓶颈在 L1——HBM 里的 KV Pool。推理系统的并发容量记在 L1 的账本上,L2 只记缓存的账。 L1 打满之后,引擎收紧准入、请求排队、运行中的请求被整体回退重算,排队和重算的延迟全部灌进 TTFT;这一切发生时,L2 可以依然是空的。
本文对照 SGLang 与 vLLM 的源码把这件事讲清楚:并发能力由什么决定(第一节)、KV Pool 的三态记账(第二节)、看哪几个指标确认 L1 瓶颈(第三节)、L1 与 L2 各自管什么(第四节),最后把现象完整解释一遍并给出诊断清单(第五节)。
一、并发能力由什么决定
1.1 一条先行的物理公式
一个 token 的 KV 占用在生成时就定死了。MHA/GQA 的账目:
KV per token = 2 (K 和 V) × layers × kv_heads × head_dim × dtype_bytes
以 Llama-3-70B 为例(80 层、GQA 8 个 KV head、head_dim 128、bf16):2 × 80 × 8 × 128 × 2 = 320 KiB/token。80 GB HBM 扣掉权重、激活和 CUDA 图预留后,假设 60 GiB 留给 KV Pool,约 19 万 token;TP8 摊到 8 张卡后约 157 万 token——32K 上下文约 48 路并发,128K 上下文只剩 12 路。上下文翻倍,并发减半(以上为估算,实际预留比例因部署而异)。
MLA 系好得多:DeepSeek-V3 每层 576 元素的压缩 latent,61 层 bf16 约 68.6 KiB/token,一个 128K 请求约 9 GB——这也是本站 dp-attention 篇算过的同一笔账。
于是有了那条先行的公式:
并发数 ≤ KV Pool 总 token 数 ÷ 平均序列长度(输入 + 输出)
算力不够,请求可以慢慢跑;Pool 装不下,请求是进不来的。KV Pool 是并发容量唯一的硬约束——而它就是 L1。
1.2 引擎实际怎么准入:两条只认 L1 的预算线
物理公式是天花板,引擎的准入是逐 token 的精细账。
vLLM:内联试探。 v1 的 schedule() 每轮按三条线试到装不下为止:token 预算 max_num_batched_tokens、并发条数 max_num_seqs(vllm/v1/core/sched/scheduler.py:577-580,877-879)、以及逐请求调用 allocate_slots 分配 block,装不下返回 None(scheduler.py:743-767)。Pool 总量在启动时由 profile 定出:profiling 算出峰值显存占用,剩余部分除以每 block 字节数得到 num_gpu_blocks(vllm/v1/worker/gpu_worker.py:567-659、vllm/v1/engine/core.py:312-337、vllm/v1/core/kv_cache_utils.py:1766),block_size 默认 16(vllm/config/cache.py:71)。
SGLang:预算公式。 准入走 PrefillBudget,核心一行:
   # python/sglang/srt/mem_cache/prefill_budget.py:75-84
def _available_and_evictable(self):
    evictable = (self.tree_cache.full_evictable_size() ...)
    return self.allocator.available_size() + evictable

@property
def remaining_total(self):
    return self._available_and_evictable() - self.total_offset
total_offset 里每准入一个请求就 reserve() 一笔:reserved = extend_input_len + max_new_tokens + page_size(prefill_budget.py:37)——给「这个请求将来还要生成多少」预留预算。预留多少由 new_token_ratio 估计:从 0.7 × schedule_conservativeness 起步,随 decode 步数线性衰减到下限(managers/scheduler_components/new_token_ratio_tracker.py:22-31)。起步保守、逐步放宽,发生 retract 时立刻调回高值重新保守。
两个引擎的准入逻辑完全不同,但有一个共同点:两条预算线读的都是 L1 的计数器。allocate_slots 比的是 get_num_free_blocks,remaining_total 算的是 available_size + evictable_size——L2 有多少空间,在准入公式里一次都不出现。
二、KV Pool 的三态:used、evictable、available
把 Pool 想成一个停车场:used 是被运行中请求锁住的车位;evictable 停着已缓存的前缀,随时可清走让位;available 是空位。三态之间的迁移,就是两个引擎记账的全部内容。
2.1 SGLang:树上的三态
SGLang 用 radix tree 管前缀缓存,三态在树上迁移。请求持有一个前缀时,路径上每个节点的 lock_ref 加一,加锁瞬间完成三态迁移:
   # python/sglang/srt/mem_cache/radix_cache.py:583-596
def inc_lock_ref(self, node: TreeNode) -> IncLockRefResult:
    ...
    if node.lock_ref == 0:
        self.evictable_size_ -= len(node.key)
        self.protected_size_ += len(node.key)
protected_size 就是三态里的 used。账目合成在 pool_stats_observer.py:220-230:
   available_size = self.token_to_kv_pool_allocator.available_size()
evictable_size = self.tree_cache.evictable_size()
num_used = self.max_total_num_tokens - (available_size + evictable_size)
token_usage = num_used / self.max_total_num_tokens
即 total = protected + evictable + available,三项各有一个计数器,直接可查。
逐出是按需的:分配缺口出现时,evict_to_free_tokens 算出 shortfall = 需求 − available,从 eviction heap 逐叶子节点,正好逐出 shortfall(mem_cache/allocator/base.py:135-149、mem_cache/common.py:188-210)。没有「水位到 90% 开始逐出」的固定水线参数——缺多少,逐多少。
2.2 vLLM:块上的三态
vLLM 没有显式的 evictable 计数器,三态藏在 block 的两个字段里:ref_cnt(是否被请求持有)和 block_hash(是否已注册进前缀缓存哈希表)。ref_cnt == 0 ∧ block_hash 非空 就是 evictable——释放后进了 free_block_queue,但哈希还在,随时可以按前缀命中复用,也可以在需要时被逐出(vllm/v1/core/block_pool.py:793-805)。
释放路径上有个巧思:块在被持有期间满块时就注册哈希(cache_full_blocks,block_pool.py:225-298),释放时零操作自动变成 evictable。SGLang 是释放时才在两套计数间迁移,vLLM 是提前挂好牌。
free 队列一个队列、两种排序:有哈希的块(可逐出的缓存)排队尾,按 FIFO 实现近似 LRU 逐出;无哈希的块插队头优先复用,照顾 GPU 访问局部性(block_pool.py:793-805)。
vLLM 还有一个 watermark 参数,语义容易误会:它是准入预留,不是逐出水线。watermark 默认 0.0(关闭,vllm/config/scheduler.py:197-202);开启后只在准入 waiting/preempted 请求时保留 watermark_blocks 个空位不分配,避免刚放进来就抢占、抢占完又放进的抖动(vllm/v1/core/kv_cache_manager.py:205-208,506-513)。旧版 v1 默认 0.01,当前 HEAD 已改为 0.0——对照旧资料时注意版本。
2.3 两边记账对照
注意最后一行:vLLM 的 free 把 evictable 含在里面,看它的空闲指标要心里有数——「free」里一部分是真空闲,另一部分是缓存可清。SGLang 把两者分开报。这也是第三节里两家指标口径差异的根源。
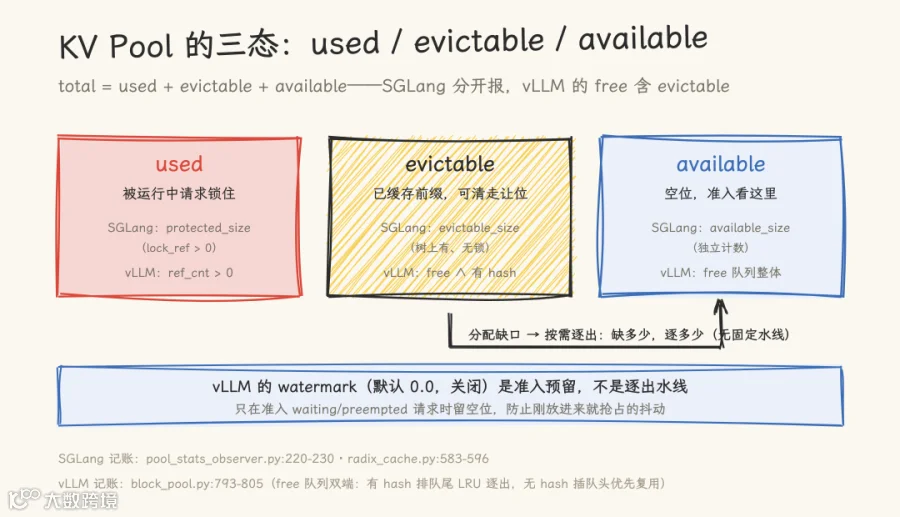
图 1|三态与逐出:used 被运行中请求锁住;evictable 是已缓存可清的前缀;available 是空位。分配缺口出现时按需逐出——缺多少逐多少,没有固定水线。SGLang 三个计数分开报,vLLM 的 free 指标把 evictable 含在里面。