


在官宣帖中,倪天炜提到,博士期间自己的研究主要围绕 History-Dependent Reinforcement Learning(历史依赖强化学习) 展开,重点关注记忆、表示和适应性。
这几个关键词,也几乎串起了他过去几年的整个研究轨迹。
倪天炜本科就读于北京大学计算机科学专业,随后前往卡内基梅隆大学,获得机器学习硕士学位。
之后,他进入蒙特利尔大学攻读博士,同时加入 Mila,师从 Pierre-Luc Bacon。
博士期间,倪天炜还与普林斯顿大学的 Benjamin Eysenbach、麦吉尔大学的 Aditya Mahajan 等研究者合作,并曾在 Amazon 实习。

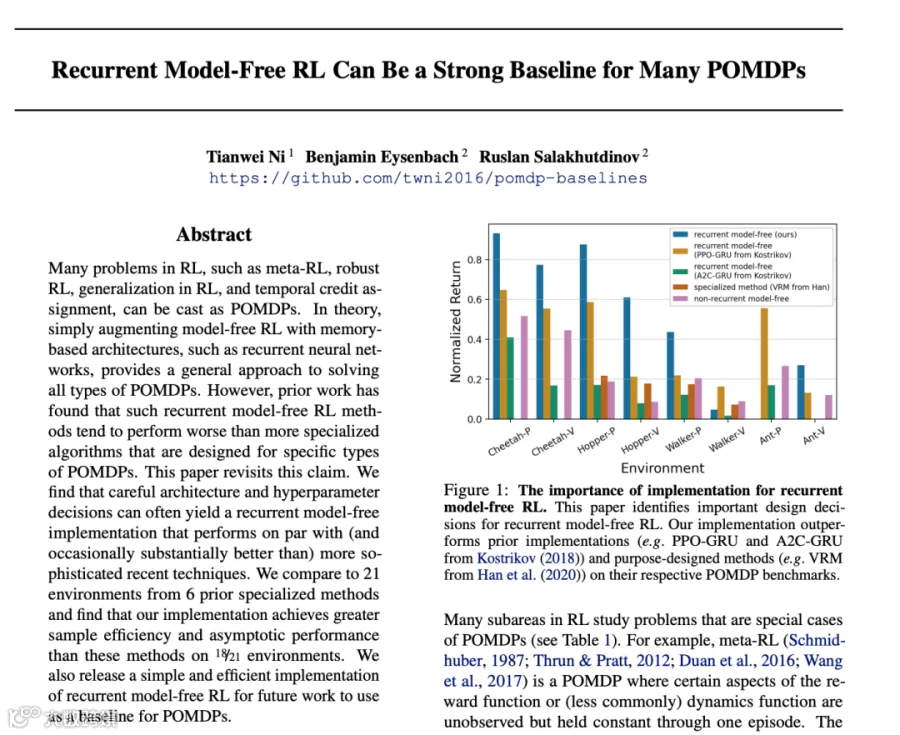
随后,他开始进一步拆解“历史信息到底该怎么用”。
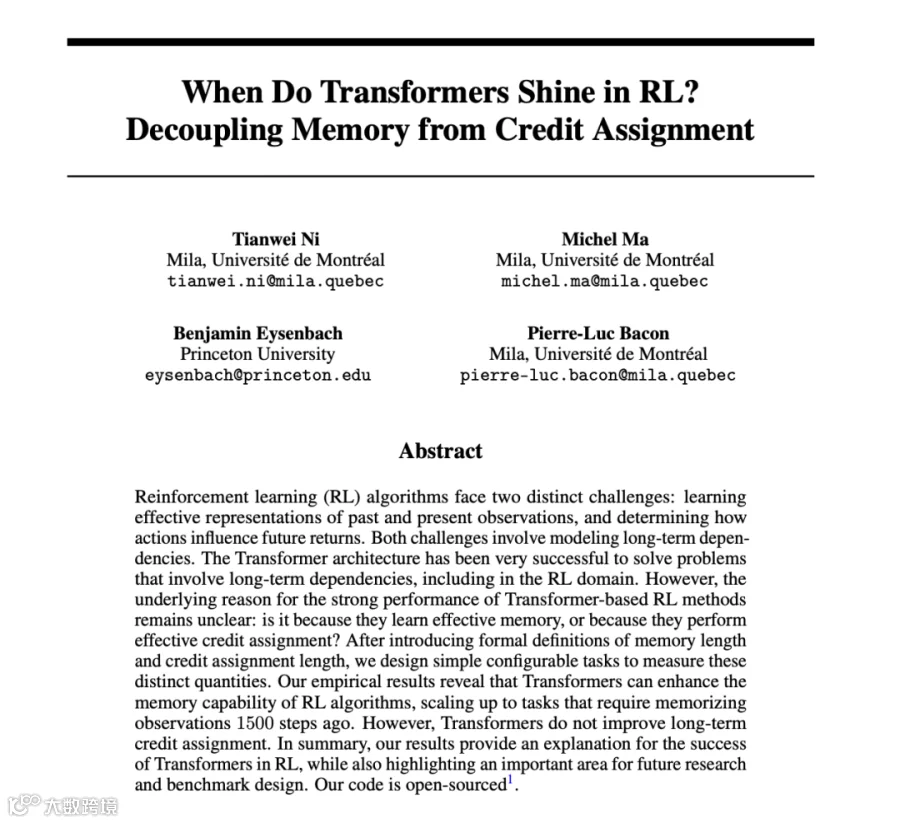
2023 年 NeurIPS Oral 论文《When Do Transformers Shine in RL? Decoupling Memory from Credit Assignment》。重点区分了强化学习中的记忆(memory)与信用分配(credit assignment)问题,研究 Transformer 在什么类型的长时序任务中真正具有优势。
2024 年 ICLR 的工作则进一步转向状态与历史表示学习,尝试统一理解 MDP 和 POMDP 中的表示问题,并研究自预测表示在不同环境中的作用。

博士后期,他的研究进一步扩展到智能体如何利用新的经验持续适应。
其中一条研究线转向 offline-to-online RL。从“稳定性—可塑性”的视角研究策略在线微调过程中如何既保留已有能力,又根据新经验继续学习。
2026 年,他又进一步提出 Adaptive Policy Prior 的思路,主张重新思考传统 Offline RL 的目标:与其从静态数据中训练一个部署后不再变化的策略,不如学习一个能够作为后续在线学习起点、并随着新经验继续适应的策略先验。

从记忆、表示,到适应性,倪天炜的研究也逐渐从传统强化学习走向更复杂的智能体问题。
如今,他也将在 Google DeepMind 继续围绕强化学习、持续学习,以及 LLM Agent 的自进化展开研究。
END
关注+星标,获取AI前沿进展与开源一线动态