


H700预处理上位机与高质量数据组织
AWEAR 手套与 EGO 第一视角设备可以共同记录人的操作过程。要让这些记录进入具身模型和世界模型,还需要做好五件事:多设备时空同步、关键事件标注、冗余控制、多操作者与版本管理,以及面向训练的快速读取。
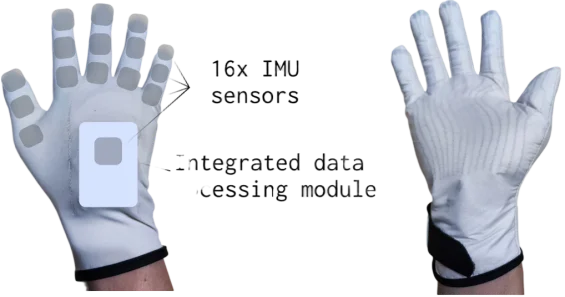
AWEAR多模态采集手套

EGO全场景采集眼镜
H700 位于采集设备之后,作为运行 Studio 和本地处理服务的预处理上位机,将分散的记录整理为可复核、可导出的数据。Harbor 承接集中协作与版本发布,训练环境完成模型适配和样本组装。以下讨论这一数据链路的组织思路,具体能力需按设备与模型配置验证。
01 H700将设备记录整理成数据片段
EGO 提供操作环境与可见过程,AWEAR 补充手部运动和已配置的触觉观测。采集层保留原始信号,处理层再生成骨架、轨迹和事件标签。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
惯性姿态不直接等于手腕的全局位置,触觉原始值也不直接等于接触力。轨迹重建和力值解释分别需要定位约束与传感器标定,不能将模型估计混作设备实测。
H700 接收实时数据或导入设备记录,完成本地存储、同步检查、标定应用、清洗与预标注。Studio 提供配置、回放和人工修订界面;较重的任务可以交给中心计算资源。复核后的数据既可上传 Harbor,也可直接导出到本地训练环境。
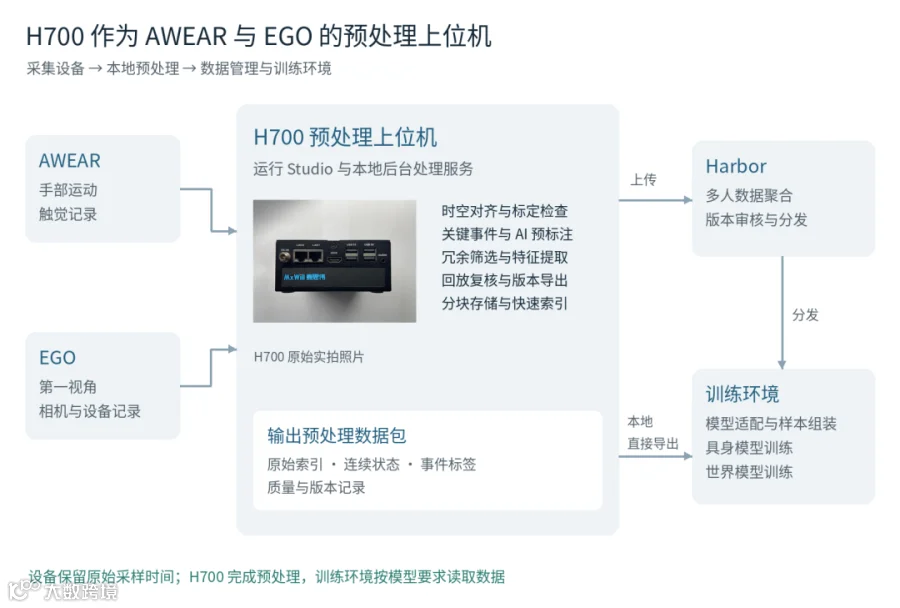
图 1 H700 承接现场预处理,Harbor 管理多人数据与发布版本。图中设备为原始实拍照片,箭头表示逻辑数据流。
02 时空同步决定多设备数据能否相互解释
1. 时间同步需要覆盖整段采集。 各设备应保留原始采样时间,H700 记录时钟偏移、漂移及统一时间映射。仅在开始时对齐一次,无法保证长时间记录仍然同步;设备重启、掉帧和通信中断也需要标记。
例如EGO视频为 30 Hz、多模态手套为 200 Hz,只是一个假设配置。两者必须按时间配对,不能按记录行号对应。软件收到数据的时刻也不能默认作为采样时刻,否则传输抖动会混入动作时间。
2. 空间同步需要明确每个量属于哪个坐标系。 相机、手腕、手指和场景之间的转换关系,应连同单位、骨架定义、标定版本与误差一起保存。EGO 随头部运动时,相机相对环境的姿态会变化,不能一直使用初始相机外参。
EgoDex 将视频与骨架变换、相机参数及置信度配对保存,并说明世界坐标原点不保证跨片段一致。[1] 对 AWEAR+EGO,同样需要把“记录时间一致”和“空间含义一致”同时做好。
03 关键时刻要标出状态发生变化的边界
“拿起杯子”是一段过程,真正影响动作学习的往往是几个节点:手离开桌面、手接触杯体、杯子离开支撑面、抓持稳定,以及释放。它们对应不同状态,不能合并成一个笼统的成功标签。
以“手离开桌面”为例,先明确是哪只手、哪个部位与哪一个支撑面分离,再用几何关系、可见变化或相应触觉证据判断。短暂遮挡属于不确定状态,不能直接判定已经离桌;手离桌与杯子离桌也必须分开标注。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
事件可以由变化检测或模型提出候选,再由规则与人工复核确认。应保留事件前后的连续窗口,而非只抽出一张“关键帧”。按 30 Hz 视频判断边界时,单靠画面不能声称毫秒级定位精度。

图 2 以一次包含上述阶段的取杯动作为例。事件顺序按实际任务记录,不作为所有操作的固定模板
04 降低冗余要保住交互细节与场景线索
视频里确实包含大量重复信息,可以从三个层面减少处理负担。编码层压缩相邻画面的重复内容;样本层减少长时间静止和高度重复片段的采样;特征层提取手、操作物体及其关系,供特定模型使用。
这些方式影响不同。视频编码通常保留完整时间轴,而抽帧、裁剪和特征提取会改变训练输入。建议保留原始记录,另行生成低分辨率代理视频、局部区域和模型特征,并保存回到原始片段的索引。
接触、离桌、滑落、重试等事件附近,应保留足够的时空细节。稳定阶段可降低训练采样密度,但要保留实际时间间隔,不能将不等间隔的帧伪装成等间隔动作。
背景也不全部是冗余。桌面、障碍物和支撑关系可能影响操作,世界模型还需要学习环境变化。可同时保留全景与操作区域视图,由训练任务选择;不能只剩手部骨架,就认为已经完整描述了交互。
05 多人数据要保留差异 多版本数据要能够追溯
不同操作者的手型、速度、习惯和补救策略可以增加数据覆盖。聚合时需要统一字段、单位、坐标与事件规则,同时保留操作者编号、个体标定、场景和设备配置。不同人的动作无需平均成一条“标准轨迹”。
同一任务可以保留不同执行方式,但质量筛选应按场景、操作者和失败类型分别检查,避免样本最多的人或场景主导训练。多人参与标注时,则需要通过重叠样本检查一致性,对关键分歧复核裁决,而不是简单叠加标签。
版本至少区分原始记录、算法处理结果、人工修订和发布数据集。每次发布固定样本清单、标签版本、标定与模型版本,以及训练集划分;后台重新处理不覆盖已发布结果。来自同一原始片段的裁剪、重标注和重定向版本应归在同一数据划分中,防止泄漏。
H700 保存现场处理记录,Harbor 聚合多设备、多操作者与多轮修订,维护来源关系和发布清单。高质量由一致规则、覆盖与复核共同决定,版本数量本身不代表质量提升。
06 存储要围绕模型如何取数据来组织
训练通常只读取某个片段中的一小段时间、几路传感器或某类事件。存储设计需要让这些数据能够被定位和局部读取,避免每次都扫描或解码整段记录。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Parquet 配合 Arrow 可以按列与条件读取;Zarr 的块形状决定独立读取的数据单元。[7][8] 视频则需要权衡压缩率与随机访问成本:关键帧间隔较长可能增加定位后的解码工作,LeRobot 也提供相关编码配置。[9]
例如检索“某类杯子离桌前后的一段数据”,应先通过事件与版本索引定位片段,再同时读取对应视频、手部状态和触觉窗口。H700 可承担近期数据、索引与热缓存,长期归档交给独立存储或数据中心。
这里既要避免巨型文件,也要避免大量碎片小文件。最终以训练加载器的随机窗口读取延迟、吞吐和缓存表现验证,而不能只看硬盘顺序读写速度。
07 按模型目标导出 才能形成可训练样本
经过上述处理,一次任务尝试可形成一个操作片段,关联原始记录、连续状态、事件和质量信息。模型适配器再根据训练目标,选择字段、时间窗口、图像尺寸与动作表示。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
人类轨迹进入机器人策略前,还需要本体映射、视角适配和执行验证。重定向目标与机器人真实执行记录分别保存。世界模型若以动作作为条件,也必须明确该动作属于人类运动还是机器人控制,不能混用。

例如一个自定义实验使用历史 4 帧、后续 16 步:图像可组织为[B,4,3,H,W],状态为[B,4,D],机器人动作目标为[B,16,A]。B 是批量大小,D 和 A 分别为明确约定的状态、动作维度;这些只是示例配置。
对于动作条件预测,aₜ 对应 oₜ 到 oₜ₊₁ 的变化,之后的观测作为监督目标。未来观测和事后结果不能混入策略执行时的输入;缺失与补齐通过掩码处理,训练窗口不跨越片段边界。
LeRobot 和 RLDS 提供数据组织方式,但仍需匹配具体模型的版本与字段。[2][3] GR00T 明确配置视频、状态、动作和语言,Cosmos 的动作条件预测示例也使用对齐的视频与机器人动作。[4–6] 数据包中有触觉列,并不意味着模型会读取它,仍需相应编码接口或监督设计。
最终应在训练端实际读取一批样本,检查时空对应、动作单位、归一化和掩码,再完成前向计算与损失检查。训练、验证与测试按操作者、场景或采集会话隔离,归一化统计仅从训练集计算。
AWEAR+EGO 负责记录交互,H700 将记录整理为可追溯的数据,Harbor 组织多人协作与版本发布。时空关系可信、关键节点清楚、冗余可控且能够快速读取,才让采集规模转化为模型能够利用的数据规模。
关注 芯动力AI,我们会继续分享 大模型、Agent 和具身智能等方面的相关信息。
参考资料
[1] EgoDex:https://github.com/apple-aiml-research/ml-egodex
[2] LeRobotDataset v3:https://huggingface.co/docs/lerobot/lerobot-dataset-v3
[3] RLDS:https://github.com/google-research/rlds
[4] GR00T:https://github.com/NVIDIA/Isaac-GR00T
[5] GR00T 数据配置:https://github.com/NVIDIA/Isaac-GR00T/blob/main/getting_started/data_config.md
[6] Cosmos 动作条件预测:https://github.com/nvidia-cosmos/cosmos-predict2.5/blob/main/docs/post-training_video2world_action.md
[7] Arrow 数据筛选:https://arrow.apache.org/docs/python/dataset.html
[8] Zarr 分块性能:https://zarr.readthedocs.io/en/latest/user-guide/performance/
[9] LeRobot 视频编码:https://huggingface.co/docs/lerobot/main/video_encoding_parameters