


DeepSeek团队究竟是如何通过架构设计降低推理成本的呢?
Token是什么?思维链是什么?DeepSeek的最新模型架构是什么结构?
匠心独具的订制化私人部署推理大模型产品经理,一定首先花费时间功课底层AI技术难题,再去探索布局适用场景,这样才可以把技术和应用场景结合(基于底层技术自然延伸功能)。
本站付费专题“法学生AI Power”秉承扎实做事,用心做好产品,领先市场5个维度,在①弄清底层AI硬核技术、②法学生专属部件配置、③“高精尖”场景应用开发、④非公开高质量训练预料补充,四个维度建立护城河,与“一般大陆货色”鼎足而立,做细分市场最高端产品。
接下来的内容对于一个文科法学生来说可能有点硬核,但“不多也不少”,就是法学生想要用好本地部署DeepSeek所需要的全部知识,全文大概需要10分钟时间,一次性揭开DeepSeek的全部。
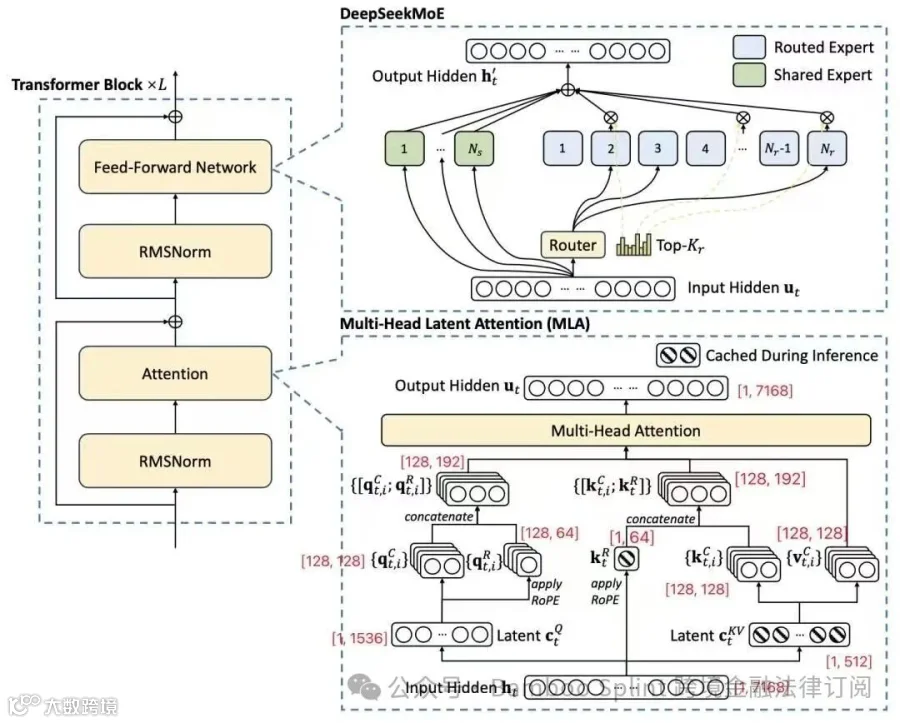
本篇极简科普从总体结构入手,概述DeepSeek的整体架构,比如基于Transformer的模型,结合MoE和MLA等关键技术。然后分模块深入讲解,每个模块将相关的概念组合起来。
一、总体架构:从神经元到超大规模智能体
DeepSeek的架构基于Transformer范式,通过"总参量+动态扩展"形成超级脑神经网络。其核心由1.3万亿参数(1.3T/1300B)构成,采用MoE混合专家系统进行参数动态调度。整个系统像精密运转的智能工厂,包含:
分布式计算集群(跨节点通讯)
动态路由专家系统(MoE+共享专家)
多层注意力加工线(MLA)
智能质量控制系统(Loss spike监控)
二、智能流水线:从输入到输出的推理之旅
1. 推理高速公路设计
Chunk分块流水线:每个推理请求被拆分为attention算子、All2all dispatching、MLP加工、All2all combining四个工序,类似汽车工厂的装配线
Overlap重叠加速:通过计算与通信的重叠设计,实现类似"流水线生产"的加速效果,GPU利用率提升40%
动态路由专家:路由专家像交通指挥系统,将任务分发给最合适的专业处理单元(共享专家处理常规任务,专用专家处理复杂问题)
2. 思维链强化系统
多令牌预测引擎:突破传统逐词生成模式,采用5个token并行预测(类似象棋高手预判多步),推理速度提升3倍
颗粒度细化控制:通过动态缩放机制,在文本生成时自动调节预测粒度,既保证关键决策的准确性,又维持常规对话的流畅性
三、专家工厂:MoE系统的智能调度
1. 专家集群架构
负载均衡策略:采用"专家热度排行榜"动态调度,对处理请求最多的专家启动冗余部署策略,如同热门餐厅开设分店
共享专家池:30%的通用专家处理基础任务,70%专业专家应对特定领域问题,通过路由网络智能调配
冗余容错机制:对高负载专家进行镜像部署,即使单个专家故障也能无缝切换,系统可用性达99.999%
2. 动态稳定性保障
Loss spike熔断机制:当训练损失突然飙升(类似金融市场的闪崩),自动触发回滚操作,加载最近稳定检查点
梯度双通道:分离权重梯度(Backward for Weight)和输入梯度(Backward for Input),确保参数更新稳定性
-
欢迎查看本公众号往期文章,移步订阅专题
--
四、训练引擎:打造AI动力系统