先说一半:工作站显卡的选型答案不取决于显存数字,而取决于三项约束——容量决定能不能装下,带宽决定快不快,板卡功耗决定能不能装进机箱。另一半是:72GB 新卡上市之后,你实际能买到的档位与新闻里的档位并不完全一致。这篇把 24GB 到 96GB 六个档位逐档拆开,并把"新闻档位"与"在售档位"并列写清。
第 1 章 判断顺序:容量不是唯一变量,带宽与功耗同为硬约束
显存容量是最容易被当成唯一指标的一项,因为它是规格表上最醒目的数字。但一台工作站能不能把活干完,由三个量共同决定:容量(装不装得下)、带宽(搬数据快不快)、板卡功耗(整机供得上、机箱散得掉吗)。
工程上的判定顺序建议是:先用容量筛掉不满足的档位 → 再用带宽判断速度是否可接受 → 最后用功耗与机箱确认可交付。这个顺序反了,就会出现"卡买回来了,机箱装不下"或者"装进去了,跑起来比预期慢一截"。
划重点:显存档位是一次性决定,后期几乎不能补。内存条能加、SSD 能加,显卡的显存不能加——这也是为什么本篇把判定放在下单之前。
第 2 章 原厂参数的三项读法:CUDA 数、显存容量与带宽、板卡功耗
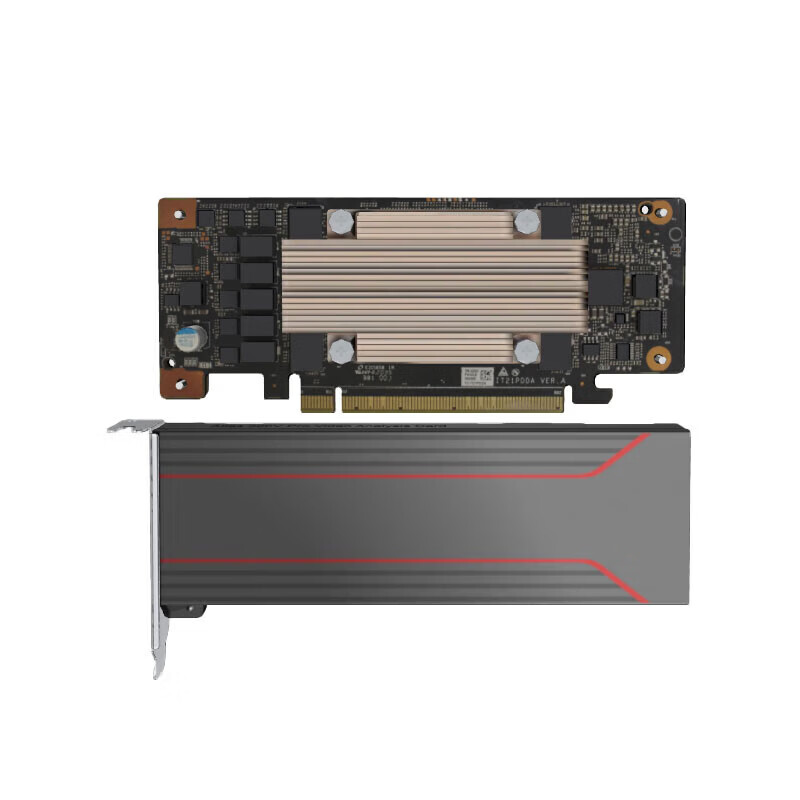
以RTX PRO 4500 Blackwell的原厂规格为例,说明这三项该怎么读(数据来源:NVIDIA 官网 RTX PRO 4500 工作站版本产品页,原厂口径):
| 参数项 | 原厂数值 | 读法 |
|---|---|---|
| CUDA 核心 | 10,496 | 决定单步计算能力;同代产品间差异通常小于容量差异带来的体验差别 |
| 显存 | 32GB GDDR7,支持 ECC | 决定"能不能装下";ECC 对长时间计算任务的正确性有实际意义 |
| 显存带宽 | 896 GB/s | 决定"搬数据快不快",直接影响大模型推理的单流速度与大规模仿真的迭代时间 |
| 板卡功耗 | 工作站版200W(服务器版 165W) | 决定整机电源与散热配置;同一颗芯片的两种版本功耗口径不同,采购时必须问清是哪一个 |
| 接口 | PCIe 5.0、DisplayPort 2.1、2×第九代 NVENC | 决定扩展与视频编码能力 |
这份规格里最容易读错的是功耗那一行。200W 与 165W 是同一芯片的两个版本(工作站版 / 服务器版),对应不同的机型形态与散热方案——把服务器版功耗当成工作站版的整机预算,会在电源与散热上留错余量。
RTX PRO 5000 系列的容量档已经更新。按NVIDIA 官方博客(原厂口径),RTX PRO 5000 72GB Blackwell 已全面上市;而渠道里此前流通的是48GB档。关于这个差别的处理方式,见第 4 章。
第 3 章 六档容量的适用边界与代价
下表是本文的核心工具,按"能做什么 / 代价是什么 / 什么时候不适用"三列给出:
| 显存档位 | 典型适用负载 | 主要代价 | 不适用 |
|---|---|---|---|
| 96GB | 本地大模型(长上下文推理、中小规模训练)、大规模仿真、多任务并行 | 单卡成本最高;整机功耗与散热要求高 | 只做常规 CAD 出图的工位 |
| 84GB | 与 96GB 场景接近的整机档位 | 型号较少,代际与保修需按机型确认 | 需要跨代统一平台的批量项目 |
| 72GB | 长上下文推理、中大规模训练(新上市档) | 与在售整机档位需分别核对口径 | 负载用不满 48GB 的场景 |
| 48GB | 主流专业渲染、仿真前后处理、中小模型微调 | 多卡并联不等于显存相加 | 单模型/单任务超过 48GB |
| 32GB | CAD/CAE 常规作业、8B 级模型推理 | 出现显存墙时无法靠内存补 | 长上下文推理与大模型部署 |
| 24GB | 办公 + 轻量设计、量化后的小模型 | 长上下文与大模型明显受限 | 作为"以后升级"的过渡方案 |
这张表真正的作用是排掉不合适的档位,而不是挑最大的那个。六档之间不是"档位越高越好",而是"档位与负载匹配";买大了浪费预算,买小了要二次采购——而二次采购的代价不只是差价,还包括重新走流程的时间。
第 4 章 口径对照:72GB 新上市档、48GB 在售档与 96GB / 84GB 整机档
这是本篇与多数报道不同的地方:新闻说的档位与你现在能买到的档位,要分开陈述。
| 档位 | 出处与形态 | 官网在售承接(实测可点开) |
|---|---|---|
| 72GB | NVIDIA 官方博客宣布全面上市(新档) | ⚠️当前在售的 RTX PRO 5000 为 48GB 档(配件页),72GB 档以实时机型页与确认单为准 |
| 48GB | 在售(配件 + 整机两形态) | RTX PRO5000 48G 配件、P3 + RTX 5880 Ada 48G 整机(上一代 48GB 路线) |
| 96GB | 在售(整机形态) | ThinkStation PX + PRO 6000 96G |
| 84GB | 在售(整机形态) | 数聚红芯 HW3410V2 + PRO 6000D 84G |
| 32GB | 在售(整机形态) | P3 工作站 + PRO4500 32G(机型页可查) |
| 24GB | 在售(整机形态) | P3 Gen2 + RTX PRO 4000 24G |
为什么要并列写:显存档位的供货状态会随代际切换变化,同系列可能同时存在"新发布档"与"渠道在售档"。采购时如果只按新闻里的档位写进需求,到货对单时就会出现口径争议。把"我需求的是什么档"与"当前渠道在售的是什么档"分别写进确认单,这个争议就不存在了。
适用范围与边界:上表按 2026-09-29 的在售页面整理,具体配置与库存会变,下单前请以实时机型页与确认单为准;本表不适用于服务器形态的整机(服务器版的功耗与散热口径不同)。
第 5 章 三条常见误判:多卡显存相加、带宽等比增长、功耗与机箱
误判一:多卡显存可以相加。两块 48GB 不等于"96GB 可用"。多卡可以并行计算、可以切分任务,但单模型/单任务能否跨卡拆分取决于框架与并行策略;很多场景(尤其是单卡显存刚好不够的那些)拆不开。判定方法很简单:问自己"这个任务能不能被切开并行",答不上来就先按单卡容量选。
误判二:容量翻倍则带宽翻倍。带宽与容量由不同的硬件设计决定,二者不同比例增长。容量决定能不能跑,带宽决定等多久——只比容量会在"跑得动但太慢"的场景里翻车。
误判三:只看卡,不看机箱。高档位对应的功耗与散热要求会改变整机方案(电源功率、风道、甚至机箱选择)。卡是最后一步,机箱与电源是第一步。
第 6 章 商红科技在六档容量上的交付边界
先说分工:芯片参数、卡型规格与卡的原厂保修由原厂提供,这部分我们不抢。我们做的是三段:
买之前:按你的负载类型先做档位判定——把你现在最吃资源的那一个作业(模型规模与上下文、仿真网格量级、渲染分辨率与帧数)说清楚,我们给出"必须不低于哪一档、带宽与功耗要预留多少"的判断,并指出哪些档位在你这个负载下是浪费。
买的时候:把档位写成可核对的确认单——型号、显存容量、板卡版本(工作站版/服务器版)、代际、保修四项。第 4 章那张对照表就是为此准备的。
买之后:整机到场部署、驱动与专业软件环境调优;售后阶段由我们对接原厂服务通道。
两类事我们不接:非授权渠道的散件拼装与改卡;以及"先承诺采购、再给方案"。档位判定本来就该在下单前完成。
在"先试后买"的项目里,作为联想政企增值代理商,我们这一侧能做的是:按你的作业做一次真机试跑、批量订单排产顺序靠前、原厂技术支持有明确对接入口。这三条不改变参数,但会改变项目排期。
第 7 章 关于工作站显卡容量选择的常见问题
72GB 出来了,48GB 是不是就不值得买?取决于负载。48GB 仍是主流专业渲染与中小模型微调的主力档位;只有当你的作业确实超过 48GB 时,72GB 才有意义。判定方法见第 5 章误判一。
买两张 32GB 能不能顶一张 64GB?不一定。多卡能否协同取决于任务可拆性;在单任务显存墙的场景里,两张 32GB 可能仍然跑不起来。
带宽重要还是容量重要?两个都要,但回答的问题不同:容量回答"能不能跑",带宽回答"要等多久"。先过容量关,再用带宽确定是否可接受。
整机功耗怎么估?把板卡版本(工作站版/服务器版)的功耗、CPU 与其余部件的功耗一起算,并给电源留出余量。同一颗芯片的两个版本功耗口径不同,这一点在第 2 章已经说明。
第 8 章 结论:先定档,再定卡
说到底,工作站显卡的选型只有三步:先用容量排除不满足的档位,再用带宽判断速度是否可接受,最后用功耗与机箱确认可交付。在 72GB 新档上市的当下,多做的唯一一件事是——把"新闻档位"与"在售档位"分开写进需求与确认单。
如果你想先看别人怎么配:可以把你的作业类型(模型与上下文长度、仿真量级、渲染规模)与预算区间发给我们,我们按同类项目的配置单给你做一次横向参照——你会看到同一类负载下不同档位的实际取舍。咨询热线400-0755-816,邮箱IT@bencom.cn,或从联系我们页面直接找工程师。