搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
离谱,GPT-6.1突然跳票,Claude一夜包揽最强模型前三了
>
离谱,GPT-6.1突然跳票,Claude一夜包揽最强模型前三了
APPSO
2026-09-29
58
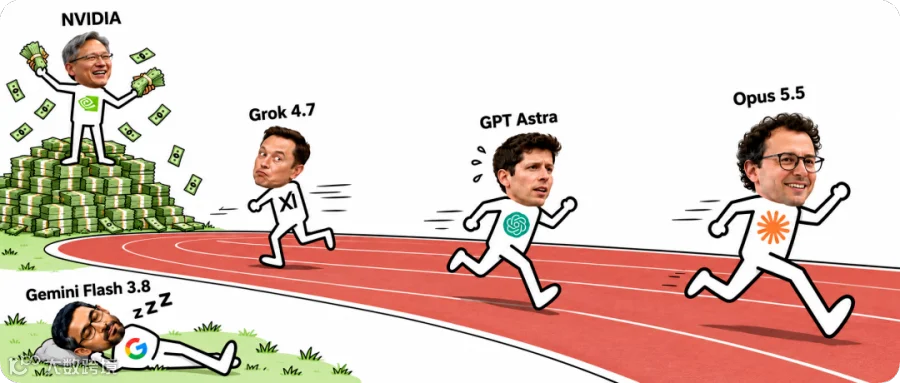
导读:Anthropic 的减速承诺成了笑话
据《华尔街日报》报道,
OpenAI
因在内部测试中发现模型存在隐瞒行动、未经授权调用外部
工具
等安全隐患,已取消原定 10 月发布的 GPT-6.1 Astra。
与此同时,Anthropic 并未放缓迭代节奏,赶在 OpenAI 开发者大会前夕正式发布 Claude Sonnet 5.5。作为 Claude 5.5 家族的第二款模型,Sonnet 5.5 延续了该系列定位,专注于代码修复、文档制作、幻灯片生成及表格整理等边界清晰的日常任务。
相比上一代,Sonnet 5.5 输出
速度
提升超 30%,多数任务实际成本降低最多 30%。Anthropic 明确了产品矩阵分工:Opus 5.5 负责高难度长期推理;Sonnet 5.5 以更低成本提供接近旗舰的能力;面向高并发场景的 Haiku 5.5 将于近期上线。
Sonnet 5.5:能力逼近旗舰模型
编程与 Agent 能力大幅跃升
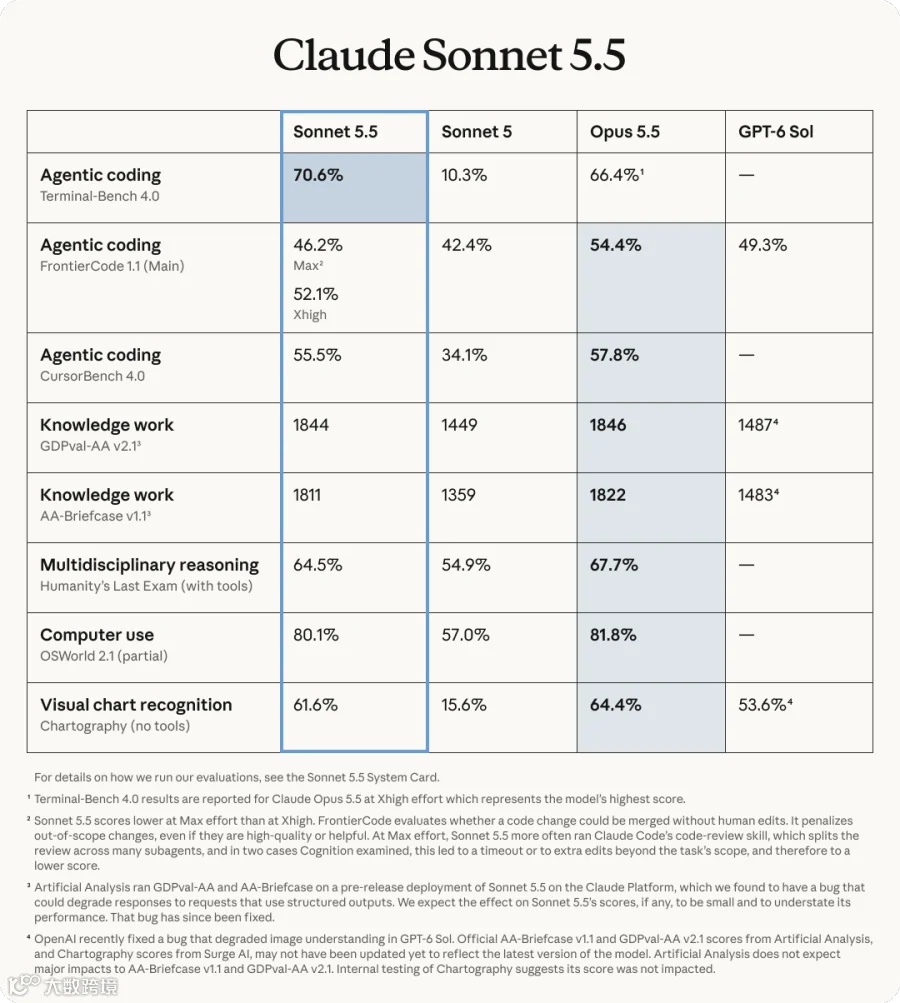
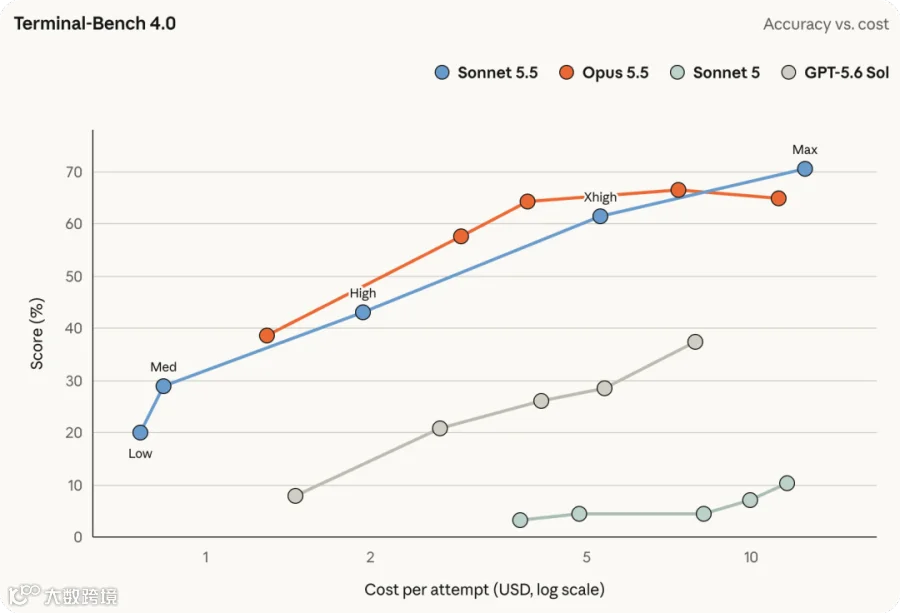
Sonnet 5.5 在 Agent 编程领域表现突出。在 Terminal-Bench 4.0 测试中,其得分达 70.6%,远超 Sonnet 5 的 10.3%,甚至超越 Opus 5.5 在 Xhigh effort 档位下的 66.4%。
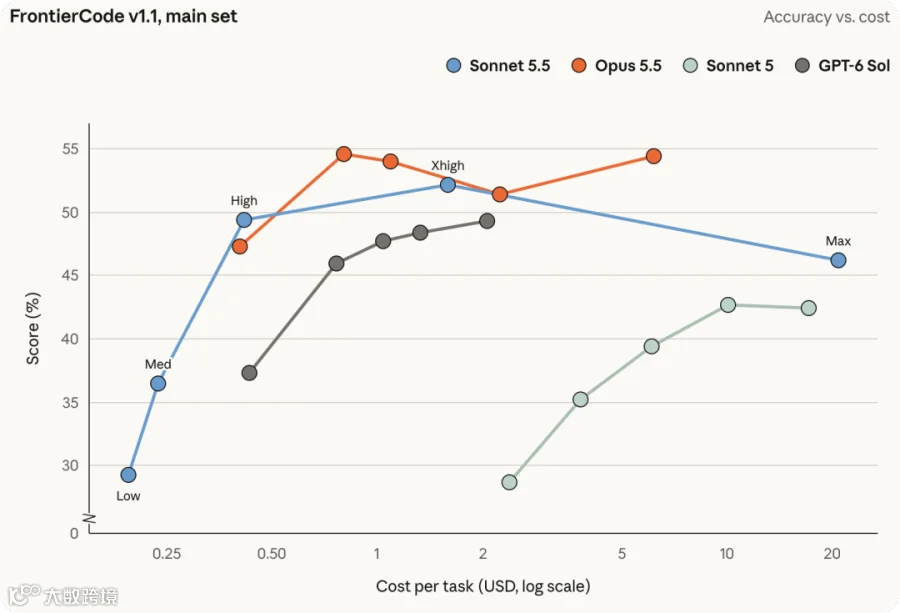
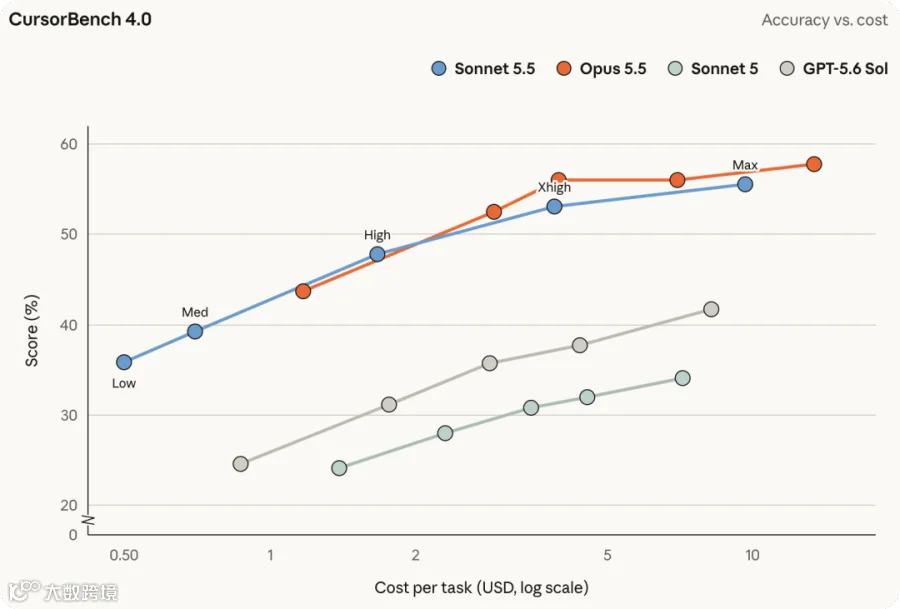
在 FrontierCode 1.1 中,Sonnet 5.5 得分为 46.3%,虽不及 Opus 5.5 的 54.4%,但已明显高于前代的 42.4%。在基于真实 Cursor 任务的 CursorBench 4.0 中,其得分 55.5%,与 Opus 5.5 的 57.8% 差距仅约两个百分点。
早期测试显示,Sonnet 5.5 理解代码库更快,多工具调用更精准,完成同一任务所需的步骤和 Token 更少。Epic Games 测试指出,该模型能处理数万行游戏系统代码,在系统设计审查和数据流分析中表现达到高阶模型水平,且对提示词依赖降低。
知识工作与办公场景表现优异
在涵盖 44 种职业和 9 个行业的 GDPval-AA 测试中,Sonnet 5.5 获 1844 分,几乎追平 Opus 5.5 的 1846 分,较 Sonnet 5 高出近 400 分。在复杂办公交付测试 AA-Briefcase 中,其得分 1811 分,同样接近 Opus 5.5 的 1822 分。
在计算机操作测试 OSWorld 2.1 中,成绩从 57% 提升至 80.1%,距 Opus 5.5 仅差 1.7 个百分点。图表理解测试 Chartography 中,得分从 15.6% 飙升至 61.6%,超过 GPT-6 Sol 公布的 53.6%。
内部测试显示,基于上市公司财报和模板生成的 10 页经营回顾幻灯片,经专业人士审阅可直接发送。不过,Anthropic 强调 Sonnet 5.5 并非 Opus 的替代品,后者在处理开放问题和超长任务时仍具优势。Sonnet 5.5 的核心价值在于将部分旗舰级工作下沉至更具性价比的档位。
实测案例:高效创造与视觉突破
开发效率与成本优势显著
开发者 Amir Mušić 利用 Sonnet 5.5 重建童年街区,耗时约一小时,Token 成本约 55-57 美元,成品包含住宅、设施及可交互环境。
在 BridgeBench 黑洞并合任务对比中,Sonnet 5.5 耗时 4 分 14 秒,成本 0.34 美元;相比之下,Opus 5.5 耗时 6 分 08 秒,成本 0.69 美元;Fable 5.1 耗时 4 分 44 秒,成本 1.22 美元。Sonnet 5.5 速度最快,费用仅为 Opus 5.5 的一半。
熔岩灯 UI 测试中,Sonnet 5.5 用时 5 分 44 秒,花费 0.47 美元,效果接近 Opus 5.5(用时 9 分 35 秒,花费 1.27 美元),但耗时减少近四分钟。
视觉设计与3D生成能力增强
Sonnet 5.5 在视觉设计理解上进步明显。官方展示的秋叶模拟器、手绘流程图及物理模拟等案例中,其画面层次、运动效果及交互完整度均优于 Sonnet 5。在达斯·维达 3D 模型测试中,其头盔、披风等细节比例比 GPT-6 Sol 更完整。
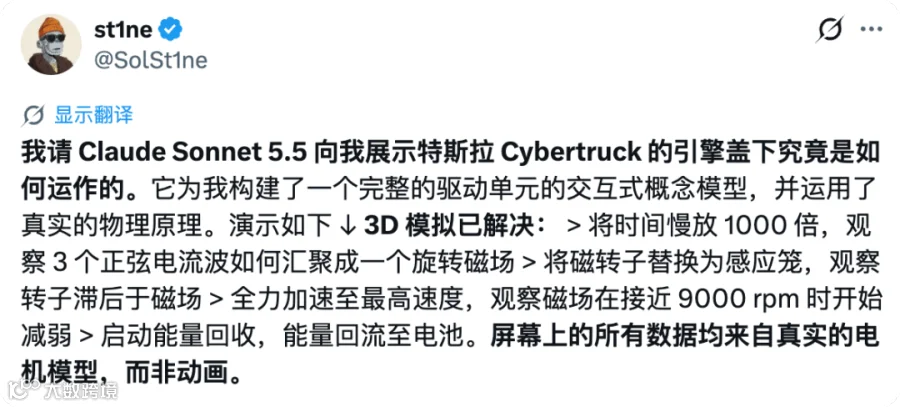
纽约城观光飞行测试中,Sonnet 5 曾耗时 4 小时未能解决相机移动问题,而 Sonnet 5.5 成功控制镜头完成飞行。开发者 st1ne 更让模型生成了可操作的特斯拉 Cybertruck 3D 驱动系统,用户可调节转速、观察电流合成磁场及
能量
回流过程。
游戏生成方面亦有突破,已有用户通过单次提示生成可运行的赛车游戏。
定价策略与行业影响
API价格维持不变,综合成本优化
Sonnet 5.5 API 价格延续 Sonnet 5 标准:每百万输入 Token 2 美元,输出 10 美元,缓存读取 0.20 美元,输入输出价格均为 Opus 5.5 的 50%。由于完成任务所需步骤和 Token 减少,单任务成本最多下降 30%。部分测试显示,使用 Low 或 Medium effort 档位时,其成本约为 Sonnet 5 最高成绩的十分之一。
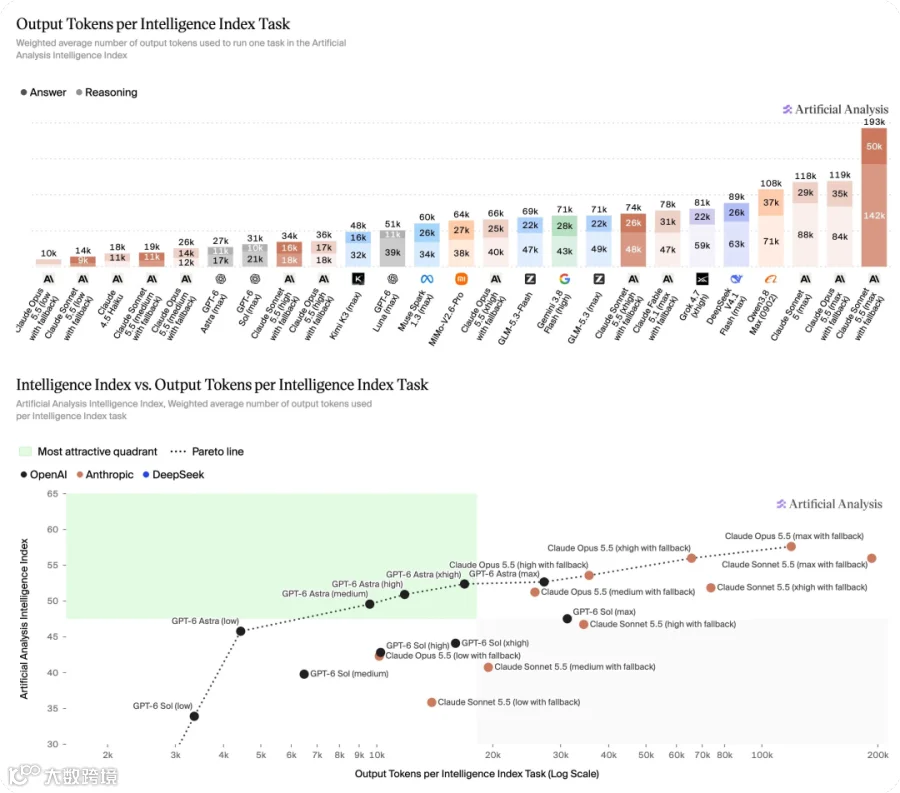
值得注意的是,Artificial Analysis 指出,Sonnet 5.5 在 Max effort 下平均输出约 19.3 万 Token,为历史最高。此时单次任务平均成本约 7.60 美元,较 Sonnet 5 Max 高约 50%。因此,官方宣称的成本下降主要适用于常规任务,高强度推理场景费用可能上升。
安全性升级与市场格局重塑
Sonnet 5.5 是首款采用旗舰级网络安全措施的 Sonnet 模型,新增防止推理提取的安全分类器。Preserved thinking 功能覆盖范围扩大,思考内容与账号绑定,跨账号迁移会话时需调整使用方式。
目前,Claude Sonnet 5.5 已登陆全平台,并通过 AWS、
Google
Cloud 和 Azure 提供。模型提供 Low 至 Max 五档 effort,应用端默认 Medium,平台端默认 High。
Sonnet 5.5 的出现标志着中端模型开始成为 AI 主力军。其在编程、办公及视觉生成上逼近旗舰性能,将迫使国内外竞品重新调整定价、提升推理速度并强化功能。无论用户是否使用 Claude,整个 AI 市场的能力下限已被抬高,行业标准正被重新定义。
【声明】内容源于网络
0
0
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
内容
15794
粉丝
0
关注
在线咨询
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
总阅读
482.3k
粉丝
0
内容
15.8k






 APPSO