

01
引言
最近,TypeSafe AI 推出了 Jev 模型,官方将Jev 定义为首个公开的 System One Model:输入一段非结构化状态和一组预先声明的问题,输出的不是文章、代码或聊天回复,而是软件可以直接使用的类型化判断,以及相应的概率和置信度。这是一个跳过文本生成的新模型,性能比前沿模型最高快 200 倍、便宜 400 倍。人们已经称它为“未来”了。
作为一名独立开发者,我最大的问题是前沿模型不断上涨的成本。许多其他开发者也有同感。去社交媒体上看看那些骂声吧。事实上,OpenAI 在 token 管理方面需要大幅改进。Anthropic 也一样。我们不断为成千上万的输入 token 和冗长的对话输出 token 付费。
说实话,我并不太在意速度。就我的编码使用场景而言,编程模型已经足够快了。但是成本已经完全不可接受了。这就是为什么我觉得 Jev 是一个非常有趣的模型。它承诺了我一直渴望的最大优势:结构化决策的近乎零成本。
我花时间深入研究了它的架构、基准测试以及早期开发者的反应。
02
JEV是什么?
Jev 是 TypeSafe AI 所称“System One Model”这一类别中的首个公开产品。该公司由 Diogo Almeida 创立,他曾是 OpenAI 研究员,参与过 InstructGPT 以及基于人类反馈的强化学习的早期基础工作。
“过去两年,我一直在秘密构建一种新的模型训练方式(RLCD),以及一种我们今天正式发布的新型前沿 AI 模型:Jev”
要理解这个模型为何存在,你必须看看它的名字以及背后的认知理论。
这个名字来自,19 世纪英国经济学家William Stanley Jevons,以杰文斯悖论闻名。1865 年,Jevons观察到,当蒸汽机让煤炭消耗效率大幅提升后,煤炭总使用量并没有下降,反而爆炸式增长。让一种资源变得极其便宜,就会让人们把它部署到所有地方。
TypeSafe 押注,完全相同的经济规律也会适用于软件决策。“System One”这个术语直接来自丹尼尔·卡尼曼在《Thinking, Fast and Slow》中的认知框架。
人类认知以两种档位运行。
系统 1 是快速、自动、潜意识且直觉化的。当你瞥见一张愤怒的表情,或回答二加二等于几时,你不会坐下来拿草稿纸演算。你的大脑会立刻浮现答案。
系统 2 是缓慢、分析性、深思熟虑且费力的。如果有人让你计算十七乘以二十八,你会停顿。你把中间状态保存在工作记忆中,然后一步步计算。
我们今天使用的每一个主要前沿语言模型,都严格表现得像系统 2。它们把推理过程说出来,按线性顺序一个词一个词地计算。
System 2 (Frontier LLMs):
Input Context -> Token 1->Token 2 -> Token 3 -> Verbose JSON Output
Cost: High ($3 - $15 per million tokens)
Latency: 3 to 15 seconds
System 1 (Jev Architecture):
Input State + Bounded Questions ->Single Parallel Forward Pass->Typed Probabilities
Cost: Near Zero ($0.042 per million input, $0 output)
Latency: 70 to 300 milliseconds
Jev 不会为你写文章。它不生成营销文案,也不会写你的下一个软件功能。它接收非结构化状态,针对该状态评估边界明确的问题,并返回带有校准概率的类型化决策。
03
工作原理
现代语言模型的技术瓶颈,在于 transformer 生成 token 的方式。
标准 transformer 是自回归的。如果你让一个聊天模型对一封客户邮件进行分类,模型必须把它的内部向量状态投影到超过 10 万个潜在 token 的词汇表上。
它采样一个 token,把这个 token 加回上下文窗口,然后再运行一次完整的、穿过数十层 GPU transformer 层的前向传播,只是为了预测下一个词。
如果你的模型生成一个 60 token 的 JSON 响应,你的硬件就要运行 60 次独立的串行传播。这个过程受内存带宽限制。第 40 步在物理上无法在第 39 步完成之前运行。
看看 Jev 与 LLM 的对比:
Jev 通过在推理开始前限制候选答案空间,打破了这种自回归循环。
Jev 不是在一个巨大的词汇表中预测开放式词语,而是针对已摄取的状态评估三种明确的类型化原语。
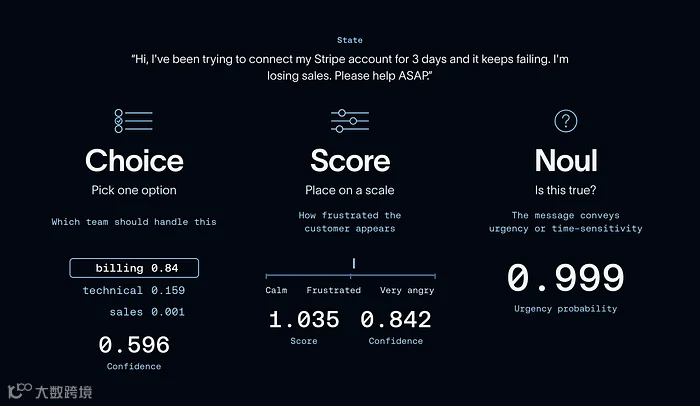
Choice:你提供一个问题和一组封闭选项,每次调用最多 255 项。Jev 会并行地根据这些选项评估输入状态,并输出获胜标签以及精确的置信度分数。
Score:你建立一个连续量表或有序评分标准,比如把客户情绪从 1 到 10 评分,或把技术债从低到严重分级。Jev 会把状态放在该量表上,并返回位置及置信度指标。
Noul:这是一个二元概率原语,Vercel 将其简单地呈现为布尔值。它判断某个特定条件为真还是为假,并返回一个介于 0.0 和 1.0 之间的原始浮点概率。
由于答案候选被严格定义,Jev 不会生成任意字符串。它会在一次单一的、并行的前向传播中,针对状态处理所有问题。
下面是一个易于理解的动画,展示 Jev 如何工作。
这种架构在 LocalLLaMA 子版块引发了一场争论。几位开发者指出,这种结构看起来与自然语言推理(NLI)完全相同,而这是研究人员多年前就通过在 BERT 或 RoBERTa 之上加分类头解决的经典 NLP 任务。
在一篇 Reddit 帖子中,有人声称自己一年前就用开放权重序列分类器搭建了完全相同的设置。
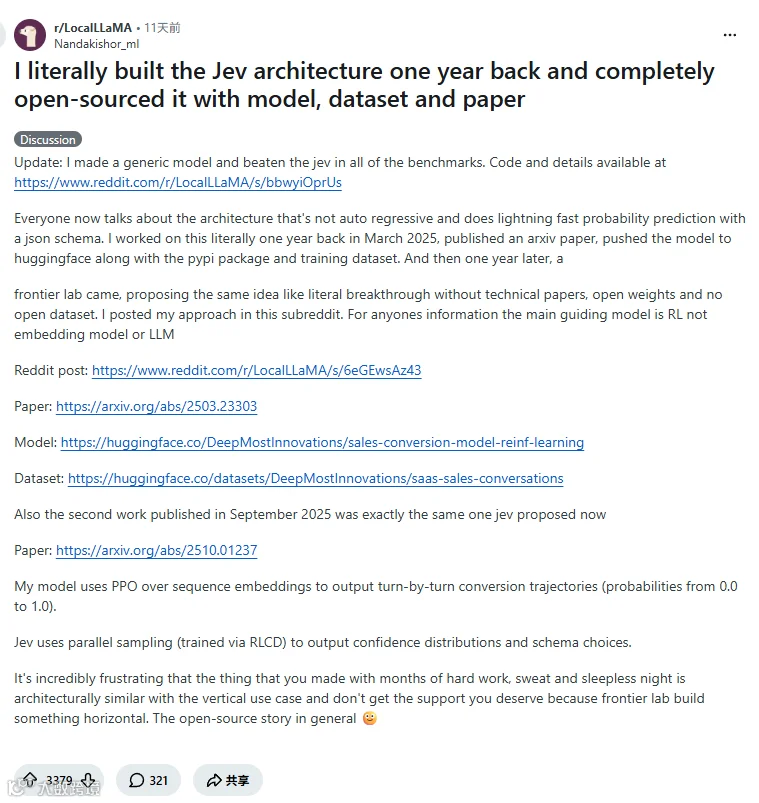
我检查了细节,发现它和 Jev 的工作方式几乎相似,但当然也有差异。微调一个本地 BERT 分类器,需要为每一次业务逻辑变更收集数百个带标签的训练对,托管专用端点,还要解决模型漂移。Jev 将前沿级零样本推理带到任意程序化问题上,而不需要自定义数据集或重新训练。
另一个有趣的细节是 TypeSafe 如何训练这个模型。
他们抛弃了传统的基于人类反馈的强化学习(RLHF),而是开发了校准决策强化学习(RLCD)。
Traditional RLHF:
Objective: Maximize human rater approval
Side Effect: Overconfidence, hallucinations, sycophantic agreement
TypeSafe RLCD:
Objective: Statistical calibration of probability distributions
Result: A 0.85 score means the model is verifiably right 85 out of 100 times
在标准聊天模型中,置信度评分向来不可靠。即使引用完全是凭空捏造的,聊天机器人也可能表现得百分之百确信。
RLCD 强制实现统计校准。如果 Jev 对一批决策进行评估,并给出 80% 的概率,那么在 100 次这样的评估中,大约会有 80 次在客观上是准确的。
TypeSafe 还宣称,其结构化输出错误率为 0%。
这是由其架构从根本上保证的。由于 Jev 从不解码文本 token,因此它根本不可能输出残缺的花括号、未转义的引号或无效的键。
不过,符合 Schema 并不等于语义正确。Jev 永远不会让你的 JSON 解析器报错,但如果你的指令表述不清,它仍然可能选择错误的选项。

在 TypeSafe 的基准测试中,Jev 的结构化输出错误率确实为 0%。
04
如何实现速度提升?
在官方工作流评估中,TypeSafe 报告称,相比前沿模型实现了 19.3 倍到 193.6 倍的加速。
在 OpenRouter 和 TypeSafe 托管 API 等实时公共端点上,测得的端到端延迟呈现出一致的结论。
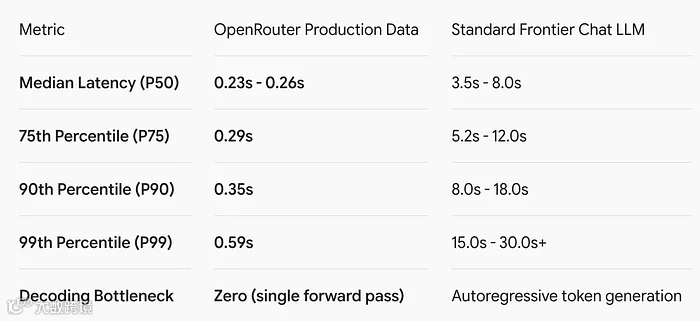
一个重要的架构优势来自 TypeSafe 所称的 “推测式扇出(speculative fan-out)”
在自回归架构中,如果要针对一份事故报告提出五个问题,就意味着要么连续进行五次独立的 API 调用,要么将所有问题都塞进一个巨大的提示词中。每增加一个问题,模型就需要生成更多的输出 Token,从而直接增加整体延迟。
Jev 则颠覆了这种模式。输入状态只需编码一次并加载到 GPU 显存中,之后所有预先声明的问题都可以基于同一份缓存的状态表示并发进行评估。
向 Jev 提出十个问题,与只提出一个问题相比,所花费的实际时间几乎完全相同。在真实工作流评测中,针对一份大型文档批量处理十三个不同的分析问题,相比使用聊天模型依次处理这些问题,速度提升了十倍。
为了证明这种延迟究竟有多低,TypeSafe 展示了 Jev 在实时交互式游戏循环中的运行效果。
在其中一个演示中,Jev 可以实时玩《毁灭战士(Doom)》:它将游戏内存状态读取为结构化文本,并以每秒十次的频率做出动作选择。
05
价格评估
对于像我这样的开发者来说,看着每个月的 API 账单不断上涨,确实很让人头疼。而 Jev 的定价表,甚至便宜得让人觉得有些不可思议。
TypeSafe 给出的价格是:输入 Token 每百万仅需 0.042 美元。换算下来,10 亿 Token 大约只需要 42 美元。而输出 Token 的价格则明确标为:0.00 美元。
为什么输出是免费的?
因为这个模型实际上不会生成任何输出 Token。它根本不会运行传统生成式大模型中的解码采样器(Decoding Sampler)来逐 Token 生成文本,而只是直接填充一个由**浮点概率值和类型化索引(typed indices)**组成的数组。
TypeSafe 表示,与前沿的对话大模型相比,Jev 可以将整个工作流的成本最高降低 444.6 倍。
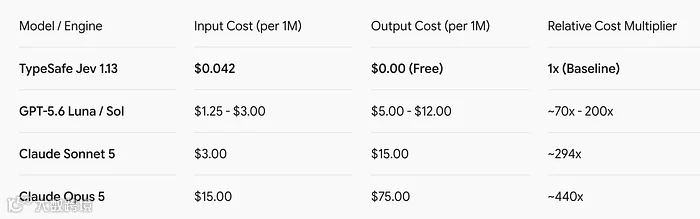
当你使用 Claude Sonnet 5 或 Opus 5 来执行分类任务时,实际上是在为大量根本用不到的模型能力支付高额溢价。你的数据库可能只需要一个简单的类别标签(Category Tag),但你却在花钱让模型生成并流式输出完整的英文句子。
这也正是为什么现在许多独立开发者(Indie Hackers)会感受到如此大的成本压力。
使用 Jev,大家可以:
处理 10,000 条用户输入 → 按照自定义 Schema 进行分类 → 执行安全检查,整个流程的总成本甚至不到 0.05 美元。
这会彻底改变独立开发者能够以合理成本真正做出来、并上线交付的产品范围。
06
如何访问?
直接平台访问目前通过早期访问候补名单进行限制。这里是加入候补名单的链接。
网址: https://typesafe.ai/
目前有三种主要集成路径可用。
直接TypeSafe API:直接托管在 api.typesafe.ai,并提供 Python 和 TypeScript 官方客户端 SDK。你传入 API key,定义共享状态,并配置问题 schema。
Vercel AI Gateway:Vercel 已通过一个实验性评估端点将 Jev 直接集成到其 AI SDK 中。如果你已经在 Next.js 上构建,或托管在 Vercel 上,就可以用最少的配置把评估逻辑切换过来。
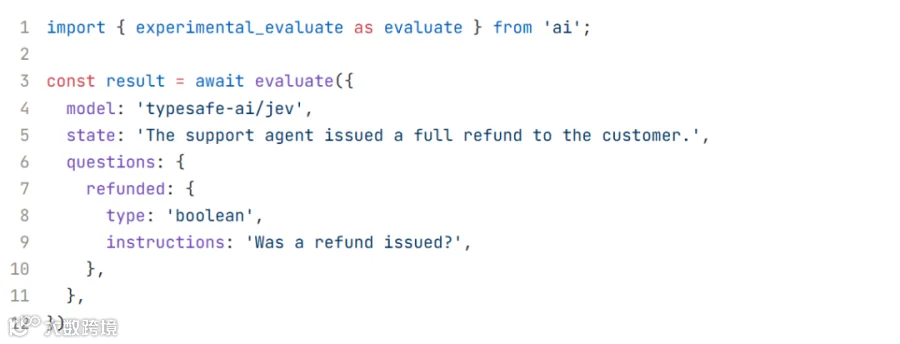
OpenRouter:如果你已经通过 OpenRouter 路由流量,Jev 可通过模型标识符 typesafe/jev-1.13 访问。OpenRouter 会将请求直接转发给 TypeSafe,零加价,并保持原生每百万输入 token 0.042 美元的定价。
使用非常简单。这里有一个例子:
Vercel CEO Guillermo Rauch 甚至说,它可能成为 Vercel AI Gateway 上的新默认选项。这有多酷?
总而言之,对于每个构建 AI 产品的人来说,这确实是一个改变游戏规则的东西;而且,假设成本和延迟进一步改善……它将成为每个做任何事情的人的改变游戏规则者。
添加个人微信,进专属粉丝群!
