


活动内容
为答谢资深用户的信任与陪伴,凡 注册 ID 1984000 之前的用户,均可再次获赠 一亿 Token,实现 Token 自由,畅享 AI 产品带来的高效体验。
适用产品
本次赠送的 Token 通用于全线产品:NoteExpress、NeClaw、NEHermes、NeCode、FlyLaTeX、青提学术、问天AI、红豆智能文献 等。
AI 产品入口:nelabs.inoteexpress.com
活动时间
Token 使用期限为 一个月,有效期至 2026年10月28日 止,逾期未用自动失效。
活动说明
-
本次活动全程免费,无需任何费用(全价 0 元)。 -
Token 将自动发放至符合条件用户的账户,无需领取,也无需另行申请。 -
本次活动最终解释权归北京爱琴海乐之 和 杭爱山(杭州)人工智能科技有限公司所有。
文献检索 · 图谱分析 · 药物发现 · 蛋白质预测· 分子材料
neScholar.com 是一个专为科研人员打造的 AI 工作流平台,围绕"科研检索 · 图谱分析 · 分子材料工具"三大板块,把文献检索、证据发现、分子设计、结构预测这些科研里最耗时的环节串成一条完整链路,让研究者在一个平台上就能完成从查文献到出结果的整个流程。
访问地址:neScholar.com
一、文献检索与知识图谱:先定方向
文献智答
以自然语言提问,系统检索文献后作答,出处与引证一并列出,可回原文核验。适用三事:确认某方向有无前人做过、核验某论点出处、摸清研究现状。

学术文献
覆盖 2 亿+ 条科研文献。常规检索之外,支持 AI 扩写检索(把一句研究问题扩成一组检索词)与高级多条件组合查询。条目可展示影响因子、期刊分区、收录类型、学科分类;摘要可译,引用一键生成,亦可顺出处查引证;遇合适条目,点开其引用关系图继续深挖。
文献图谱
给一个 DOI 或文献标题,将相关文献、施引文献、参考文献铺成一张引用网络;多篇可一并出图。开题与综述之前,用它梳理领域结构、找出绕不开的经典文献。

配套工具
学者查询:给出 H 指数、被引次数、i10 指数等可比数据,用以找方向代表人物或判断潜在合作者;
文献综述:可就某主题直接生成综述,亦可就一篇论文提问、作事实核对;
书目检索:面向专著与教材,含出版社、出版时间与内容简介;
科研绘图:把方法说明与图注化为学术插图,论文需示意图时先借此出草稿。

二、生物制药:自证据到假设,再到设计
本组是正循环中证据密度最高处,共五个入口,串起来恰是一条完整研究路径。
医学文献
可按标题、摘要、作者、期刊等字段检索,亦可用 AI 增强检索——以自然语言直述医学问题,由 AI 分阶段改写并检索相关证据。
临床试验
平台聚合 ClinicalTrials.gov 与 ChiCTR(中国临床试验注册中心) 两大注册库,支持按登记题目、适应症、干预措施、机构等字段检索,中英条目俱可查、可译。
试验详情页:可按注册库记录展示注册号与注册日期、试验状态/分期/类型、目标样本量、性别要求、试验设计、适应症、纳入与排除标准、干预措施、主要及次要终点、重要时间节点、经费来源和研究者信息等字段,并可跳转原始记录。
以 ChiCTR 观察性研究为例,可查看注册号、研究设计、目标样本量、终点指标及研究者信息。结构化呈现,让试验线索不止于一段摘要。
试验详情页底部设有相关推荐:有匹配结果时列出同主题临床试验和相关医学文献。由一条试验延伸到同方向研究,便于系统综述与选题调研。
药物发现
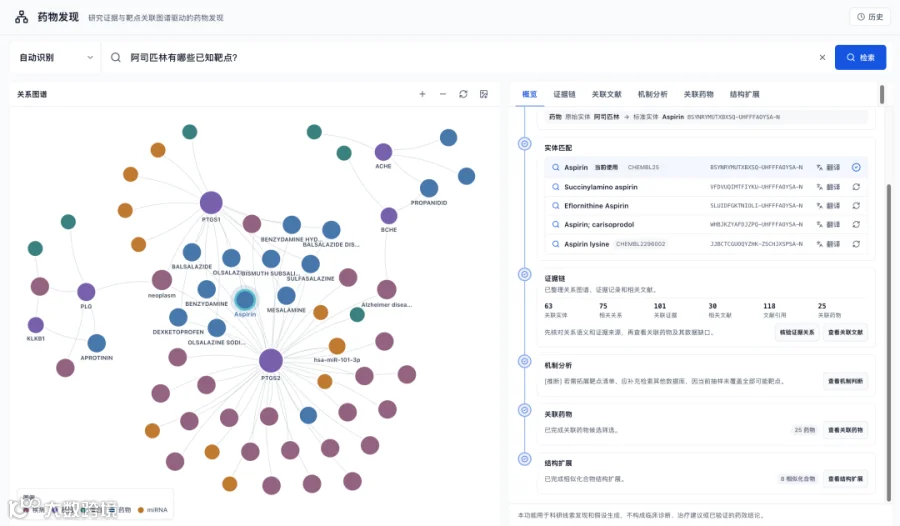
输入疾病、药物、基因、蛋白或 miRNA(亦可直给 ChEMBL ID、UniProt 编号等标准标识),系统将其认作标准实体,再把该实体在数据中的关系网铺开——牵涉哪些靶点、连着哪些疾病、有哪些候选药物与相关 miRNA,并给出证据链与关联文献。
全程分六步:问题理解 → 实体匹配 → 证据链 → 机制推断 → 小分子候选筛选 → 结构扩展。右侧提供可交互关系图谱(可放大、缩小、重置、下载),并按五类实体着色:疾病、基因、蛋白、药物、miRNA;实线表主实体直接关系,虚线表邻域扩展关系。
以查询 Aspirin 为例:系统将其映射为标准实体 ASPIRIN(ChEMBL25),展开 PTGS1、PTGS2 等关联靶点,并展示相关疾病、药物、miRNA 与证据文献。实体匹配环节可列出名称相近的候选,供选择规范实体后重新检索。
关联文献可导出为 CSV 或 RIS,带入文献管理软件;关系图可下载为图片。页面同时标注:"本功能用于科研线索发现和假设生成,不构成临床诊断、治疗建议或已验证的药效结论。"
蛋白质预测
此为独立工作台(protein.nescholar.com),非单页工具。支持三种数据入口:输入序列(适用于 AlphaFold、Fab 预测等)、序列/结构 ID、上传数据文件(CSV、XLSX、FASTA、PDB);并提供四种分析模式:预测蛋白质结构、蛋白质设计/工程改造、设计或比较现有抗体构建体、分析抗体。数据集可新建,亦可复用已保存工作区。
蛋白质设计
任务式提交,四种任务类型:蛋白结合剂、配体结合剂、模体支架、单体设计。内置靶点/配体(如 02_PDL1、39_7V11_LIGAND)可快速起步。提交后进入远端队列,进度与结果于"任务记录"在线查看;产物为 PDB 文件,页面可直接转 3D 看结构,无须为看一眼形状另装软件。计费规则透明:远端任务成功完成并生成结果后扣 500 万 token,失败或取消不扣费。
三、化学研究:把"科研数据"落到可比字段
此段是正循环中"数据"一环实际载体。共四个入口,每个都对应一类可查、可比、可导出结构化数据。
化合物
输入分子式、化学体系、InChIKey、SMILES 或名称任一即可查询。数据聚合自 PubChem、ChEMBL、ZINC 三大源;条目按数据来源展示对应外部 ID(如 PubChem CID、ChEMBL ID、ZINC ID),便于溯源。
单条记录可展示 PubChem CID、ChEMBL ID、ZINC ID、活性成分标签、最高研发阶段、分子式、分子量、IUPAC 名称、SMILES、InChIKey、InChI、PubChem 创建日期等字段;有相应数据时可复制标识、跳转分子式编辑,符合输入条件时还可直达反应预测。
化合物检索显示命中总数;结果仅展示前 10,000 条(每页 20 条时最多 500 页)。
点进任一条化合物详情页,除化合物总览、名称与来源、药物与药理,底部另有一块"相关推荐",把该分子与更大知识网络相连:
-
推荐化合物:结构相近、值得一并比较的分子。 -
关联文献:PubChem CID 关联的文献,可查看标题、PubMed 编号、日期与期刊等信息。 -
关联专利:PubChem CID 关联的专利,可查看专利标题、专利号、日期与申请人/发明人等信息。
此处关联文献与专利来自 PubChem CID—PMID、CID—专利号的关联数据,非按化合物名称及同义词检索,也不是按结构精确匹配的专利族;可据此发现线索,再回原文核对。
化学材料
按材料 ID、化学式或元素组合查询,亦可直接用元素周期表圈出关心元素。支持两种思路:「仅包含这些元素」(如 H-O)与「至少包含这些元素」(如 H,O),另有"构建分子式"入口。
结果是一张可横向比较的结构数据表,共 10 列:材料 ID、化学式、晶系、空间群、位点数、能量高于凸包(eV/atom)、带隙(eV)、形成能(eV/atom)、晶胞体积(ų)、结构密度(g/cm³)。查 Si 可比较不同晶型/构型的结构参数,结构可在线预览。

分子式编辑
画结构、识别结构图片、生成标准 SMILES,三者同一工作区完成。他人发来结构图,或自己在纸上随手画一个,传上去即成可编辑分子;成果可导出 PNG、SVG、MOL,论文配图与投稿均可直接用。
反应预测
三个问题对应三个入口:此反应会生成什么(正向反应预测)、要得此产物可怎么走(逆合成路径分析)、此路线大约多少收率(产率评估)。输入方式为 SMILES、化学名称或结构式图片,界面另提供模型选择、束搜索宽度、最大长度等参数。页面明确提示:"当前预测未将催化剂、溶剂、温度等反应条件作为输入,结果仅作为候选产物参考。"安排合成路线时,先用它把候选方案过一遍,再查文献验证。

四、专利检索:把技术边界一并纳入
支持按关键词、申请人、发明人等字段检索专利。可查看专利摘要、权利要求与著录信息,为技术创新与知识产权保护提供支持。
五、串联起来看:这才是"正循环"
- 找方向
:文献图谱梳理领域结构,锁定绕不开的经典文献与代表学者。 - 找证据
:医学文献 + 临床试验,把论点与临床依据核到注册号一级。 - 提假设
:药物发现把疾病/药物/靶点/miRNA 摊成关系网,关联文献可导出 CSV 或 RIS。 - 验数据
:化合物库查候选分子(带 CID/SMILES/InChIKey),材料库比结构参数(带隙、形成能、晶胞体积)。 - 做设计
:蛋白质预测/设计给出候选结构(PDB 可在线 3D 预览),反应预测把合成路线先过一遍。 - 回文献
:有来源链接的结果,可顺出处回原文核验——闭环由此合上。
neScholar 不是一个功能堆砌的平台,而是一条完整的工作流。从文献检索到分子设计,每个环节的数据都能流到下一步,研究者不需要在多个工具之间反复搬运信息。