

现在的大模型能力已经很强,但很多时候,我们并不需要模型写一大段答案,只需要它看清楚当前发生了什么,然后快速做一个决定。
比如游戏 Agent 判断下一步往哪走,GUI Agent 判断一个弹窗该继续还是关闭,机器人看到障碍物后决定下一步动作。
如果每一次这样的“小决定”,都要让大模型先看图,再逐 Token 生成文字,最后由程序解析它到底选了什么,整个过程难免有些绕。
前段时间,TypeSafe AI 发布的 Jev 就在尝试解决这个问题。
它提出了一类被称为 System One Model 的模型:不再以生成文本为主要目标,而是根据输入信息,直接输出程序可以使用的结构化概率决策。不过,Jev 此前公开展示的重点仍然主要是文本和结构化状态。
最近,复旦大学研究者开源了 Valen(万澜),把这套思路进一步扩展到了视觉世界。
将图片、视频输入模型后,Valen 不需要先生成一段解释,可以直接在候选动作中做判断,并给出对应概率。
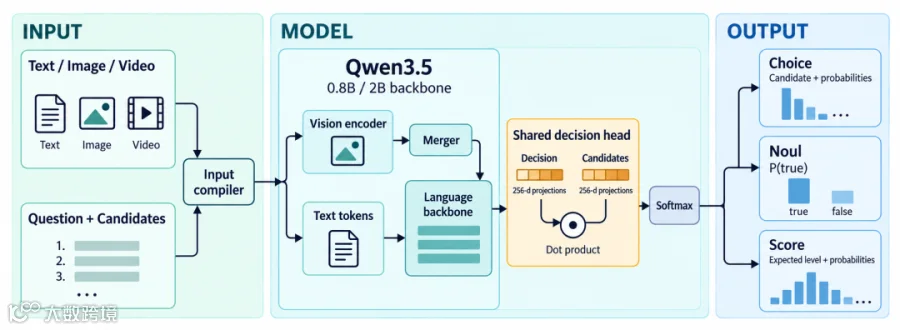
Valen 模型基于 Qwen3.5-0.8B / 2B 构建,模型架构如下:
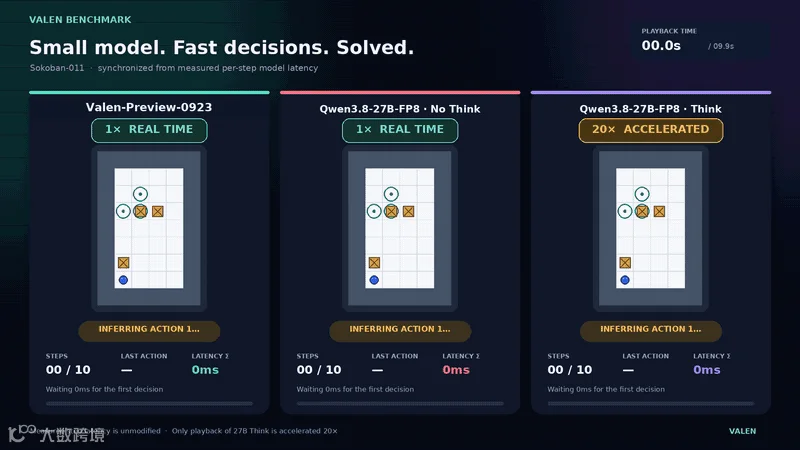
官方展示的推箱子 Demo 中,2B 模型直接读取棋盘图像,用 9 次决策完成关卡,累计决策耗时仅 1.13 秒。
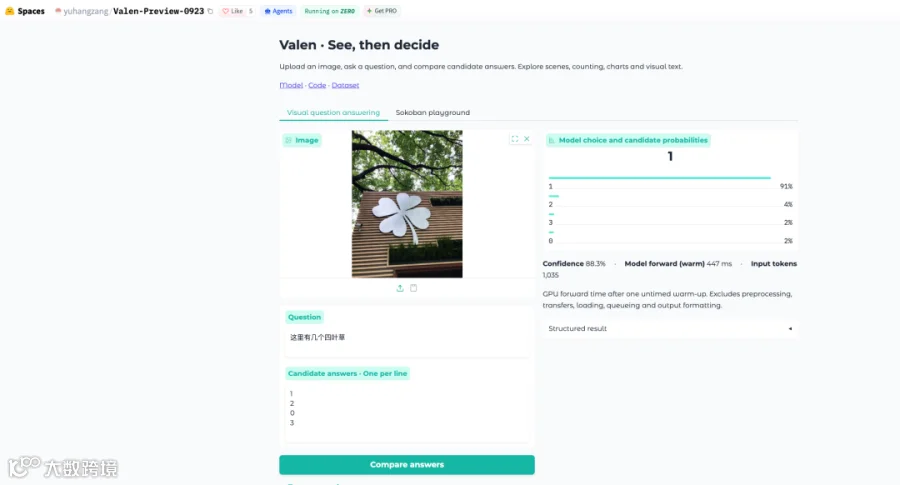
如果暂时不想折腾本地部署,也可以在线体验。
01
让模型在看不清时学会“犹豫”
Valen 把 Jev 这种带概率的结构化决策扩展到了视觉场景。
项目方还专门做了一个图像模糊实验。在清晰图片上,Valen 的决策置信度为 91.6%;随着高斯模糊不断增强、视觉细节逐渐丢失,最强模糊条件下置信度下降到了 19.2%。
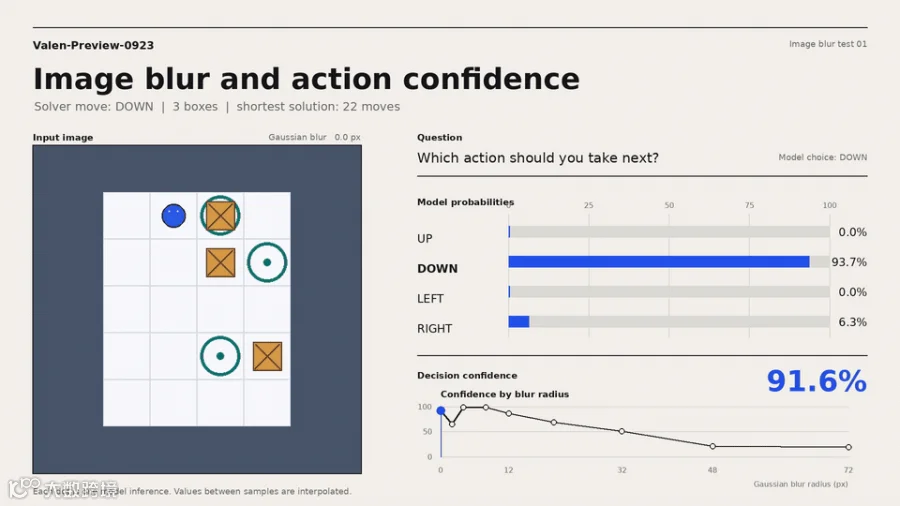
这对 Agent 很重要。现实中的自动化系统,最怕的就是在信息不够清楚时,仍继续执行动作。
如果这种 confidence 能较好地反映模型的不确定性,程序就可以围绕它设计第二层逻辑:高置信度时直接执行,置信度降低时重新截图、调用更大的模型,甚至转交人工处理。
02
使用教程
根据官方技术文档,运行环境要求为 Linux、Python 3.10+ 和 NVIDIA GPU,核心依赖包括 PyTorch 2.6.0、torchvision 0.21.0、Transformers 5.4.0 和 PEFT 0.18.1。
git clone https://github.com/Liuziyu77/Valen.git Valencd Valenbash scripts/setup/bootstrap.shsource .venv/bin/activate
依赖安装完成后,需下载模型权重。
# 下载 Qwen3.5-2B Base 模型。hf download Qwen/Qwen3.5-2B --local-dir models/Qwen3.5-2B# 用随仓库提供的合成样本训练决策头。python -m valen.train \--config configs/train/qwen/sft_warmup.json# 加载训练得到的 checkpoint 进行推理。python -m valen.inference \--checkpoint output/sft_warmup/latest \--data data/smoke/train.jsonl \--output output/sft_warmup/predictions.jsonl# 用同一组合成样本检查评估流程。python -m valen.evaluate \--checkpoint output/sft_warmup/latest \--data data/smoke/train.jsonl \--output output/sft_warmup/smoke_eval
当前 Valen 支持 SFT 和 RLCD 两种训练 method,stage 决定更新哪些参数,当前支持四种 stage 配置。
03
当AI开始需要“快判断”
在软件、机器人和 Agent 背后,其实存在大量高频、细碎的判断,页面是否加载完成、机械臂是否该停止、当前画面是否异常、下一步该调用哪个工具。
这些任务不需要模型长篇解释,而需要快速、稳定、能直接被程序执行的决策。
这类 System One 视觉决策模型,未来或许会成为 Agent 的“反射弧”。大模型负责规划、推理和长程任务,而像 Valen 这样的模型,则负责大量高频、实时的小决策。
END
关注+星标,获取AI前沿进展与开源一线动态