

智猩猩AI整理
编辑:林夕
Vercel近日上线了一款名为stealth/pixel-canary的模型,但没有公布背后的厂商和具体型号。

模型能力方面,它在Vercel自己的Next.js eval中,基线测试拿到28/31,达到约90.3%;
加入AGENTS.md提供的Next.js文档后,成绩进一步升至30/31,也就是96.8%。
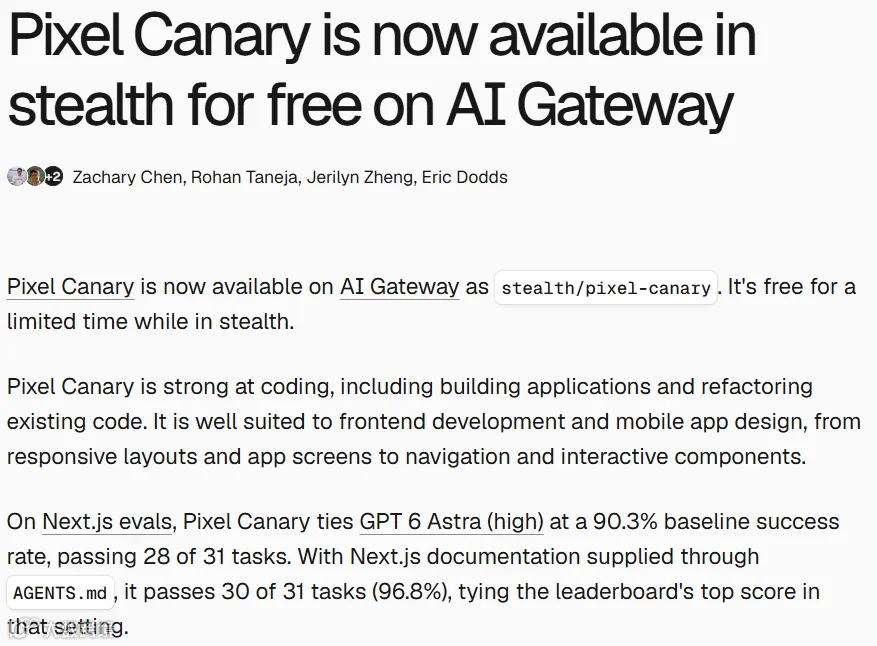
这组成绩与GPT-6 Astra在同一测试中的表现接近。
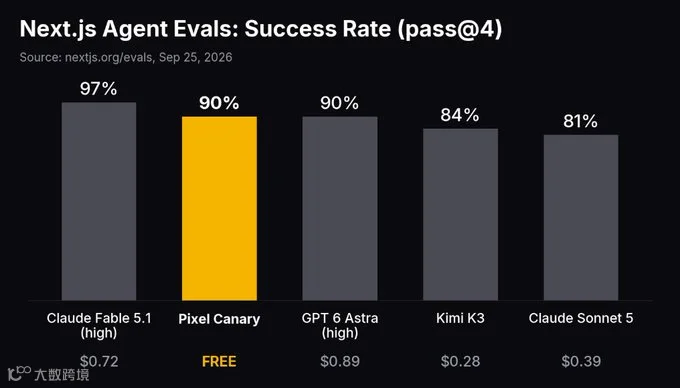
但相比这些跑分,Pixel Canary真正让开发者好奇的,是它究竟来自哪套模型体系。
有开发者对它进行的Tokenizer测试显示,Pixel Canary与Qwen体系之间存在高度一致的切词特征。
Pixel Canary的23组token-count probe全部命中Qwen体系,而官方Qwen Tokenizer可以完整复现。
测试还发现了旧版Qwen的切分规则和固定overhead等特征。
为了进一步验证这一结果,后续测试把样本扩大到了95条,测试结果更加明显,单独使用Qwen3.5及以后版本的词表,95条中有89条匹配。
加入旧一代Qwen的切分规则后,95条全部匹配。
相比之下,Google系词表只能匹配24条,其他被测试模型最高也只有23条。
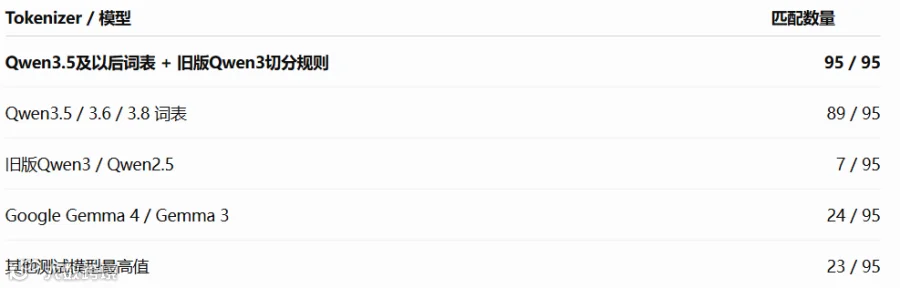
从Tokenizer结果来看,Pixel Canary与Qwen体系之间的关联已经相当明显。
接下来,开发者又直接对模型本身进行了身份测试。
用英语、中文和日语多次询问Pixel Canary的身份,模型最终都坚持称自己是Pixel Canary,并表示开发公司、底层模型等信息尚未公开。
但在推理过程中,却出现了类似:
“You are Qwen...”
以及“不要提及Gemini、Qwen等具体模型名称”的指令描述。
也就是说,模型最终对外给出的身份,与测试过程中出现的相关指令描述并不一致。
综合这些线索来看,Pixel Canary与Qwen体系存在较强关联,但这仍不足以确认它的具体来源。
也正因为如此,外界开始进一步猜测,Pixel Canary是否与Qwen新一代模型有关,甚至有人将它与Qwen4联系起来。
不过,Tokenizer能够帮助判断模型家族,却很难单独锁定具体型号。
Pixel Canary究竟基于Qwen3.5、Qwen3.8,还是更晚的Qwen版本,目前都没有足够证据。
除了Tokenizer,还有一个细节值得留意。
Pixel Canary宣称的上下文窗口达到262,144 tokens,这个数字与Qwen体系此前出现过的超长上下文规格存在一定对应关系。
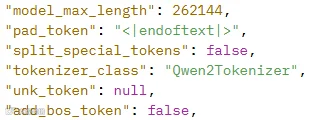
单看上下文长度,这还不足以证明Pixel Canary来自Qwen。
但和前面的Tokenizer指纹放在一起看,又增加了一条指向Qwen体系的辅助线索。
问题也就出在这里:即便Pixel Canary使用了Qwen Tokenizer,也不能据此判断它就是阿里官方发布的模型。
Qwen本身存在不少衍生模型,一个模型完全可能在Qwen基础上继续训练、微调、蒸馏,或者经过其他方式衍生出来。
因此,目前能够确认的更多是它与Qwen体系之间的联系,至于具体是哪一个模型、由谁训练,仍然没有答案。
所以现阶段,Pixel Canary更像一个“待解密”的模型。
Tokenizer已经把它和Qwen家族之间的联系扒得相当明显,但距离确认它到底是哪一个Qwen、谁训练了它,还差关键的一步。
这次,Tokenizer已经把底牌翻了一半。
END
关注+星标,获取AI前沿进展与开源一线动态