

智猩猩AI整理
编辑:林夕
2026年,钟亦武正式加入北京大学智能学院,任助理教授、研究员、博士生导师,并入选国家级海外青年人才项目、北京大学博雅青年学者。

钟亦武的研究方向主要集中在视觉-语言学习、多模态大模型、智能体、三维空间推理和具身机器人等领域。
他的研究并不是简单地停留在视觉识别或者多模态模型本身,而是一直在探索一个更大的问题:
如何让人工智能同时理解视觉世界、人类语言以及真实空间中的环境,并进一步完成推理和行动。
这条研究路线,也贯穿了他的博士阶段以及后续的科研工作。
钟亦武于2023年获得美国威斯康星大学麦迪逊分校(UW-Madison)计算机科学博士学位,博士阶段师从Yin Li教授。博士期间,他的研究主要集中在计算机视觉和视觉语言学习。
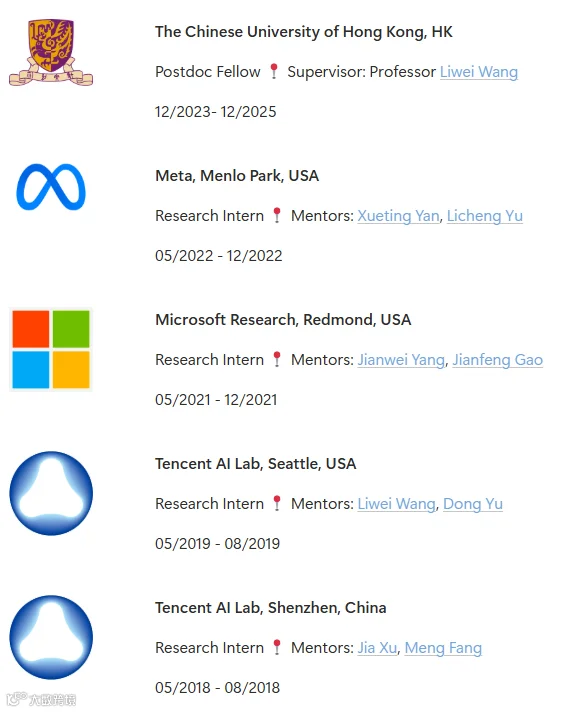
博士毕业后,他进入香港中文大学担任博士后研究员,合作导师为Liwei Wang教授。
在此之前及博士阶段,他还曾在Microsoft Research、Meta AI和腾讯AI Lab等机构开展研究或实习。
从他的论文履历来看,钟亦武较早就开始关注视觉与语言之间的连接。
其中比较有代表性的一项工作,是发表于CVPR 2022的视觉语言预训练研究RegionCLIP。
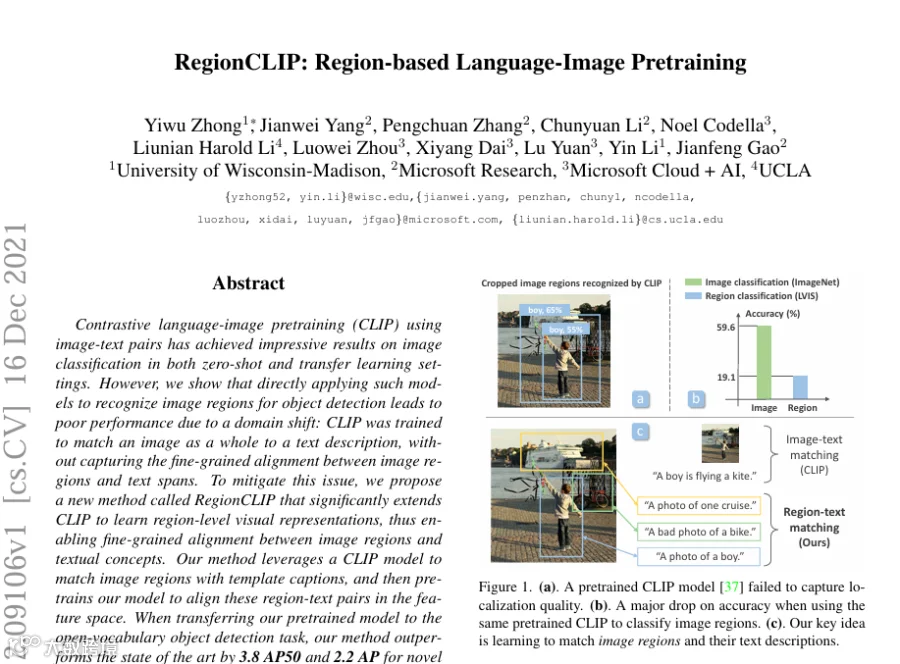
RegionCLIP关注的是图像区域与文本之间的对应关系。
传统视觉模型通常需要针对特定任务进行训练,而视觉语言预训练希望让模型提前建立更加通用的“图像—文字”关联,从而进一步支持开放词汇识别、检测等任务。
这类研究的重要意义在于,模型不再只学习固定类别,而是开始利用自然语言描述来理解视觉世界。
钟亦武后来还参与了CVPR 2022论文GLIP(Grounded Language-Image Pre-training)。
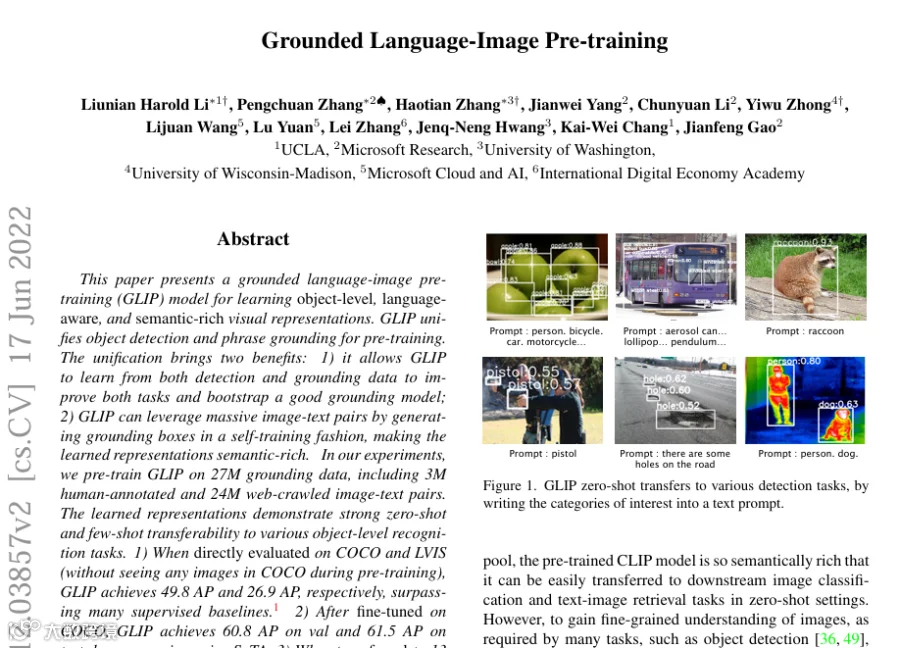
GLIP进一步把目标检测与视觉语言预训练结合起来,通过大规模图文数据建立语言与图像区域之间的对应关系,让检测模型能够利用文本描述去定位图像中的对象。
这项工作最终进入了CVPR 2022 Best Paper Finalist名单。

当年CVPR共收到8161篇投稿,最终只有33篇论文进入Best Paper Finalist阶段,GLIP位列其中。
除了论文之外,钟亦武也曾获得CVPR 2023 Doctoral Consortium Award等学术荣誉。
从这些早期研究可以看到,他关注的核心问题一直比较明确:让机器不仅“看到”图像,还能够把视觉内容与语言语义连接起来。
而随着大模型的发展,这条研究路线也开始进一步向多模态大模型延伸。
近年来,视觉语言模型已经从早期的图像分类、目标检测和图文匹配,逐渐发展到可以进行视觉问答、图像理解、复杂推理以及多轮交互的多模态大模型。
钟亦武目前的研究也进一步覆盖了多模态大模型、空间理解和高效推理。
这也与北京大学智能学院正在推进的交叉研究方向相契合。
学院目前将计算机视觉、自然语言处理、机器学习、认知推理、机器人学和多智能体等作为重要研究方向,目标是推动不同人工智能领域的融合。
目前,钟亦武已经进入北京大学智能学院的博士生导师名单,并参与学院相关招生工作。
学院公布的2027年招生指南中,他同时出现在计算机视觉和自然语言处理相关博士生导师名单中。
对于正在快速发展的多模态大模型、空间智能和具身智能方向来说,这也意味着钟亦武将把此前在视觉语言学习领域积累的研究进一步带入北大的人工智能研究体系。
END
关注+星标,获取AI前沿进展与开源一线动态