


当前具身智能训练需要把环境、动作与结果对应起来。视频、机器人状态和传感器记录,只有经过同步、标注与质量检查,才能成为可复用的训练数据。
而H700可以提供一条现场的快处理路径:就地保存多模态数据,完成 AI 预标注与质量检查,再通过人工复核形成可追溯的数据集。
以下为实现架构,处理速度与精度需按设备配置和实际任务验证。

图 1 基于 H700 实拍照片制作的部署合成示意,实验环境为示意
01 具身数据的难点
场景覆盖不足。 同一任务在不同材质、负载、光照和遮挡条件下,可能需要不同的操作策略。大量重复的成功演示,无法替代对异常、失败和恢复过程的记录。
多模态关系不完整。 插接操作需要同时描述位置、动作与接触变化。仅有视频或任务文字,难以还原控制指令与实际状态之间的关系;时间戳、坐标系或标定不一致,还会引入隐蔽误差。
标签缺少证据。 模型识别出“夹爪闭合”,并不等于已经确认“抓取成功”。标签需要关联原始片段和测量记录,明确区分观测事实与模型推断。
DROID 的多场景采集、Open X-Embodiment 的跨本体数据研究,以及 EgoScale 的人类第一视角动作数据研究,都说明数据覆盖与动作表达的重要性。[1–3] 对工程系统而言,高质量数据应具备三个基础条件:记录完整、时空一致、结果可核查。
02 H700如何组织现场标注
H700 承担本地存储与计算,独立标注服务组织处理流程,Studio 和 Harbor 的软件模块分别提供现场操作与集中协作。这里的“存算一体”指系统层面的存储与计算协同,数据落盘后由就近算力处理。
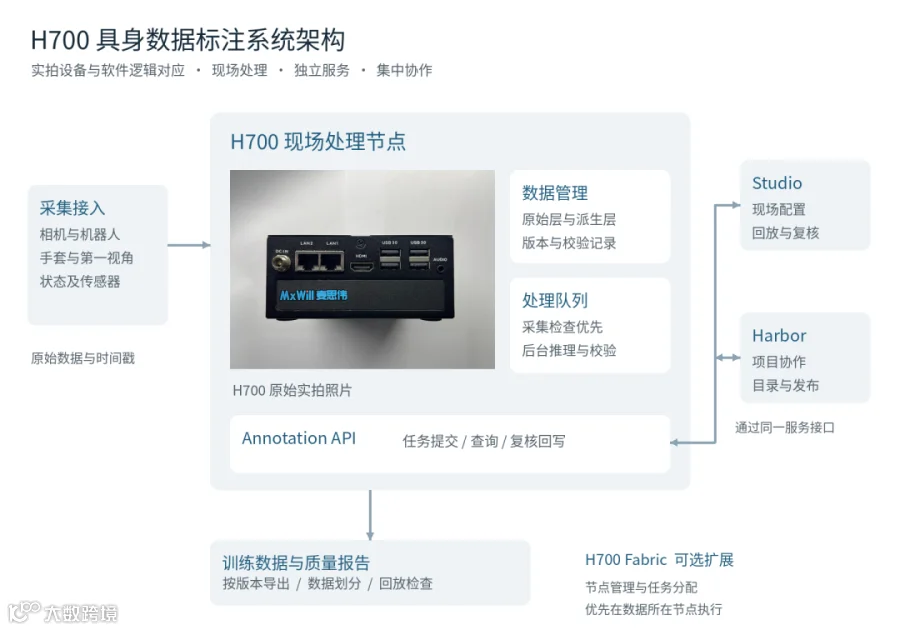
图 2 节点中嵌入 H700 原始实拍照片,连线表示软件逻辑
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Studio 与 Harbor 调用同一套标注接口,避免各自重复建设处理逻辑。任务以异步方式执行,保留输入、模型版本和修改记录,支持失败重试;已发布的数据集保持版本固定。多节点扩展时,H700 Fabric 可负责节点管理与任务分配。
采集检查优先保障接入和写盘,后台推理按资源余量执行。若与机器人控制共用设备,还需限制计算和磁盘占用,并实测控制周期与采集丢帧。
03 先把数据组织正确
每次采集记录任务、场景、设备配置和标定版本,并为各数据流保留原始时间戳。设备重启或时钟跳变时,应分段标记,避免拼接成虚假的连续轨迹。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
同步精度要由任务决定。以每秒 0.5 米的匀速运动为例,20 毫秒错位对应约 10 毫米的位置差。精细插接因此需要更严格的同步与标定,后处理对齐也应记录残余误差。
存储可分为原始、派生和发布三层:原始层保留证据,派生层保存模型输出及修订,发布层固定样本清单和训练版本。标签应能追溯到对应时间段、数据来源、模型版本及复核状态。

图 3 原始记录与标签相互关联,未知或缺失信息显式保留
EgoDex 对姿态置信度及自动语言标注可能存在的错误作了说明。[4] 这类不确定性同样值得保留。原始记录则按保留策略备份,避免仅留下标签而失去复核依据。
04 从AI预标注到高质量标签
接入检查。 在采集期间检查掉帧、缺流、解码和时间连续性,及时提示调整设备或补采。
对齐与预处理。 统一时间映射和坐标关系,建立索引与解码缓存。长时间缺失保持缺失标记,不用插值补出未经观测的动作。
对象与运动预标注。 检测、分割和跟踪模型定位对象,姿态模型提供运动候选,多模态模型提出动作阶段与语义描述。SAM 2 可作为视频分割的候选组件。[5]
事件判定。 根据任务定义核对证据。“抓取完成”可结合物体离开支撑面后的持续运动判断;“插接完成”则可能需要位置、力觉或设备信号共同确认。
人工复核。 将模型分歧、低置信度和关键失败片段送入复核,同时抽检自动通过样本。多模型一致仍可能存在共同错误,不能替代独立参考数据。
导出与发布。 成功、失败和恢复过程分别标识,按训练用途选取。RoboMIND 公开实践中的人工语言修订与失败数据记录提供了参考。[6] 导出为 LeRobot 等格式后,还需核对索引、单位及坐标语义,并完成训练端读入和回放检查。[7]
05 对应哪些具身场景
门店取放。 标注接近、抓持、转移、释放及结果,重点保留滑落和重试,观察不同容器、负载与遮挡下的错误分布。
工业插接。 联合视频、机器人状态和力觉记录,区分接触、受阻、退出与重新对位;没有相应测量时,不输出确定的插入力。
人类示教。 AWEAR 手套与第一视角设备提供互补观测,H700 可承担同步检查、轨迹处理与标注。手部重建和机器人重定向分别保留,重定向还需验证关节限位、自碰撞与可达性。
世界模型数据。 区分观察序列、动作条件和状态变化,并分别标识真实测量、模型推断与仿真数据,避免将预测结果混入实测记录。
06 存算配置要匹配数据规模
单工位可由一台 H700 完成接入、存储与标注;多个工位优先处理本地数据,再集中管理目录和版本。重型推理可转交中心服务器,现场节点继续承担采集检查和缓存。
容量可从视频码率估算:四路视频、每路 8 Mbps,每小时约 14.4 GB,八小时约 115.2 GB。该算例使用十进制容量,尚未计入深度、点云、派生标签和备份。
计算配置也要结合完整流程验证。GPU 与显存影响模型选择,CPU、解码、磁盘和散热决定持续运行能力。不同 GPU 配置需分别检查运行后端与算子支持,处理速度还要计入数据读写、重试和人工复核。
07 如何判断标注是否有效
先选一个目标任务,建立覆盖成功、失败与异常条件的参考集,再比较纯人工和 AI 辅助流程。训练与测试数据按采集会话、操作者或场景隔离,避免相邻片段泄漏。
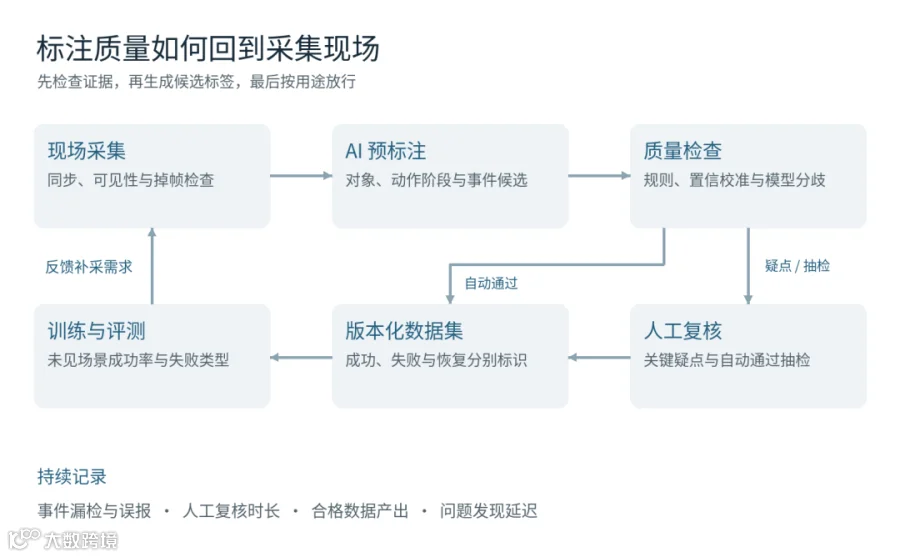
图 4 复核结果指导补采,训练评测检验数据的实际价值
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
自动生成的标签数量不能单独说明效果。真正需要验证的是:关键错误是否减少,每小时合格数据的成本是否降低,以及机器人在新场景中的表现是否改善。
H700 的现场存算协同,价值在于缩短问题发现与修正之间的时间,让采集、标注和训练之间保留可追溯的联系。
后续我们将会发布H700用于真实数据采集和标注的完整处理过程,希望大家持续关注我们。
关注 芯动力AI,我们会继续分享 大模型、Agent 和具身智能等方面的相关信息。
参考资料
相关参考资料
[1] DROID:https://droid-dataset.github.io/
[2] Open X-Embodiment:https://robotics-transformer-x.github.io/
[3] EgoScale:https://research.nvidia.com/labs/gear/egoscale/
[4] EgoDex:https://github.com/apple-aiml-research/ml-egodex
[5] SAM 2:https://github.com/facebookresearch/sam2
[6] RoboMIND:https://x-humanoid-robomind.github.io/
[7] LeRobotDataset v3:https://huggingface.co/docs/lerobot/lerobot-dataset-v3