

哈喽,大家好~
不少同学聊到,数据里有几个特别离谱的点,直接删掉不就行了吗?
先别急,首先,异常值既可能是录入错误,也可能是一次真实发生的小概率事件。处理错了,模型不但不会变好,反而会丢掉最有价值的信息。
今儿我们聊聊机器学习中常见的异常值处理方法,并用 Isolation Forest(孤立森林) 完成一次检测、清洗和建模对比。
异常值为什么会影响模型?
你可以把线性回归理解成“在一堆数据点中间拉一条最合适的直线”。
假设大部分样本都满足“投入越多,收益越高”,但其中几条数据因为录入错误,收益突然多了几十倍。为了照顾这些点,回归直线就会被强行拉偏。
异常值常见的处理方式有三类:
-
统计方法:使用 Z-Score、IQR 判断数据是否偏离正常范围; -
模型方法:使用 Isolation Forest、LOF 等算法发现异常结构; -
业务方法:结合字段范围和业务规则进行修正、截断或删除。
例如 IQR 会把低于 或高于 的数据标记为异常,其中 。
不过,IQR更适合单个特征。面对多个特征共同形成的异常,我们这里使用孤立森林。
孤立森林是怎么发现异常的?
孤立森林的思路很有意思:异常点数量少,而且位置通常比较孤立,所以更容易被切分出来。
比如正常样本都挤在一起,需要切很多次才能隔离某个点;一个远离人群的异常点,切一两次就能单独分出来。
其异常分数可以写成:
这里 是待检测样本, 表示样本在多棵随机树中的平均路径长度, 是样本数量为 时的路径归一化系数。
也就是说,路径越短,样本越孤立,成为异常值的概率就越高。
完整案例
下面创建一份虚拟回归数据,再人为加入25个异常点。我们不仅要找出异常,还要观察清洗前后回归模型的变化。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.ensemble import IsolationForest
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error

np.random.seed(42)

# 1. 构造正常数据:y = 3x + 8 + 噪声
n_normal, n_outlier = 260, 25
x_normal = np.random.uniform(0, 10, n_normal)
y_normal = 3 * x_normal + 8 + np.random.normal(0, 2, n_normal)

# 人为加入异常数据
x_outlier = np.random.uniform(0, 10, n_outlier)
y_outlier = np.random.choice([-1, 1], n_outlier) * \
            np.random.uniform(18, 32, n_outlier) + 3 * x_outlier + 8

x = np.r_[x_normal, x_outlier]
y = np.r_[y_normal, y_outlier]
data = np.c_[x, y]

# 2. 使用孤立森林检测异常
detector = IsolationForest(
    n_estimators=300,
    contamination=n_outlier / len(data),
    random_state=42
)
label = detector.fit_predict(data)  # 1正常,-1异常
clean_mask = label == 1

# 3. 对比清洗前后的线性回归
model_all = LinearRegression().fit(x.reshape(-1, 1), y)
model_clean = LinearRegression().fit(
    x[clean_mask].reshape(-1, 1), y[clean_mask]
)

x_line = np.linspace(0, 10, 200).reshape(-1, 1)
pred_all = model_all.predict(x_line)
pred_clean = model_clean.predict(x_line)

# 在真实正常样本上评估
mae_all = mean_absolute_error(
    y_normal, model_all.predict(x_normal.reshape(-1, 1))
)
mae_clean = mean_absolute_error(
    y_normal, model_clean.predict(x_normal.reshape(-1, 1))
)

# 4. 绘制复合分析图
fig, axes = plt.subplots(1, 2, figsize=(15, 6))

# 左图:异常分数空间与决策边界
gx, gy = np.meshgrid(
    np.linspace(x.min() - 1, x.max() + 1, 250),
    np.linspace(y.min() - 5, y.max() + 5, 250)
)
score = detector.decision_function(
    np.c_[gx.ravel(), gy.ravel()]
).reshape(gx.shape)

axes[0].contourf(gx, gy, score, levels=25, cmap="turbo", alpha=0.8)
axes[0].contour(gx, gy, score, levels=[0],
                colors="#FFFFFF", linewidths=2)
axes[0].scatter(x[clean_mask], y[clean_mask], c="#00F5D4",
                s=28, edgecolors="black", label="正常点")
axes[0].scatter(x[~clean_mask], y[~clean_mask], c="#FF006E",
                s=80, marker="X", edgecolors="white", label="异常点")
axes[0].set_title("Isolation Forest异常空间")
axes[0].set_xlabel("特征 x")
axes[0].set_ylabel("目标 y")
axes[0].legend()

# 右图:清洗前后回归线对比
axes[1].scatter(x[clean_mask], y[clean_mask], c="#00D9FF",
                s=30, alpha=0.75, label="保留样本")
axes[1].scatter(x[~clean_mask], y[~clean_mask], c="#FF006E",
                s=80, marker="X", label="检测异常")
axes[1].plot(x_line, pred_all, c="#FFBE0B", linewidth=3,
             label=f"清洗前 MAE={mae_all:.2f}")
axes[1].plot(x_line, pred_clean, c="#8338EC", linewidth=3,
             label=f"清洗后 MAE={mae_clean:.2f}")
axes[1].set_title("异常值对回归模型的影响")
axes[1].set_xlabel("特征 x")
axes[1].set_ylabel("目标 y")
axes[1].legend()

plt.tight_layout()
plt.show()

print("检测异常数量:", (~clean_mask).sum())
print("清洗前后MAE:", round(mae_all, 2), "->", round(mae_clean, 2))
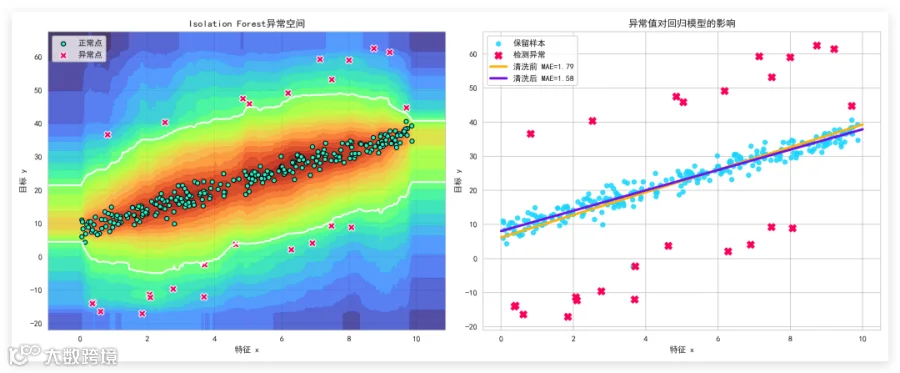
左图不是简单的散点分布,而是把孤立森林的异常评分空间、决策边界和检测结果放在了一起。白色边界外、颜色评分较低的区域,更容易被模型判定为异常。
右图展示了异常值对回归关系的影响。黄色线使用全部数据训练,会被极端样本拉偏;紫色线使用清洗后的数据训练,更接近正常数据的真实规律。MAE的变化则直接反映了清洗是否有效。
这里的contamination表示预计异常比例。如果完全不知道异常数量,可以先尝试0.01、0.03、0.05,再结合业务逐步检查。
最后
异常值处理不是简单地“发现一个、删除一个”,而是先判断它为什么异常,再决定删除、修正、截断还是保留。孤立森林适合处理多维、非线性的异常结构,但检测结果仍然需要结合业务解释。
接下来大家可以继续尝试对比 IQR、LOF 与孤立森林的检测差异,也可以把“直接删除”改成分位数截断,观察不同处理方式对模型指标的影响。