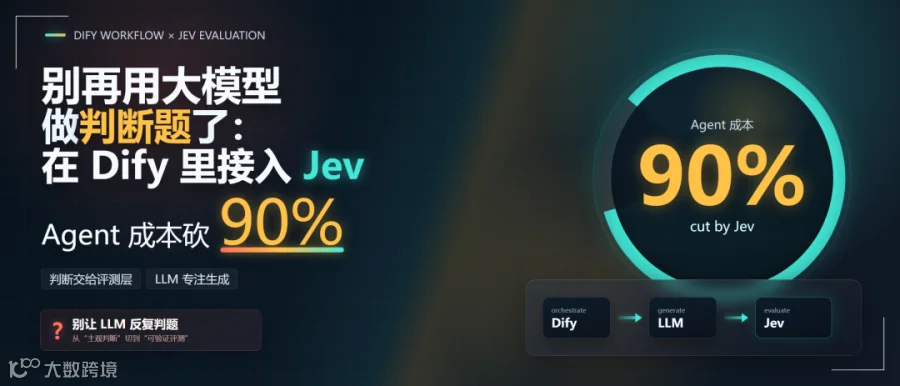
最近在研究 Agent 架构的时候,发现一个很有意思的模型——Jev。
它不能聊天,不会写文章,代码也不写。它只做一件事:下判断。
而且下判断这件事,比大模型快 200 倍,便宜几百倍。
我当时第一反应是:这东西放进 Dify 的 Workflow 里,简直是天作之合。
为什么 Dify 需要 Jev?
用过 Dify 搭 Agent 或 Workflow 的朋友应该有个体感:很多节点其实不需要"生成",只需要"判断"。
举个例子:
-
用户发来一句话,先判断意图类别(咨询/投诉/售后) -
知识库检索回来的内容,判断是否和问题相关 -
LLM 生成的回答,判断有没有幻觉或违规 -
多个工具返回的结果,判断哪个最靠谱
这些节点你现在怎么做的?大概率是塞给一个 LLM 节点,让它输出 JSON,然后祈祷它格式别出错。
问题很明显:
-
慢:一个判断节点要等 3-10 秒,Workflow 叠个五六层,响应时间就上去了 -
贵:每个判断都消耗大量 Token,其中大部分 Token 是在"解释"答案,而不是给出答案 -
不稳定:结构化输出错误率最高到 45.5%,你还得加一层解析和容错
Jev 就是专门解决这个问题的。
30 秒搞懂 Jev
Jev 是前 OpenAI 研究员 Diogo Almeida(ChatGPT 共同发明人、RLHF 核心研究者)创办 TypeSafe AI 后发布的第一个模型。
核心理念来自卡尼曼的《思考,快与慢》:
-
系统 2(传统 LLM):慢思考,擅长推理和生成 -
系统 1(Jev):快判断,擅长分类、打分、是非判断
它只接受三种问题类型:
|
|
|
|
|---|---|---|
| Noul |
|
|
| Choice |
|
|
| Score |
|
|
每次返回都是结构化 JSON,带完整概率分布和置信度,不需要任何解析。
在 Dify 里怎么接?
Dify 接入 Jev 有两条路,根据你的场景选。
路线一:自定义工具(推荐)
最灵活的方式。在 Dify 的「工具」里创建一个自定义 HTTP 工具:
配置要点:
-
API 地址: https://api.typesafe.ai/v1/systemone -
认证方式:Header 传入 Authorization: Bearer {YOUR_API_KEY} -
请求体传入 state(上下文)和questions(问题集) -
响应体直接就是结构化 JSON,下游节点可以直接引用字段
建好之后,在 Workflow 里任何需要"判断"的地方,拖进来就能用。
路线二:HTTP 请求节点
更快的临时方案。直接在 Workflow 里拖一个 HTTP 请求节点,配置和上面一样。适合快速验证想法,但复用性不如自定义工具。
四个实战场景
场景一:智能客服路由
用户消息进来 → Jev 的 Choice 判断属于「售前/售后/技术支持/其他」→ 条件分支路由到不同 Workflow 子流程。
以前这个节点用 LLM,每次调用消耗几百 Token,现在几乎可以忽略不计。
场景二:知识库检索质量把关
RAG 检索回来的片段,先过一遍 Jev 的 Noul:"这段内容和用户问题相关吗?"概率低于 0.6 的直接过滤掉,不送进 LLM。
效果:减少幻觉,同时省掉大量无效的 LLM 调用。
场景三:LLM 输出的质检员
LLM 生成回答后,加一个 Jev 节点做三道检查:
-
Noul:是否包含事实性错误? -
Noul:是否涉及敏感内容? -
Score:回答质量打几分?
不达标的走重试或降级处理,达标的直接输出。成本几乎为零,但整个 Agent 的可靠性上了一个台阶。
场景四:模型路由(省钱大杀器)
先用 Jev 判断任务难度:
-
简单查询 → 路由到便宜的小模型 -
复杂推理 → 路由到 GPT-4o 或 Claude
这一步就能砍掉 60-80% 的模型调用成本。
几个要注意的坑
1. Jev 只做判断,不做生成
别指望它帮你写文案、总结文档。它的定位是决策层,不是生成层。
2. 只支持文本输入
图片、音频不行。如果需要多模态判断,得先用其他模型转成文本再喂给 Jev。
3. 上下文上限 64K Token
state 加上最长的问题合计不超过 32K。绝大多数判断场景绑绑够用了。
4. 开源替代:Nimble
如果不想依赖 API,可以看开源项目 Nimble(基于 Qwen3.5-9B 微调,Apache 2.0 协议),本地部署,准确率稍低但完全可控。
写在最后
Agent 架构演进到 2026 年,大家已经不再追求"一个模型干所有事"。
更细的分工、更低的成本、更可靠的输出——这才是生产级 Agent 的方向。
Jev 不是一个通用模型,它是 Agent 流水线上的"质检员"和"调度员"。把它嵌进 Dify 的 Workflow 里,你会发现那些又慢又贵的判断节点,突然变得又快又便宜。
大模型负责"想",Jev 负责"判",各司其职。
这才是 Agent 该有的样子。
关键词:#Jev #Dify #AIAgent #SystemOneModel #Workflow #模型路由 #智能客服 #RAG优化 #Agent架构 #降本增效
Dify嗨聊