


【从零走向AGI】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址🔗:https://ai-mzq.github.io/From-Zero-to-AGI/[1]
欢迎关注【魔方AI空间】👇
AIGC技术交流社区(涵盖AI绘画、AI视频、大模型、AI多模态、数字人、具身智能等AIGC干货资源及教程)欢迎大家加入:
点击加入「AIGCmagic」交流群 ->>
此前我们介绍过机器人数据中的仿真、合成数据与 Sim-to-Real,也梳理了 MuJoCo、Isaac Sim、Isaac Lab 等具身智能开发工具。
往期推荐:
-
一文讲透2026年具身智能技术栈:VLM、VLA、VLN、世界模型 -
一文梳理 RT-2 到 π0.7:通用机器人策略的技术演进 -
一文通俗讲解具身智能 7 个核心概念:VLM、VLN、VA、VLA、WM、WAM、VLX -
一文通俗理解机器人数据 8 个核心概念:遥操作、示范学习、动作块、仿真、合成数据、Sim-to-Real、数据飞轮、失败回放 -
一文详解具身智能:从大模型到世界模型 一文讲透人形机器人 8 个关键能力:感知、抓取、全身控制、平衡、VLA、世界模型、数据、仿真
一文梳理具身智能必读 6 篇综述:从 VLA、VLN 到世界模型
一文梳理具身智能开发工具地图:模型、数据集、仿真器与评测基准
一文拆解 NVIDIA GR00T:人形机器人基础模型背后的数据、仿真与部署工具链
本文聚焦于机器人 Sim2Real,从一次机械臂抓杯失败出发,拆解仿真与真机之间的差距,以及系统辨识、域随机化、在线适应和真实数据回流各自解决什么问题。
在仿真环境里,机械臂已经连续完成了上百次抓取。
它识别杯子,移动夹爪,稳定抓起,再把杯子放进托盘。训练曲线正常,回放视频也没有明显问题。
同一套策略接入真机后,第一次可能抓空;第二次夹住了,杯子却在抬起时滑落。继续测试,还会遇到动作滞后、机械臂抖动、杯子被碰倒等问题。
模型参数没变,任务也没变。机器人面对的环境变了。
仿真中的物体位置可以直接读取,摩擦系数和质量由开发者设定,控制指令也能准时执行。真实环境中的视觉估计带着误差,物体表面会反光,执行器存在回差,通信与推理还需要时间。
Sim2Real 关注的是:仿真中学到的能力,怎样跨过这些差异,在真机上稳定运行。
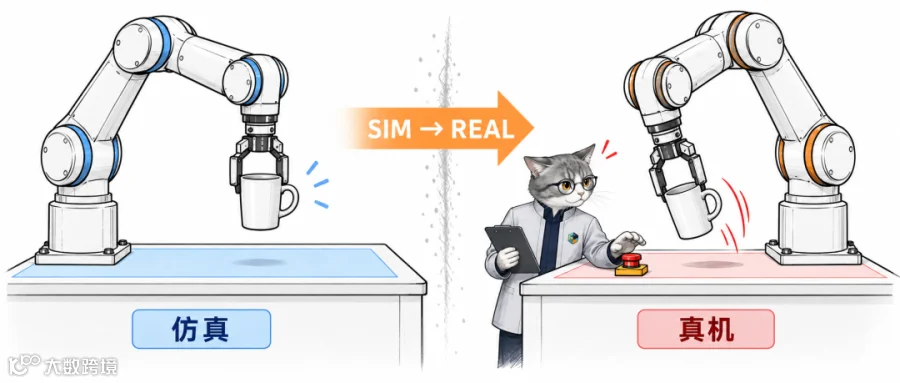
图 1:仿真中的稳定成功,并不意味着策略能在真机上直接复现。
01 Sim2Real:从模型权重到真实控制链路
Sim2Real 是 Simulation-to-Reality 的缩写,通常指模型或策略在仿真环境中训练,再迁移到真实设备运行。
被迁移的可能是视觉模型、行走控制器、机械臂抓取策略,也可能是直接从相机画面和语言指令生成动作的视觉运动策略。
机器人最终要在真实环境中执行动作。画面之外,物理接触、执行器响应、控制频率和通信延迟,同样会影响策略表现。
按真机参与程度,常见路线有三种:
表 1:机器人策略从仿真迁移到真机的三种方式。
工程上通常会组合这三种方式:先在仿真中大规模训练,再用少量真机轨迹校准,部署后继续根据观测调整行为。
与 Sim2Real 相邻的还有三个概念:
· Real2Sim:根据真实机器人或场景重建、校准仿真环境。
· Real2Sim2Real:从真实系统建模,在仿真中训练和扩展,再部署回真机。
· Sim2Sim:在不同仿真器或参数配置间测试迁移,检查策略是否依赖某个模拟器。
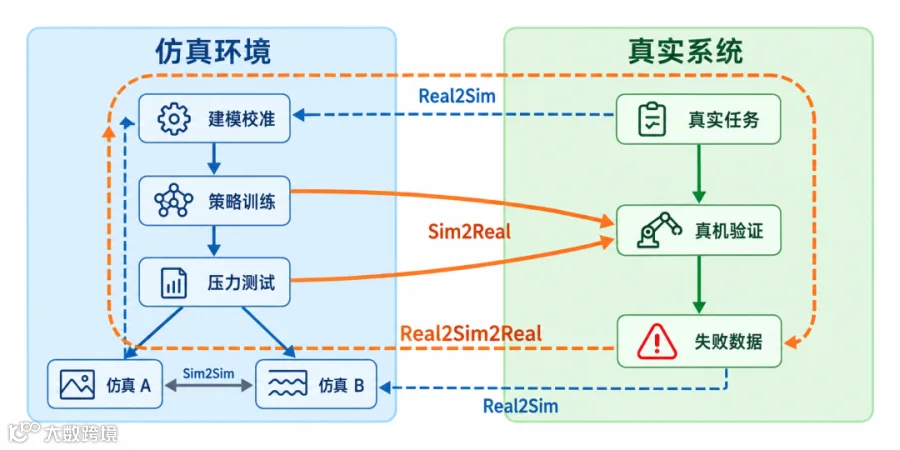
图 2:Sim2Real 负责从仿真迁移到真机,Real2Sim 将真实信息带回仿真,Real2Sim2Real 则把两者连成持续迭代的过程。
02 真机为什么会翻车:六类 Reality Gap
真机上的一次抓取失败,很少只有一个原因。
相机把杯子位置估偏了一点,控制指令又晚到几十毫秒,夹爪落下时,杯子已经不在预期位置。即使抓住了,真实杯面的摩擦力也可能比仿真设定更小,机械臂一抬,杯子便开始下滑。
这些差异大致可以分成六类:
表 2:机器人 Sim2Real 中常见的六类差距。
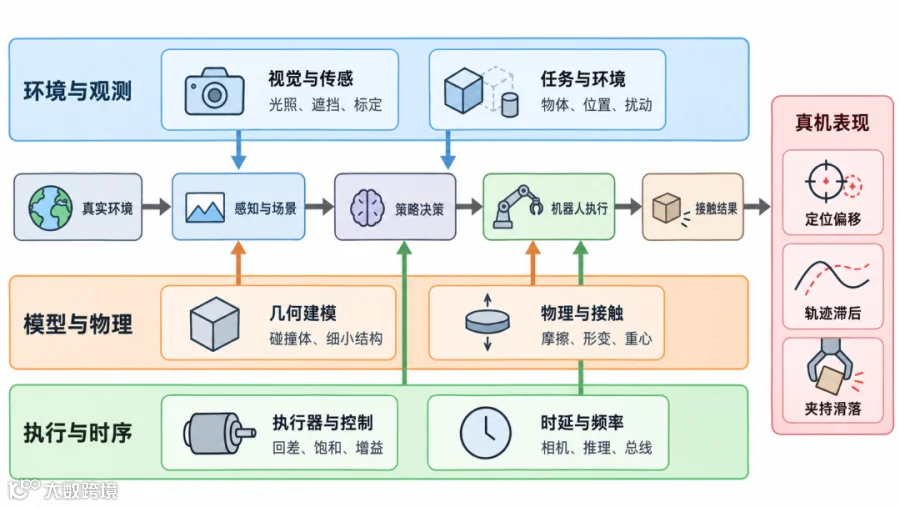
图 3:六类 Reality Gap 会沿着感知、决策、执行和接触链路传播,最终表现为定位偏移、轨迹滞后或夹持滑落。
不同任务对这些误差的敏感点不同。
四足机器人行走更容易受到地面摩擦、冲击和控制时延影响;机械臂抓取依赖准确视觉与稳定接触;插装任务的几何容差很小,对末端定位和力控要求更高;灵巧手还要处理多个手指同时接触、软材料形变和遮挡。
OpenAI Dactyl[2] 使用 MuJoCo 训练灵巧手旋转物体,同时随机化摩擦、阻尼、物体属性和传感器噪声。官方介绍也提到,真实手指材料的形变、肌腱拉伸和接触力,很难被模拟器准确复现。
Reality Gap 是一组沿着感知、决策和控制链路传播的差距。
真机出现问题后,先判断误差来自哪一层,通常比直接扩大模型或延长训练更有效。
03 系统辨识:先校准能够测量的误差
缩小 Sim2Real gap,先从仿真与真机的参数对齐开始。
标定工作包括机器人尺寸、关节零点、夹爪范围、相机内外参、工作台坐标系和碰撞体形状。相机外参如果存在固定偏差,策略学得再好,也可能每次都抓偏同一个位置。
系统辨识(System Identification) 会让真机执行一组已知动作,记录关节、末端和传感器响应,再反推质量、惯量、摩擦、阻尼、执行器动态和控制器增益。

图 4:系统辨识利用真实轨迹与仿真轨迹之间的误差,迭代校准质量、摩擦、阻尼和时延等参数。
SimOpt[3] 把策略训练和仿真参数更新连在了一起。它先在随机化仿真环境中训练策略,再收集少量真实运行轨迹(rollout),根据仿真与真机的行为差异更新参数分布,让训练环境逐渐接近目标机器人。
系统辨识适合处理相对稳定、能够测量的误差,例如相机偏移、关节摩擦、控制响应和夹爪范围。
现实参数也会随温度、磨损、物体和环境变化。把单一参数点校得很准,只能说明模拟器接近特定条件下的设备。剩余的不确定性,还需要更鲁棒的训练方法来覆盖。
04 域随机化:训练时主动加入变化
现实参数无法全部测准时,可以在训练中主动加入变化,这就是域随机化(Domain Randomization)。
2017 年的论文 《Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World》[4] 随机改变仿真图像中的纹理、光照、相机位置和物体布局,只用合成图像训练视觉模型,再将其用于真实世界中的物体定位与抓取。
只要随机化范围覆盖了真实条件,真机环境就可能落入模型见过的训练分布。
用于机器人控制时,随机化通常覆盖四类变量:
· 视觉:光照、纹理、背景、相机位置和遮挡;
· 物理:质量、摩擦、惯量、刚度、阻尼和重力;
· 传感与控制:噪声、延迟、丢帧、控制增益和动作扰动;
· 任务:物体位置、形状、初始姿态和外部扰动。

图 5:随机化需要覆盖真实条件,但范围过窄或过宽都会影响迁移效果。
抓杯子时,可以改变杯子的材质、质量和位置,调整桌面摩擦、相机角度与光照,再给关节状态加入噪声和延迟。策略无法记住某一个杯子或某一条完美轨迹,只能寻找在多种条件下都有效的动作规律。
Dynamics Randomization[5] 将这一思路用于机器人控制,通过随机化质量、摩擦、阻尼等动力学参数训练策略,再迁移到真实系统。
随机化范围并非越大越好。
范围太窄,真实机器人仍可能落在训练分布之外;范围太宽,策略需要兼顾大量不现实的极端条件,训练更难收敛,动作也可能变得过度保守。
更稳妥的做法是根据设备规格、标定误差和少量真机日志确定初始范围,再通过消融实验找到真正影响迁移的变量。
DrEureka[6] 尝试用大语言模型辅助生成奖励函数和域随机化配置,减少人工反复调参;配置是否覆盖真实系统,仍要经过真机验证。
05 在线适应:让机器人识别当前环境
系统辨识和域随机化主要发生在部署之前,真实环境却会持续变化。
同一个杯子装水前后质量不同;四足机器人会从水泥地走到草地;机械关节长期使用后,摩擦与响应也会改变。固定策略只能依赖训练阶段学到的鲁棒性,很难判断当前面对的是哪一种动力学条件。
在线适应(Online Adaptation) 让策略根据近期观测判断当前环境。
单帧图像看不出杯子有多重。但机械臂抬起杯子后,可以从关节响应、末端偏差和连续几帧状态中推断负载变化。历史观测因此成为估计隐藏物理参数的重要线索。
RMA(Rapid Motor Adaptation)[7] 采用了“基策略 + 适应模块”的结构:
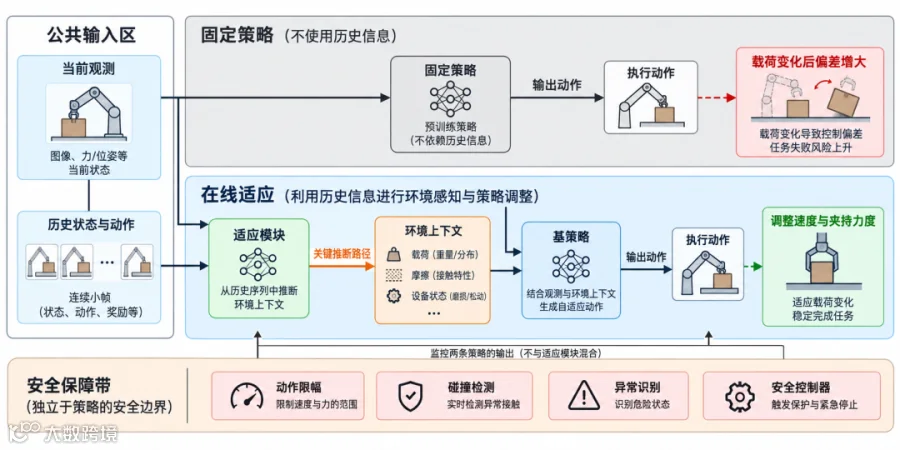
图 6:在线适应利用历史状态与动作估计环境上下文,再由基策略根据当前条件调整动作。
训练时,基策略可以访问摩擦、载荷等仿真特权信息;适应模块再学习如何仅凭机器人近期的状态和动作历史,估计策略需要的环境表示。部署后,机器人便能根据地形、载荷和设备状态调整动作。
机械臂也可以采用类似思路:发现杯子更重或正在滑动后,降低移动速度、增加夹持力度,或者重新调整抓取姿态。
在线重规划和残差控制也经常用于减少迁移误差:前者每执行一小段动作就重新观察,后者保留已有控制器,只让学习模块输出修正量。
在线更新会把新的风险带入控制回路。动作限幅、碰撞检测、异常状态识别和安全控制器必须独立存在,不能完全依赖适应模块。
06 少量真机数据,应该花在哪里?
Sim2Real 追求的是降低真机试错成本,真实数据仍然不可缺少。
仿真无法自行暴露哪些参数范围设错了,也无法呈现模拟器从未建模的现象。少量真实轨迹可以用来定位这些失真,并校正训练分布。
真机数据可以用来:
· 校准相机、关节、执行器和控制器参数;
· 更新摩擦、时延和噪声的随机化范围;
· 收集滑落、碰撞前或定位偏差较大的失败边界;
· 在仿真预训练后进行少量离线微调;
· 检验仿真和真机的失效边界是否一致。
Real2Sim2Real 沿着这条路径展开:先从真实场景获取信息,建立更贴近目标环境的仿真副本;在仿真中并行生成数据、训练策略和复现失败条件;再回到真机验证。
RoboGSim[8] 利用 3D Gaussian Splatting 重建真实场景的视觉外观,再与物理引擎结合,用于机器人操作数据生成和策略评测。

图 7:少量高信息量真机数据用于校准仿真、复现失败,再将新策略送回真机验证。
真机时间应该优先留给高信息量样本:杯子将要滑落时的状态、机械臂差点碰撞时的轨迹、人工接管前后的动作。这些经验比大量相似的成功轨迹更容易暴露策略边界。
07 从仿真到真机,七步部署流程
策略最终要接入真实控制链路。观测和动作接口没有对齐、安全边界没有定义,再成熟的算法也可能在第一次上机时出问题。
第一步:定义任务与安全边界。
明确工作空间、速度、力矩、碰撞区域和急停条件,同时定义成功、失败和中止标准。
第二步:统一仿真与真机接口。
核对观测字段、坐标系、单位、动作范围、控制频率和时间戳。仿真训练中使用的输入,必须能够在真实设备上稳定获得。
第三步:校准可测参数。
先处理相机内外参、关节零点、机器人尺寸、执行器响应、控制增益和基础时延。固定偏差未消除时,扩大随机化只会让问题更难定位。
第四步:确定随机化范围。
根据设备规格、标定误差和真机日志确定上下界,再用消融实验确认哪些变量真正影响迁移。
第五步:做仿真压力测试。
改变物体位置、光照、摩擦、负载、观测噪声、控制延迟和外部扰动,检查最坏条件、失败恢复与长时间运行稳定性。
第六步:分级上真机。
从空载和低速单步开始,再测试固定场景完整任务,逐步增加新物体、新位置和受控扰动,最后进入长时间连续运行。
第七步:记录失败并回流。
同步保存观测、机器人状态、策略动作、控制器状态、时间戳和中止原因。先判断失败属于哪类差距,再决定重新标定、调整随机化、增加在线适应,还是补充微调数据。

图 8:七步流程覆盖安全边界、接口对齐、参数校准、压力测试、分级上机和失败回流。
08 Sim2Real 成功,不能只看一次演示
机器人在镜头前完成一次任务,不等于迁移已经成功。它只能说明机器人在当时的物体、位置、光照和设备状态下完成过任务。
迁移效果至少要看六项指标:
· 任务成功率:多次独立试验中完成完整任务的比例;
· 性能退化:同一任务从仿真到真机下降了多少;
· 鲁棒性曲线:光照、摩擦、载荷和时延变化时,性能怎样下降;
· 恢复能力:抓偏、打滑或受到扰动后,能否继续任务;
· 安全指标:碰撞次数、峰值力矩、急停比例和越界动作;
· 跨条件泛化:更换杯子、桌面、相机位置或测试日期后,结果是否稳定。
Isaac Lab[9] 这类并行仿真框架适合做参数扫描和压力测试,也能在真机前筛掉明显不可靠的策略。但模拟器无法替代真实验收,尤其是接触丰富、存在人员协作或涉及设备安全的任务。
这些方法分别处理不同阶段的误差:
仿真不可能完整复制现实。Sim2Real 更实际的标准是:即使模型、传感器和环境都带着误差,机器人仍能稳定完成任务,并在超出能力边界时安全停下来。
仿真承担大规模试错,真机负责验证结果,也会暴露下一轮仿真仍需补上的条件。

参考链接
1. https://ai-mzq.github.io/From-Zero-to-AGI/:https://ai-mzq.github.io/From-Zero-to-AGI/
2. OpenAI Dactyl:https://openai.com/index/learning-dexterity/
3. SimOpt:https://arxiv.org/abs/1810.05687
4. 《Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World》:https://arxiv.org/abs/1703.06907
5. Dynamics Randomization:https://arxiv.org/abs/1710.06537
6. DrEureka:https://arxiv.org/abs/2406.01967
7. RMA(Rapid Motor Adaptation):https://arxiv.org/abs/2107.04034
8. RoboGSim:https://arxiv.org/abs/2411.11839
9. Isaac Lab:https://developer.nvidia.com/isaac/lab
10. Robot Learning from Randomized Simulations: A Review:https://arxiv.org/abs/2111.00956
11. Crossing the Reality Gap: A Survey on Sim-to-Real Transferability of Robot Controllers in Reinforcement Learning:https://ieeexplore.ieee.org/document/9582891
12. Learning Dexterous In-Hand Manipulation:https://arxiv.org/abs/1808.00177