点击上方蓝字关注我们
因此,把“JEV 们”放入 Agent,比较合适的位置就是这类决策环节:要不要继续任务、点哪个控件、工具是否安全等;并和 LLM 、确定性程序实现分工合作:

本篇对 Agent 系统中 JEV (包括其他类似模型)的典型应用场景做拆解。
01|ReAct 行动循环
常见的 ReAct Agent 是一种推理与行动交替进行、自主完成任务的系统。其核心的 Agent Loop 会不断的做出类似的判断与决策:
目标任务是否已经完成?
我是否应该重试刚才的工具调用?
我是否需要进入HITL的环节,把控制交给人类?
下一步应该调用哪个工具?
这些都是代表性的 Choice 或者 Noul 类型的问题。
通常,这些决定都交给擅长推理的 LLM,很多调用只是在有限”菜单“里选一项。
现在,这正是 JEV 可以尝试的地方:
Agent 保存任务目标、每轮输出和更新状态;JEV 负责从当前可选动作(如结束任务、询问用户、调用某个工具等)中判断下一步动作:
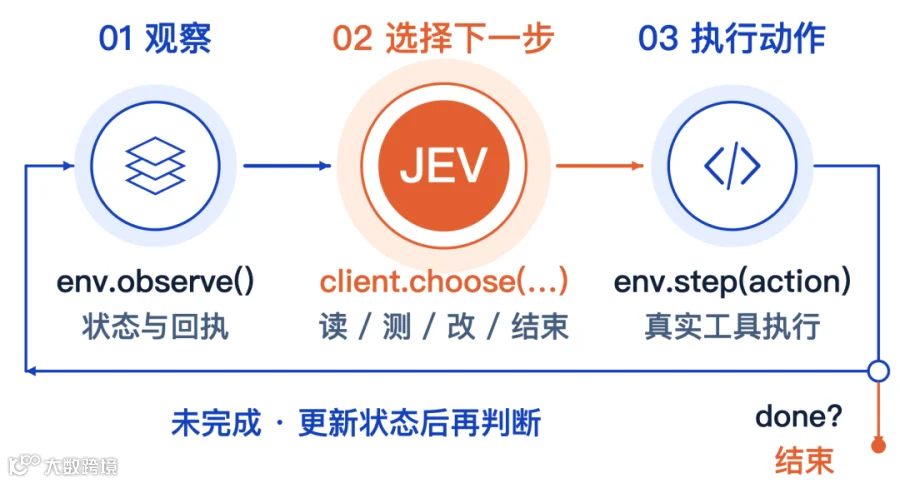
当然, JEV 的答案只是动作建议,完成与否仍然由程序验证;循环上限也由 Agent 代码控制;而遇到要分析复杂状态、生成解决方案的情况,仍需要 LLM。
你可以用一个简单的自定义 Agent Loop 来验证可行性:
给 Agent 设定一个任务,以及一些可用的工具,然后让 Agent 根据当前状态(包括目标、 配置、历史消息等)、候选工具来判断下一步动作,直到完成。模拟如下:
def agent_run(client):
...
    try:
        for_in range(8):
            state = env.observe()
            action = client.choose(state, env.instructions, env.criteria)
            env.step(action)
            if env.done:
...
在这里, “choose”的动作就是交给 JEV 模型来完成的判断。
实际测试中,如果发现在延时上并没有体现出 JEV 的优势,很可能是网络延迟导致;解决方法是使用本地的开源平替,比如 Laya。
在这个场景中,JEV 的主要价值是:用毫秒级的决策模型来让 Agent Loop 控制成本更低,速度更快;也因此可以引入更多的检查环节。
02|Computer Use(Web 自动化)
Web/GUI Agent 已经成为 AI 应用的重要形态。但常见的问题是:消耗资源且延时较大,特别是使用视觉模型辅助的这类 Agent。
这类 Agent 的传统做法都是让 LLM 反复读取页面(DOM 或者截图)、生成下一步操作,长页面和多步任务会不断消耗时间与上下文。
那么,是否可以这样改进:
把当前页面能做的 UI 操作先整理成一个“菜单”(Choices),用 JEV 这类高速决策模型来回答“操作哪个元素、做什么动作”,以指导 Agent 下一步的动作。
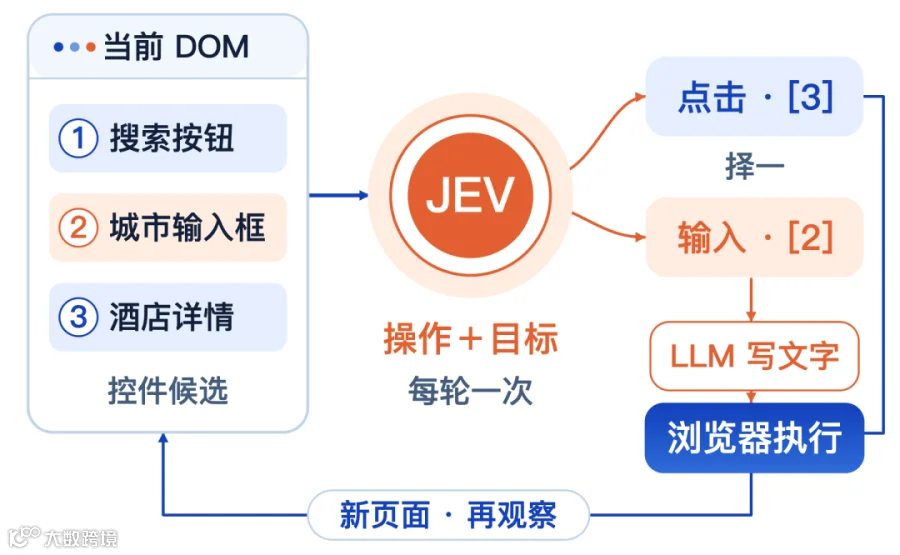
著名的开源项目 Browser Use 已经提供了这样一个开发库:jev-ultrafast。让你可以借助 JEV 来使用 Browser Use 框架实现 Web Agent:
from jev_ultrafast import Agent

with Agent(
   "...web agent 任务“
) as agent:
    for state in agent.run():
        print(state["elapsed_ms"], state["status"])
小编用 jev-ultrafast 做了一个简单演示,完成一个酒店搜索的任务:
GOAL = ("Search for hotels in Hangzhou. Set the nightly budget filter to CNY 500 or less "
        "and enable the breakfast-included-only filter, then apply the filters. "
        "Open the matching hotel's details and verify that its city is Hangzhou, "
        "its nightly price is at most CNY 500, and breakfast is included. "
        "Stop on that details page. Do not make any booking.")
这里使用 jev-ultrafast 的 Agent 等相关 API 来完成任务,对其每一步的选择(choose)进行了跟踪,并输出最后的停留页面:
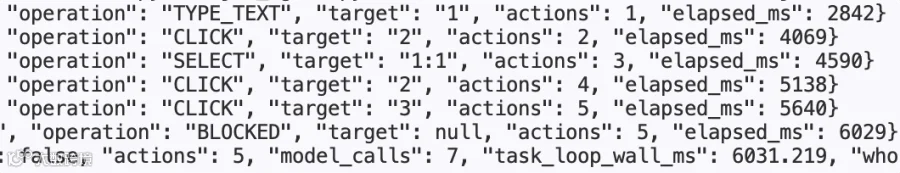
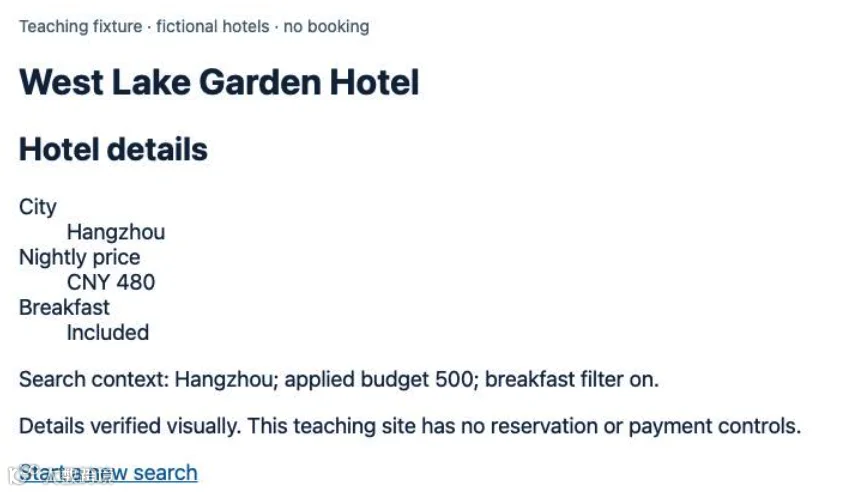
当然,这种方案目前并不完美:
遇到未暴露为可选元素的控件、需复杂视觉识别的场景或开放文本等,仍需要浏览器能力和多模态的 LLM 配合。不过这也让我们更加期待多模态的“JEV”们的出现。
03|工具与技能路由
工具(Tool)和技能(Skill)体系是 Agent Harness 最重要的组成之一。
传统 Agent 把每个工具的描述和技能都塞进模型上下文,然后让模型判断并生成工具调用;工具目录越大,描述越长,相近工具越容易混淆,且 Token 消耗越大。
借助 JEV 这样的决策模型,Agent 可以:
把“需要哪些工具”变成一个 Choice 问题:基于“分层路由”(Hierarchical routing)的模式,实现像医院分诊一样的工具选择路径 — 尤其当工具集稳定、用途清晰时。
先选医院(工具大类),再选科室(激活工具集),再找医生(本轮工具)。
这对于平台级的 Agent 来说(工具目录经常动态变化),可以让模型看到一个更小、更相关的工具范围,减少干扰,提高推理准确性。比如:
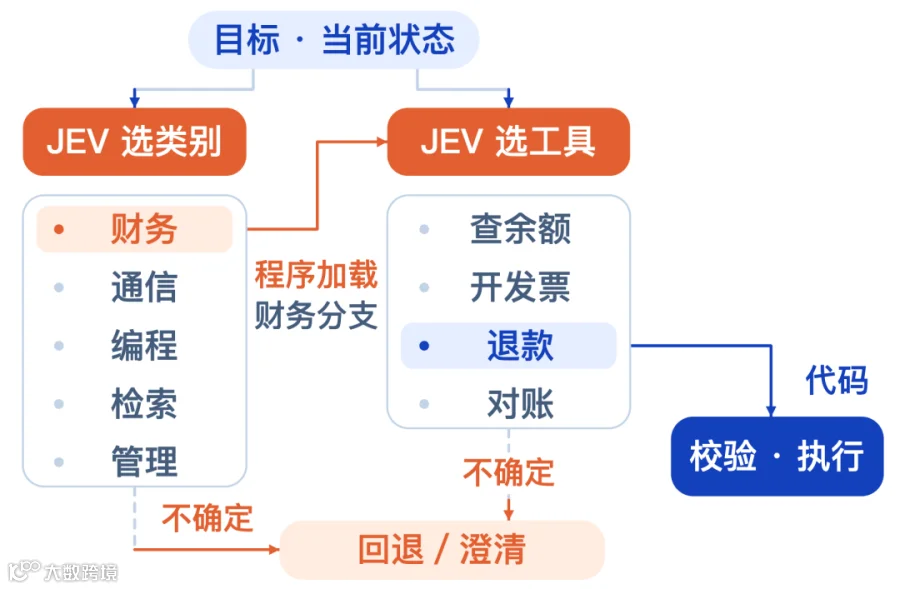
第一层让 JEV 从“公共、财务、编程、检索、管理”等类别做选择。选中“财务”后,程序再加载这个分支;让第二个 Choice 从“查询余额、开发票、退款、对账”中再选一个。
当然,在具体实现时,需要做更精细化的控制和评估:
结合confidence(置信度):拿不准就保留多个候选继续比较,或让用户澄清;每层也要有“不匹配”的出口,避免第一步选错就一路错到底。
分层能缩小选择范围,但代价是增加误选或遗漏;使用决策模型后是否真的更快、更准,需要在上线前做批量评估。
JEV 的 Choice 单题最多支持 255 个选项,并非有几十个工具就必须分层。
04|工具安全守卫
随着各种通用 Agent 的盛行,给这些 Agent 的工具执行设置安全“门禁”至关重要。常见的方法有:
给工具设置安全级别:严重的要求人工审核,但容易被“忽视“
关键词拦截:根据工具、参数等识别关键词,但容易“误伤”
交给 LLM 判断:频繁审查增加延迟和成本,而且同一模型审查意义不大
更稳妥的架构,是在工具执行之前设一道语义守卫:
根据本次调用和对话状态判断工具风险,据此放行或拦截;当风险不确定或后果严重时,也可以转入人工环节。
这个工作就很适合 JEV 这样的快速模型。比如提出 Noul 类型且有明确标准的问题:“是否包含提示注入?”、“是否泄露敏感信息?”、“输出是否违反约定?”等,然后返回概率,再由程序决定放行、拦截或交人类复核:

LangChain 已经把这个模式用中间件(一种类似钩子的机制)进行了封装:AutoModeMiddleware。它在工具执行前调用 JEV,风险达到阈值就返回拦截消息:
guard = AutoModeMiddleware(tools=tools)
agent = create_agent(planner, tools=tools, middleware=[guard])
result = agent.invoke({"messages": [HumanMessage(content=task)]})
你也可以自定义一个工具门禁:实现一个 Middleware,然后在 wrap_tool_call 中借助 JEV/Laya 做判断处理。比如:
class LLMAutoMode(AgentMiddleware):
    ......
    defwrap_tool_call(self, request, handler):
        answer = self.judge.invoke(...);
        if answer.risk_estimate >= 0.5:
            return ToolMessage(
                content=(f"The tool call `{request.tool_call['name']}` was blocked because "
                         f"it was classified as risky (LLM estimate: {answer.risk_estimate:.2f}). "
                         "The tool was not executed."),
                tool_call_id=request.tool_call["id"], name=request.tool_call["name"], status="error")
        return handler(request)
在这里,借助决策模型的优势是 —
你可以在一次任务中做很多这样细小的风险检查,而不用担心延迟与成本。
但正如我们之前强调的,JEV 们宣传的“无幻觉”不代表不会决策错误,所以结合使用其他的一些风控机制,仍然是必要的。
05|Agent 任务评估与观测
当 Agent 报告任务已经完成,大部分时候我们会选择“信任”它 — 再通过人工审查、代码测试等方法来评估其完成度。
还有一个常见做法是请另一个 LLM 当“评委”:
读取 Agent 的执行轨迹,并给出评估结果。不过这种评估大多缓慢且结果非结构化。
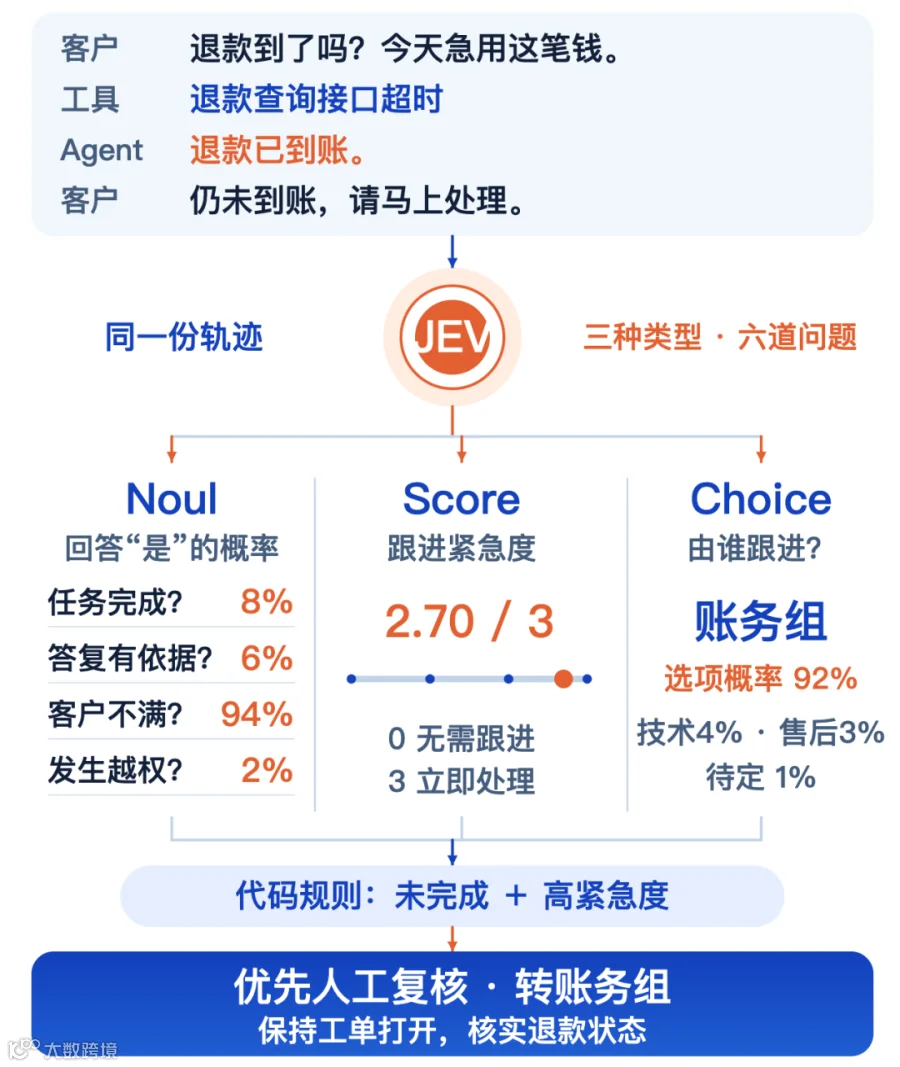
现在,借助 JEV 这类模型可以把评估拆分成更具体的问题:
用 Noul 检查任务是否完成、是否违规、是否需要人工复核;用 Score 评估任务完整程度、问题紧急程度;用 Choice 告诉你是完成、重试、放弃还是人工复核。

06|模型与 Agent 路由
给定请求、候选模型以及判断标准(各模型擅长的任务),让 JEV 帮你选择合适的处理者,给出建议与概率。
你还可以结合任务难度、风险与不确定性等制定分流标准。
当然,如果把候选从 LLM 换成“研究、编程、数据分析”等专业 Agent,同样可以用于 Agent 任务的分派与交接(意图识别)。

在具体的实现中,结合 Confidence 置信度进行一些保护也是必要的,而不是简单的选取概率最高者 — 路由错误导致的返工或质量的代价,要远大于一次路由的代价。
LangChain 官方也实现了这样一个 Middleware:ModelRouterMiddleware,可以很方便的让 Agent 具有根据复杂度选择合适模型的能力:
router = ModelRouterMiddleware(choices={
    "fast": ModelChoice(model=fast, criteria="单笔查询"),
    "powerful": ModelChoice(model=powerful, criteria="多约束规划"),
}, instructions="选择能完成任务且成本最低的模型")
agent = create_agent(fast, tools=tools, middleware=[router])
这里的 criteria 参数告诉路由器各模型适合的任务,也就是分流的判断标准。其目前的机制是:在一次 Agent Loop 运行开始时根据最新的用户消息选择模型,后续则复用。
07|RAG 与上下文管理
RAG 管道的价值大部分时候并不取决于模型,而是数据或知识的质量,以及检索的相关性与完备性。而基于向量相似性的语义检索并不足以解决这个问题,这也是出现众多高级 RAG 方法(C-RAG,Self-RAG等)的根本原因。
一种常见的优化思路是用 LLM 对语义检索的结果进行相关性判断,并根据结果进行必要的知识筛选、补充(比如 Web 搜索),或 Query Rewrite。
现在你可以借助 JEV 等决策模型:
让它充当检索知识进入上下文前的“筛选员”,对知识相关度进行评估与过滤。
很显然,JEV 模型非常适合回答这类问题:
Noul:这段知识是否能够支持回答输入问题?
Score:这段知识与输入问题的相关程度如何?
Noul :这些知识是否足够回答用户的输入问题?
根据这些问题的答案,你可以选择废弃不相关知识,或补充更多知识:

大致的程序处理逻辑如下:
...
def rag(question, retrieve, llm_answer, client):
    # jev判断是否相关
    def judge(instructions, **state):
        return client.system_one(
            state=state,
            questions={"ok": Noul(instructions=instructions)},
        ).nouls["ok"].noul

    kept, seen = [], set()
    for _ in range(3): # 最多三轮检索
        for chunk in retrieve(question, exclude=seen):
            seen.add(chunk.id)
            if judge("片段包含回答问题所需的信息吗?",
                     question=question, chunk=chunk.text) > 0.5:
                kept.append(chunk)

        # jev判断知识是否足够
        if kept and judge("这些知识足够回答问题的所有要点吗?",
                          question=question,
                          evidence=[c.text for c in kept]) > 0.8:
            return llm_answer(question, kept)

    return"资料仍不足,需要补充信息"
所以,现在你可以构建一个两阶段的检索策略:
先做更宽泛的检索(比如 Top_k=10);然后借助决策模型做低成本的筛选;最后将选中的知识用来生成答案。
另外,你可以使用决策模型输出的概率来实现类似排序模型(Rerank)的能力:

这里的评分可以使用 Noul 输出的概率,也可以使用 Score 评分并结合置信度。
这套思路也能用于 Agent 的上下文管理。方法很简单:
让 JEV 判断旧的对话记录是否仍有用,再由程序来执行保留或废弃;而不是直接让 LLM 去做历史对话的摘要 — 容易带来上下文丢失。
GitHub 上有一个 Claude Code 插件fast-jev-compaction ,其通过评分来废弃无用的工具调用及结果,只保留重要内容,从而达到精简上下文的目的。
08|实时动态决策
最后是一个收益最大的场景:实时决策。
在游戏、仿真、机器人等环境里的 AI 需要极其快速的反应(毫秒级):下一步应该怎么做?因为每走完一步,下一步的“路”可能就变了。
如果让 LLM 每轮从头推理,则性能无法满足要求(想象下,游戏里的 NPC 每次要思考 5 秒才有反应);而使用固定规则又不够智能。
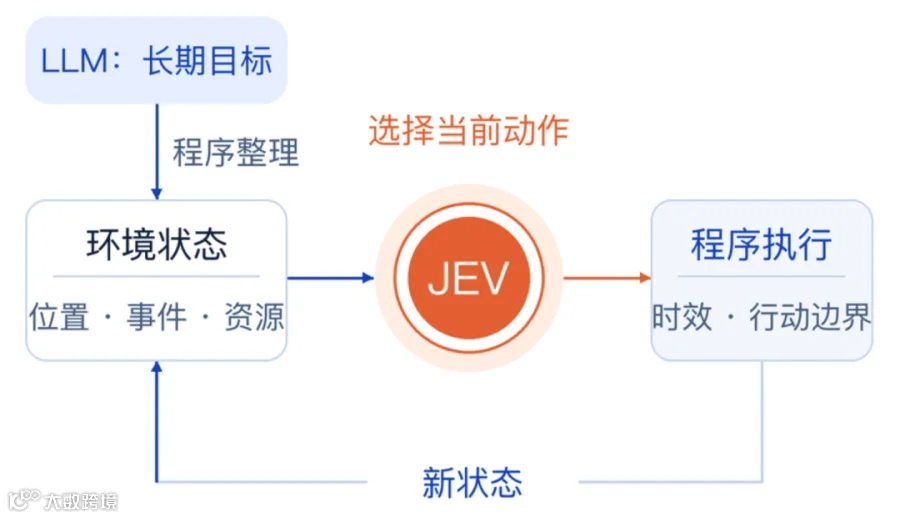
现在你可以让 JEV 们和 LLM 们来配合:
LLM 负责长期的目标规划 。比如完成任务的主要步骤;JEV 负责在每一步骤中,根据环境状态做出可能需要的快速判断;
举一个例子:
一个仓库配送机器人要完成“把某个包裹送到打包台”。
LLM 可以拆解并规划出路径:确认包裹 → 前往货架 → 取件 → 运到打包台。
但是执行到一半,通道被货物挡住,此时则由 JEV 来根据当前环境、位置、可选动作来判断下一步怎么做。
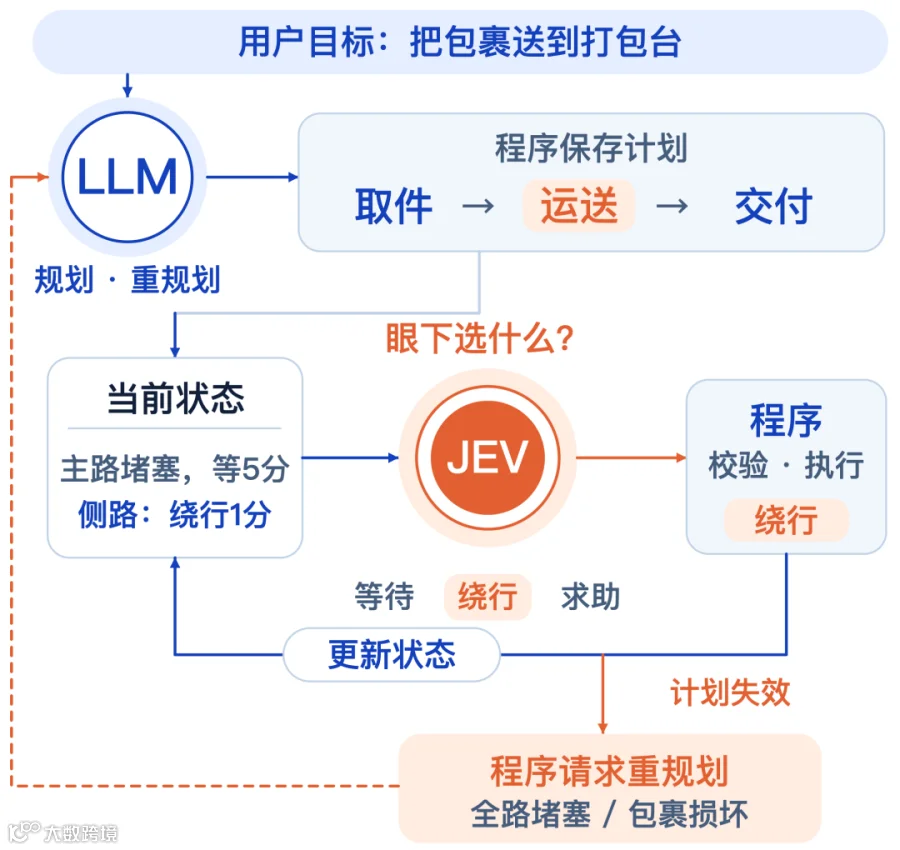
这里的状态(State)可以来自游戏引擎、环境传感器或 API 接口等;而程序的执行通常由专用的控制系统负责。
不过由于当前的决策模型还不支持视觉理解,这也在很大程度限制了其应用;相信随着未来多模态能力的解锁,将带来这类快速反应系统能力上的突破。
总结
以上是我们为大家拆解的 JEV (包括其他类似的开源模型)在 Agent 系统中的一些典型应用场景。
总结来说,JEV 很适合 Agent 里高频、高性能、答案有限的判断与决策。
更多应用层面的场景,如意图识别、邮件分类、工单分流、内容打标等,都能沿用这套思路 — LLM 做规划生成,JEV 做高速判断,程序则负责确定性执行;以减少不必要的 Token 开销,提高决策速度,并由此产生更多收益。