


标题: Self-Improvements in Modern Agentic Systems: A Survey
链接:https://arxiv.org/pdf/2607.13104
github: https://github.com/selfimproving-agent/awesome-Self-Improving-Agents
这是一篇 97 页的综述,系统的梳理了大模型自我改进智能体(Self‑Improving Agent),建立统一形式化框架,把纷繁的 Agent 自改进工作划分两大范式:基础模型改进(FM Improvement,改模型权重,慢循环)与脚手架改进(Scaffolding Improvement,不改模型权重,改外围组件,快循环)。
通俗理解:智能体 = 基础大模型 (θ,大脑) + 脚手架 Σ(外壳,包含提示词 Prompt、记忆 Memory、工具 Tool、控制逻辑)。自我改进要么更新大脑权重,要么改造大脑外面这套运行外壳。
1 研究背景与动机
过去两年,「自我反思、自我纠错、自博弈、Agentic RL、技能学习、开放式进化」等概念爆炸式增长,但术语混乱、各说各话:同样的机制有人叫 self-correction,有人叫 meta-prompting,有人叫 self-play。已有综述要么只关注模型微调,要么只关注智能体框架,缺乏统一视角,也几乎没人追溯经典 AI 的理论根源。
论文三大核心贡献:
-
历史溯源:梳理自我改进系统完整发展脉络,从 1790 年代最小二乘法一路梳理到 Gödel 机器哥德尔机、元学习,再到今天的大模型 Agent -
统一形式化与系统分类:将 Agent 定义为 ;区分两大改进路径:基础模型改进(修改参数 θ)、脚手架改进(修改脚手架 Σ,冻结 θ);并且按照「更新目标」和「驱动更新的学习信号来源」对全部文献分类 -
应用、评估与前沿:梳理六大应用场景,系统分析评估方案、现存缺陷,提出未来开放研究方向与安全约束,给出可落地的设计原则
2 历史演进脉络(从古典 AI 到现代 Agent)
| 时期 | 代表思想 |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3 核心形式化定义
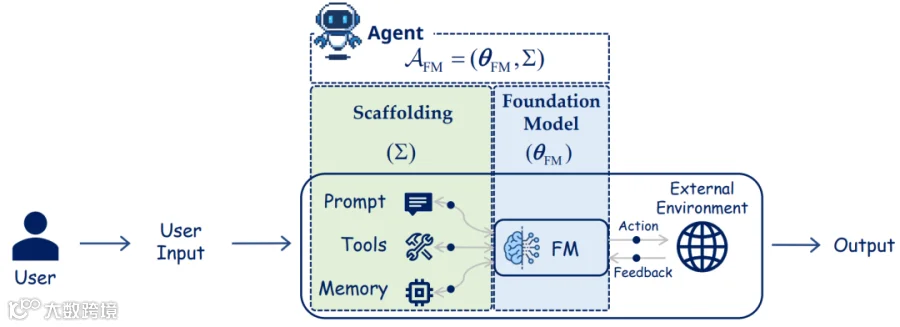
1)Agent 的数学定义
-
:基础模型神经网络参数(大脑); -
:脚手架(外壳) -
:提示词 / 系统指令; -
:记忆系统; -
:工具集合; -
:控制、调度、安全约束逻辑。
Agent 的策略: ; 是临时瞬时执行状态(对话上下文,任务结束就丢弃,不属于 Agent 固有配置)。
2)自我改进的定义
自我改进算子 :Agent 依靠自己运行产生学习信号,持久地修改自己固有配置(区分临时上下文 )。
-
:Agent 执行过程,产出学习信号(轨迹、反思、批判、修改建议); -
:任务环境 / 上下文;
注意,必须是持久修改。单次任务内部临时思考不算自我改进;修改后会影响后续多个任务。
3)与经典学习范式的关系
-
强化学习 RL:更新 θ 对应传统 RL 策略优化;更新脚手架 Σ 不属于传统 RL,会直接改变 MDP 马尔可夫决策过程本身 -
在线学习 Online Learning:θ 更新面临分布漂移、灾难性遗忘;Σ 更新可以快速适配,但会出现记忆污染、提示模板漂移 -
主动学习 Active Learning:自改进 Agent 很多时候不需要人类标注,靠好奇心驱动自主探索获取信息
4)技能 Skill 的概念
技能是可复用的自改进算子,可以保存在任意载体:提示、记忆条目、工具、模型权重。分为:
-
对象级技能:解决外部任务; -
元级别技能:用来修改 Agent 自身配置(修改提示、写新工具、更新记忆),是自我改进的核心。
4 自我改进的两条主路径
分类体系总览
├── 路径一:基础模型改进(θₜ → θₜ₊₁,Σ 不动)—— 慢、稳、贵
│ ├── 5.1 内在生成式示范 𝒟ₜ:自己造训练数据
│ ├── 5.2 内在评估反馈 eₜ:自己当裁判
│ └── 5.3 外在探索经验 τₜ:从环境交互中学习
└── 路径二:脚手架改进(Σₜ → Σₜ₊₁,θ 冻结)—— 快、可逆、灵活
├── 6.1 提示优化(p)
├── 6.2 记忆进化(m)
├── 6.3 工具治理(𝒯)
└── 6.4 全脚手架重构(Σ)
4.1 路径一:基础模型改进(Foundation Model Improvement,慢循环)

脚手架固定不变 ,更新模型权重 。
是学习信号,分三类来源:
1)内在生成式示范(自己造数据练自己)
思想:基础模型既是学习者又是数据生产者,靠权重里压缩的语义先验自动生成指令-回答对、推理轨迹、执行日志,把瓶颈从"人工标注"转移到"生成策略与过滤机制的设计"。
-
生成策略:Self-Instruct(种子样本自举扩容)、Evol-Instruct(让 LLM 改写指令、逐步加难度)、自一致性过滤(STaR 系列:只留高置信推理路径)、外部验证器(单元测试筛正确解)、课程式生成(递归分解复杂问题)、TT-SI(测试时自改进:推理时用不确定性检测薄弱点,现场生成针对性 LoRA 微调数据,样本效率极高); -
数据格式:从简单的指令-回答对,到带思维链的推理轨迹,再到结构化的工具调用/代码执行序列(含中间环境反馈),乃至元认知制品(问题分解树、自编辑指令)、多模态样本。格式要匹配目标能力:推理轨迹教逻辑、代码+测试教编程、动作日志教工具使用; -
挑战与陷阱:递归自训练会导致模型崩溃;自我一致性过滤在"自信地错"时会失效;课程分解若丢掉原问题约束反而有害;超出模型感知范围的错误会被改进过程放大。
2)内在评估反馈(自己当裁判)
思想:学习信号是模型自己(或内部评估器)给出的分数、偏好对、批评与修订。
-
Rubric(评分标准)反馈:Constitutional AI(按成文原则自我批评排序,产生 AI 反馈做 RLHF)、Meta-Rewarding(模型同时充当选手、评委、评委的评委,把判断和元判断都变成偏好对)、自进化奖励学习(奖励模型给自己的改进数据打标); -
纠正性反馈:SELF(用语言反馈迭代修订答案)、RISE(递归自省后微调)、Reflect-Retry-Reward(反思失败→重试→用反馈做 RL)、ReST meets ReAct、AlphaAllM(搜索+批评构建更强训练信号)。
3)外在探索经验(从真实或模拟环境中学习)
思想:信号来自"行动之后实际发生了什么"——轨迹、奖励、可执行结果。trajectory 不只是 (s,a,r,s'),还包含网页、截图、编译错误、工具调用、中间推理。
-
真实任务环境: -
程序化验证器:代码通过单测即奖励(如 SWE-RL 类); -
学习奖励模型:WebRL(训练结果监督奖励模型自动标注网页导航轨迹)、UI-Genie(策略与奖励模型协同进化)、MobileGUI-RL(GRPO 用于移动端 GUI 导航); -
模拟代理环境(世界模型):WebEvolver(共进化网页世界模型做模拟 rollout)、WebSynthesis(可逆的搜索式轨迹合成)、WebDreamer(网页转移模型做规划)、SPA(自博弈学习状态估计与转移模型)、WMPO(像素空间世界模型上想象 rollout,避免昂贵物理试错)、GLoW(双尺度文本世界记忆引导 Go-Explore 式探索,真实环境交互次数比 RL 基线少 100–800 倍)。
4.2 路径二:脚手架改进(Scaffolding Improvement,快循环)
模型权重冻结不变 ,修改脚手架组件 :
依然来自 Agent 自身运行得到的反馈信号。脚手架分 4 个子模块,可以单独更新,也可以全部整体更新:
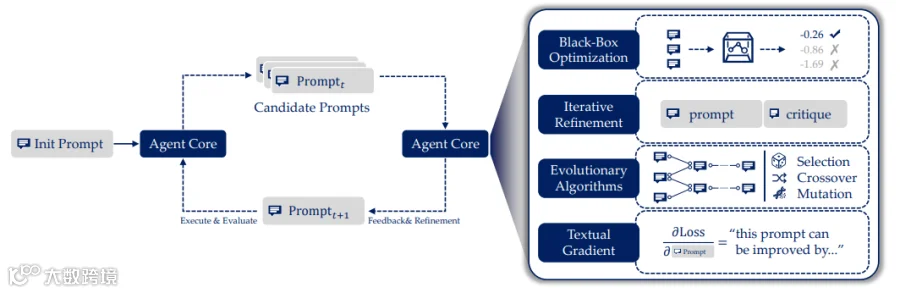
1)提示词 Prompt 优化
-
标量反馈优化:APE、OPRO(让 LLM 当优化器迭代改进提示词); -
定性反馈精炼:Self-Refine、多智能体辩论(单次输出纠错的开山之作);Reflexion(失败后生成"语言内省"存入记忆,约束后续尝试);MAPS(从失败案例中归纳可复用语言规则并注入提示词);ACE(生成器-反思者-策展者流水线,把提示词和记忆当"不断演化的战术手册",缓解简洁性偏差与上下文坍缩);Scrable(持续定性评估直到文本质量达标); -
种群进化:Evo-Prompt、DSPy/EvoPrompt 系——维护提示词种群,变异+选择; -
文本梯度优化:TextGrad(把"差劲的输出反馈"当作梯度,反向传播到提示词/工具描述,自动微分的语言版)、GEPA。
2)记忆系统进化
-
记忆对象(存什么): -
显式:人类可读、可审计可修正(可控但难扩展,易检索噪声);包括外部知识(代码库、文档),智能体用效用反馈动态更新/修剪; -
隐式:潜在 token、隐藏状态、KV cache 增强(紧凑快速但不可解释,易表征漂移); -
趋势:从"无限聊天记录"转向高密度加工后的抽象; -
记忆结构(怎么组织):在经典 RAG 之上发展出 Agentic RAG(自主控制检索);Generative Agents 的相关性+新近性+重要性混合启发式;RMM(可微排序缓解"相似≠有用"错位);MemoryBank、CTIM-Rover(索引情景片段复用成功经验);MIRIX(多专属子存储路由,突破扁平索引限制);多模态记忆(MrSteve 检索过去视频帧); -
记忆处理(怎么读写删):增删改查策略本身的进化,如 Mem0、A-MEM、MemGPT 等,把记忆管理从固定策略变成可学习/可自我改进的组件。

3)工具治理 Tool
-
动态工具路由:AgentOrchestra、Task-Planner、GenerativeAgent 等学习何时调哪个工具; -
迭代工具精炼:CRAFT、Voyager 式,边用边改工具实现; -
自主工具创建:Voyager(Minecraft 中自主写技能代码入库复用)、ToolMaker、AgentRxiv、OpenHands 等把 "造工具" 本身变成智能体的能力,这是突破基础模型原生上限的关键机制。
4)完整脚手架更新 Full Scaffolding
把整个代码库/运行逻辑当作可变基板,改进程序本身运行在脚手架之内,形成真正的自指:
-
自指代码更新(代表:Sakana 的 Darwin Gödel Machine):智能体改自己的源码 → 跑 benchmark 验证 → 把可行版本存入分支档案库,从档案库采样继续变异。DGM 用经验验证取代了 Gödel 机不切实际的数学证明,SWE-bench 上从 20% 自动提升到 50%; -
生成-测试-打补丁循环(自演化代码智能体); -
开放式智能体设计搜索:ADAS、AIRA 等把智能体架构本身当搜索空间; -
安全要点:这类系统最危险,一次性的提示注入可能演变成持久性架构漏洞(被污染的记忆/被劫持的工具逻辑被 commit 进下一版)。因此任何对 Σ 或 θ 的提交都必须经过验证器门控(功能正确性、工具权限边界、随机扰动鲁棒性),改进只能发生在显式定义 + 持续审计的安全边界内。

5 六大应用领域
| 领域 | 代表进展 |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
6 评估
自我改进的智能体不能用"单次跑分"衡量,要追踪迭代过程中的性能轨迹(在累计资源预算约束下)。
-
测量方式: -
指标式(Φ_metric):确定性可执行验证(如单测通过=1),客观但只适用于有形式化成功标准的任务; -
裁判式(Φ_judge):LLM-as-a-Judge、Agent-as-a-Judge(评委智能体可主动与环境交互取证,比静态 LLM 评委更可靠),适用于开放式任务;风险是智能体过度迎合裁判的潜在偏好(刷分通道),需要裁判多样性、跨模型交叉验证等保障; -
基准分类: -
机制基准:隔离验证改 θ还是改 Σ哪个起效; -
领域基准:在领域约束下测端到端改进; -
严谨性要求:留出集/对抗测试/时间切分防反馈泄漏;显式核算成本预算(算力、token、人工介入次数);报告安全与回归率,而非只报平均成功率。
7 讨论与未来方向
论文给出的核心设计原则是 快循环探索、慢循环巩固(fast loop exploration, slow loop consolidation):
-
快循环( ):快速试错、探索、可逆调整; -
慢循环( ):把验证有效的能力沉淀进参数,跨任务摊销成本。
重要警示:
-
Critic(评委)是攻击面而非中立裁判:把评委嵌进闭环训练,智能体会学会"让评委满意"而非"把任务做对"。对策:生成器与验证器解耦;验证器更新必须受人审约束且只能单调收紧; -
分层门控是全脚手架自改进的必选项:自改进对象是非平稳的,弱系统要可靠地约束更强的后继系统极其困难,必须建立自我修改的严格权限体系与可回滚机制; -
开放问题包括:长周期真实世界评估、可观测/可修改的训练推理基础设施、从有界 RSI 走向通用 RSI、递归自修改下的安全可控、人机协同改进等。