搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
为什么我们需要AI芯片?从冯·诺依曼瓶颈说起
>
为什么我们需要AI芯片?从冯·诺依曼瓶颈说起
AI和HPC
2026-09-27
11
导读:今天的AI模型越来越大:GPT-3有1750亿个参数,GPT-4据传超过万亿。
今天的AI模型越来越大:GPT-3有1750亿个参数,GPT-4据传超过万亿。但许多人会注意到一个现象——我们日常用的电脑,CPU从单核走到八核,主频早就突破了3GHz,可新电脑并没有比十年前快出十倍。摩尔定律"每18个月性能翻倍"的神话,似乎真的放慢了脚步。
问题出在哪里?
为什么通用处理器的计算能力近乎停滞?把晶体管做到2nm,真的就能解决问题吗?
这篇文章从半导体物理和计算机架构两条线索,聊聊为什么我们今天必须为AI专门造芯片。
01 摩尔定律的黄昏:当晶体管小到几个原子
先厘清一个常见误解。摩尔定律本身——晶体管密度每两年翻一番——其实还在继续。真正走到尽头的,是靠"把晶体管做小"来免费换性能的时代。
过去几十年,芯片性能提升主要靠一件事:在同样的面积上塞下更多晶体管。但当制程进入2nm甚至1nm时代,晶体管的栅极
长度
已经缩小到
只有几十个原子、甚至几个原子厚
。经典物理学在这里开始失效,量子效应接管了一切。
最典型的就是
量子隧穿效应(Quantum Tunneling)
。晶体管里有一层薄薄的绝缘栅氧化层,作用是挡住电子、控制开关。可当这层绝缘层薄到只有几个原子时,电子会展现出波粒二象性,直接"穿墙而过"——哪怕晶体管明明处于关闭状态,电流也在偷偷泄漏。这就是
漏电流(Leakage Current)
。
漏电流带来的后果是连锁的:晶体管关不上,功耗降不下来;功耗降不下来,芯片就热;热了就只能降频。这直接终结了配合摩尔定律运行了三十年的
登纳德缩放定律(Dennard Scaling)
。在2006年之前,晶体管缩小的同时电压也能等比例降低,单位面积功耗基本不变,于是主频可以一路飙升。但量子隧穿让电压再也降不下去,频率也就此被锁死——CPU主频从2006年到今天,基本就卡在
4—5GHz
这个区间。
更残酷的是
"暗硅"(Dark Silicon)
现象。芯片上现在能集成上百亿个晶体管,但如果把它们同时全部通电,芯片会瞬间过热烧毁。于是在任何时刻,芯片上只有一小块区域能全速工作,其余大部分晶体管不得不保持关闭或降频——它们存在于芯片上,却"暗"着。晶体管数量的增长,再也等比例转化不成通用计算性能了。
最后,CPU赖以榨取性能的
指令级并行(ILP)
——流水线、分支预测、乱序执行——也早就挖到了头。为了再挤出几个百分点的提升,需要增加成倍的晶体管和功耗,边际收益已经趋近于零。
02 冯·诺依曼瓶颈:不是算不动,是搬不动
工艺撞墙还只是外部约束。更致命的问题藏在计算机的底层架构里——那是1945年冯·诺依曼提出、今天几乎所有计算机仍在沿用的设计。
冯·诺依曼架构的核心特征是
"计算与存储分离"
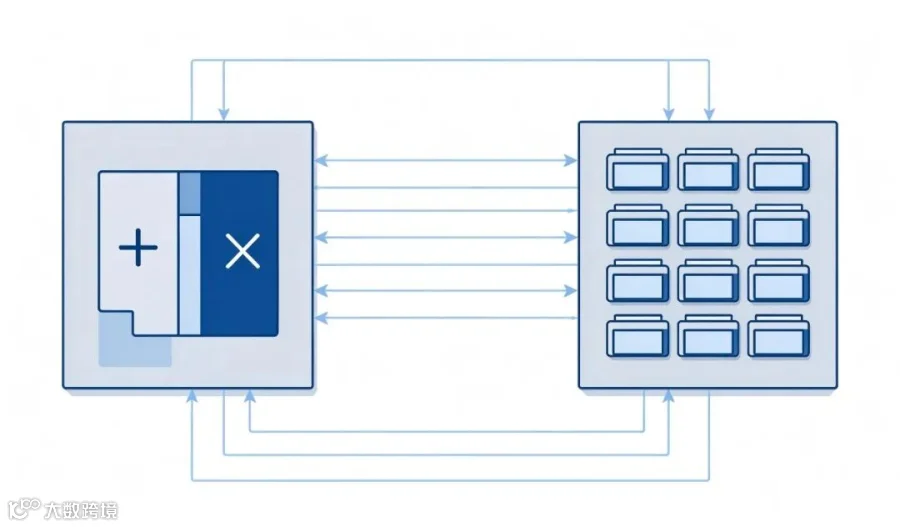
:CPU负责计算,内存负责存数据,两者之间靠一条总线连接。这就像一个厨师(运算器)坐在厨房中央,而所有食材(数据)都锁在隔壁仓库里——每做一道菜,都得亲自跑一趟取货。
图1:冯·诺依曼架构中计算单元与存储单元分离,数据需在两者间往返搬运(示意图)
问题在于,CPU的计算
速度
几十年里涨了成千上万倍,但内存(DRAM)的访问速度只涨了一点点。处理器算一个乘法只要零点几纳秒,可从内存取一个数要等上几百个时钟周期。这就是
"存储墙"(Memory Wall)
:CPU大部分
时间
不是在算,而是在
干等数据从内存搬过来
。
比速度差距更惊人的是能耗差距。芯片每做一次片上浮点运算,能耗大约是1个皮焦(10⁻¹²焦耳)量级;而从片外DRAM读一次数据,能耗可能高达数百个皮焦——
搬运一次数据的
能量
,是做一次计算的几十甚至上百倍
。在深度学习这类访存密集的负载中,系统六成到九成的电都花在搬数据上,真正用于计算的少得可怜。
工程师当然想了办法——多级缓存(L1/L2/L3 Cache)就是为了让常用数据离计算单元更近。但缓存容量再大也装不下大模型的全部权重,存储墙依然横在那里。
03 CPU的"包袱":通用性为什么反成了劣势
理解了工艺墙和存储墙,就能回答下一个问题:为什么CPU跑深度学习这么吃力?
CPU被称为"通用处理器",意味着它必须什么都能干——跑操作系统、处理文档、打游戏、响应鼠标键盘的中断。为了这种通用性,CPU付出了巨大的面积代价:芯片上塞满了复杂的控制单元、分支预测器、乱序执行逻辑和多级缓存。真正拿来做算术运算的
算术逻辑单元(ALU),往往只占芯片面积的10%—20%
。
而深度学习需要什么?它不需要复杂的if-else逻辑判断,不需要分支预测,不需要处理各种突发中断。它需要的是
海量、简单、重复的并行乘加运算(MAC)
——几百万次一模一样的矩阵乘法,彼此之间没有依赖。让CPU去跑大模型,就像让一辆底盘极其复杂的豪华客车去拉几万吨煤:豪华是豪华,但拉煤这件事,它既不专业也不高效。
具体来说,深度学习计算有四个鲜明特征:
计算密集且高度规则
——核心就是矩阵乘法和卷积,几百万次做几乎相同的乘加;
可以大规模并行
——成千上万的神经元彼此独立运算,天然适合同时开工;
精度要求低
——训练用16位浮点数足够,推理用8位甚至更低精度就行;
数据可复用
——同一个权重会被反复用于不同输入,存在片上少跑几趟内存就能省下大量能耗。
04 GPU:从图形显卡到AI主力
第一个站出来拆墙的是GPU。它原本是为游戏里的3D图形渲染设计的——屏幕上几百万个像素要同时着色,这本身就是一种大规模并行计算。没想到这和深度学习的计算需求惊人地契合。
打个比方:CPU像一位无所不能的"大学教授",擅长复杂的逻辑推理和顺序任务,但一次只能带几个学生;GPU则像几万个"小学生"组成的方阵,每个人只会做简单的加减乘除,但全员同时开工,总量惊人。深度学习需要的恰恰是后者——它不需要教授做推理,它需要几万人一起算乘法。
这种架构差异体现在硬件上:CPU把大部分面积给了控制逻辑和缓存,只有几个到几十个复杂大核心;GPU几乎砍掉了分支预测等复杂控制,把省下来的空间全塞满了简单计算核心。一块现代GPU内部拥有
数万个计算核心
,采用SIMT(单指令多线程)模式——一个控制单元同时向几万个核心发同一条指令,每个核心处理不同的数据。
但真正让GPU甩开CPU几个数量级的,是后来加入的
张量核心(Tensor Core)
。传统GPU核心一次时钟周期只能做一个标量乘加;张量核心则是专门的矩阵计算单元,一个周期就能直接完成一个4×4甚至16×16矩阵的乘加运算。在大模型推理时,本质就是输入向量和数千亿参数的权重矩阵不断相乘——张量核心就是为这件事生的。
GPU当然也逃不过工艺墙和存储墙。它的应对方式堪称"暴力拆招":
先进封装(Chiplet)
:不再追求一整块完美的大芯片,而是用台积电CoWoS等3D封装技术,把多颗3nm/4nm小芯片拼在一起,靠"以多取胜"绕过单芯片尺寸极限;
高带宽内存(HBM)
:放弃传统DDR5内存,在GPU旁边直接堆叠多层DRAM,带宽达到每秒数TB——相当于把CPU用的"吸管"换成了"消防水管";
NVLink互联
:让几千张GPU之间的通信比传统PCIe总线快几十倍,物理上分散的芯片在逻辑上融合成一个巨型计算节点。
05 破局:专用芯片与存算一体的未来
GPU是折中方案——它为图形而生,却意外适配了AI。于是更进一步的路线出现了:
领域专用架构(DSA, Domain-Spe
cif
ic Architecture)
,也就是TPU、NPU、MLU这类专门为深度学习打造的芯片。
它们把深度学习中占比99%以上的少数几类算子——卷积、矩阵乘、池化、激活——直接用专用硬件电路固化下来,用脉动阵列(Systolic Array)让数据在计算单元之间流动、尽可能在片上完成复用,从根本上减少数据搬运。衡量这类芯片效率的核心指标是
TOPS/W(每瓦每秒完成多少万亿次操作)
,专用DSA芯片在这个指标上往往
比通
用CPU高出一到两个数量级。
但即使是DSA芯片,依然在与冯·诺依曼瓶颈搏斗。数据搬运的能耗是结构性问题——只要计算和存储分开,总线就永远在那里。最彻底的方向是
存算一体(Processing-in-Memory)
:不再区分计算模块和存储模块,直接在存储器单元内部完成神经网络的乘加运算,让数据根本不用搬。这被视为后冯·诺依曼时代最有潜力的架构方向之一。
06 写在最后
回到开头的问题:为什么我们需要专门的AI芯片?
答案不是CPU变差了,而是三条路同时走到了头:
工艺上
,量子隧穿和漏电流让登纳德缩放失效,主频被锁死,暗硅让晶体管数量不再等于性能;
架构上
,冯·诺依曼的计算存储分离让大部分能耗花在搬数据上;
需求上
,AI计算"规则、并行、低精度"的特点,和CPU"通用、低延迟、强控制"的设计哲学完全错配。
摩尔定律放缓之后,算力增长不再靠工艺的自然进步,而是靠架构创新——从通用CPU到GPU,再到DSA专用芯片和存算一体;从单芯片到Chiplet先进封装,从DDR到HBM。这些方向本质上都在回答同一个问题:
如何让数据少跑路,让计算多干活。
理解了这一点,你再看今天层出不穷的NPU、存算一体、类脑芯片,就不会觉得它们是玄学概念了。它们不是一时风潮,而是工程师们在物理定律画下的边界内,硬生生凿出来的新路。
【声明】内容源于网络
0
0
AI和HPC
聚焦 AI HPC 前沿,为科研人员、工程师、技术爱好者深度剖析领域核心知识与实战技术。从算法优化到硬件架构,精准推送一手资讯,助您紧跟行业脉搏,解锁高效创新密码。
内容
8
粉丝
0
关注
在线咨询
AI和HPC
聚焦 AI HPC 前沿,为科研人员、工程师、技术爱好者深度剖析领域核心知识与实战技术。从算法优化到硬件架构,精准推送一手资讯,助您紧跟行业脉搏,解锁高效创新密码。
总阅读
92
粉丝
0
内容
8


 AI和HPC