

编者摘要:该论文对比轻量分类器 Jev 与 3 款闪存级 LLM(Luna、Gemini、DeepSeek)作为评分细则自动评判器,基于 9 个数据集面板共 5003 组样本开展实验。Jev不生成自由文本,输出候选答案概率与置信度,一次 API 请求处理单元全部评判标准。
在二元评判任务,Jev 表现优秀,精度接近甚至优于 LLM;在多级打分任务,多数场景和 LLM 精度差距不显著,但弱于最优 LLM(Gemini)。开销上,LLM 成本为 Jev 的 29‑325 倍,耗时为 30‑220 倍,Jev 具备巨大成本速度优势。
所有评判器存在共性问题:评判器之间一致性高于评判器与人工标签的一致性,普遍打分低于人工标注,源于评判文本缺失标注惯例、人群参照、语料相对标准等隐性知识。
虽然 Jev 置信度可识别自身多数错误,但Jev 与 LLM 存在高度相关错误:Jev 置信度最高的错误,LLM 有 96% 概率重复该错误。因此 “Jev 优先,不确定样本交给 LLM” 的级联方案仅能大幅降本,精度提升最高仅 1.5‑2.0 个点;多模型陪审团也无法超越最优单一评判器。
研究给出工程实践建议:二元任务优先选 Jev;多级任务按需选用 Jev‑Score;级联不要期待精度暴涨,重点用于降本;报告评测指标必须同时输出偏移量、模型间一致性。

10 个关键问题问与答
- Q:Jev 是什么,和普通 LLM 评判器最大区别?
A:Jev 是类型化分类器,不生成自由文本,直接输出固定候选答案概率分布与置信度;一次请求处理同一个单元全部评判标准,成本速度远优于逐标准调用 LLM。 - Q:Jev 在哪类任务表现最好?
A:二元二分类评判任务(达标 / 不达标),精度接近甚至超过 LLM,同时成本极低。 - Q:多级打分任务 Jev 表现如何?
A:多数对比与 LLM 无统计学显著差异,但整体弱于最优 LLM Gemini;Jev‑Score 原语在部分多级数据集表现优于 Jev‑Choice。 - Q:为什么所有评判器打分普遍低于人工标注?
A:评判标准文本缺少隐性标注惯例,包括人群参照标准、语料相对打分标准、标注员特有习惯;也可能来自模型预训练共享先验。 - Q:什么是 “高度相关错误”?
A:Jev 预测出错,尤其是高置信度错误时,LLM 评判器很大概率输出一模一样错误答案;Jev 最高置信错误样本中 LLM 重复错误占比达 96%。 - Q:Jev 置信度是否可靠?
A:大部分数据集可用,但部分评判标准置信度失效,例如 ELLIPSE 语法、LFQA 事实性,需要按单条评判标准校验。 - Q:Jev‑优先级联系统预期收益是什么?
A:主要收益降低推理成本;即使理想条件,精度提升上限仅 1.5‑2.0 个点,不要指望大幅涨点。 - Q:多模型陪审团集成能不能突破单模型上限?
A:不能。多个 LLM 中位数陪审团无法超过面板内最优单个评判器,因为模型错误大量重合。 - Q:做 LLM‑as‑judge 评测,不能只看准确率 / QWK,还要看什么?
A:必须报告分数偏移 offset,以及评判器互相之间一致性;高相关错误需要统计重复错误率与独立基线对比。 - Q:工程落地有什么实操建议?
A:二元任务优先 Jev;多级任务尝试 Jev‑Score;级联以降本为目标;多级评判开启 NA 弃权选项;针对每条评判标准校验置信度有效性。 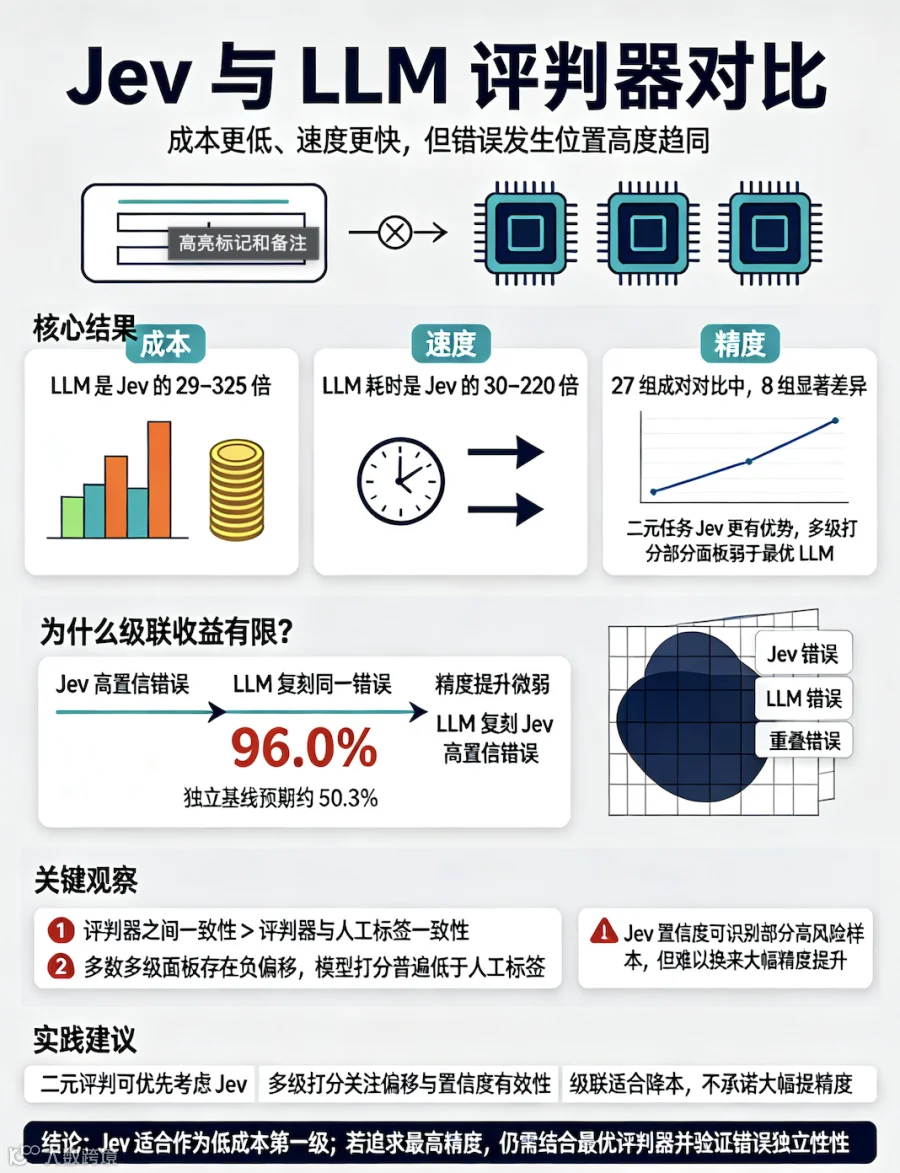
作者:德利普・拉奥 *(宾夕法尼亚大学)、克里斯・卡利森‑伯奇(宾夕法尼亚大学) * 通讯作者
摘要
本文研究 Jev(一种类型化分类器,不生成文本,输出候选答案的概率分布)是否可以替代基于大语言模型(LLM)的评分细则评判器。我们使用 9 个数据集面板(源自 7 个基准数据集),将它与 3 款轻量级 LLM 评判器开展对比;给所有评判器提供完全相同的评判标准文本。在 27 组成对对比实验中,Jev 仅有 8 组与 LLM 评判器存在显著精度差异;Jev 优势主要体现在二元二分类评判任务,仅在多级打分任务上表现不及对手,其余绝大多数对比结果均无明确结论。
汇总 9 个面板的实验结果:按照每条评判标准调用一次模型的方式,LLM 评判器的成本是 Jev 的29‑325 倍,运行耗时是 Jev 的30‑220 倍。在多级打分任务中,4 款评判器互相之间的一致性,均高于它们和人工标注标签的一致性;而且评判器给出的打分等级普遍低于人工标注结果。其中一种观测层面的解释是:人工标注员遵循了我们评判标准文本中没有写明的量表使用惯例。
Jev 输出的置信度可以在绝大多数数据集面板上,区分出自身预测错误的样本。照此逻辑,廉价分类器天然适合作为级联系统的第一级:置信度高直接输出结果,置信度低再交由 LLM 评判器处理。但评判器之间错误高度相关,抵消了这套方案的收益。LLM 评判器几乎会复刻 Jev 那些置信度极高的错误。因此,基于已有预测结果复现级联方案,虽然可以降低成本,但相比最优单一模型,采用交叉验证阈值时精度最多只提升 1.5 个点;即便使用理想先知阈值,提升幅度最高也仅为 2.0 个点。
1 引言
基于评分细则的自动评估,会把对模型输出的整体评判,拆解为多条独立评判标准下的判定结果。例如:一道化学作答是否陈述了某条必需的关系;一篇作文在语法维度属于哪一个 5 级评分等级。我们把待评估的一份样本称为单元;(单元,评判标准)这一组合称为样本对。
LLM 评判器会为 HealthBench 等基准数据集生成这类判定结果,同时也被用于强化学习的奖励信号;这类评判器的效果会对照人工标注做验证。AutoRubric 这类逐标准打分工具,会针对每一组(单元,评判标准)调用一次 LLM,因此评估总开销 = 样本单元数量 × 评判标准数量。
本文提到的类型化分类器,指针对结构化输入输出一组固定候选答案概率分布、不生成自由文本的模型。TypeSafe 公司推出的 Jev 就是这类模型。它按输入 token 计费,一次请求可以处理同一个单元下全部评判标准,因此单元文本只会计费一次。同时 Jev 会为每个结果返回概率 / 置信度,它既可以直接替代 LLM 评判器,也可以用来判断哪些样本对需要交给 LLM 二次处理。
本文研究三个核心问题:
-
Jev 能否充当 LLM 评分细则评判器的替代品; -
当没有任何自动评判器可以复现人工标注时,这种差距是某一个评判器独有的,还是所有评判器共同存在的问题; -
造成这种差距的根源是什么。
我们选取 9 个面板共计 5003 组样本对开展实验,对比 Jev 与 3 款厂商推出的轻量级 LLM:GPT‑5.6 Luna、Gemini 3.8 Flash、DeepSeek V4.1 Flash(下文简称 Luna、Gemini、DeepSeek)。二元评判面板仅包含是 / 否二分类标准;其余 7 个多级打分面板,大部分评判标准使用有序等级打分。所有评判器读取完全相同的评判标准文本,这些评判细则版本在本研究开展前就已经写好,没有提供示例、没有改写、没有调优。
我们先基于二元面板形成对 Jev 的预期,再在多级打分面板上检验假设;评判器与人工标签存在差距的解释,是事后观测分析得到。
在精度层面:27 组 Jev 与 LLM 的面板成对对比中,只有 8 组的 95% 置信区间不包含零点。Jev 的优势大多出现在二元评判面板;劣势仅出现在多级打分面板,主要输给表现最好的 Gemini。其余大部分对比,统计效力不足,无法判定模型等价。
汇总全部 9 个面板:Gemini 的开销是 Jev 的 325 倍,运行耗时为 Jev 的 33 倍。
在所有多级打分面板上:4 个评判器彼此之间一致性高于与人工标签的一致性;7 个多级面板中有 6 个,评判器输出平均等级低于人工标签,ELLIPSE 学习者作文数据集上差距接近整整一个等级。评判器与人工标注的差距集中在少数几条评判标准;这种差距更多来源于评判器在量表上分配等级,而不是样本之间的排序。事后对每条评判标准整体平移一个固定等级,就可以消除绝大部分精度差距。
一种解释:人工标签编码了评判标准文本中没有写明的行业惯例。例如标注员会参照自己训练时接触到的人群来打分。同一个评判标准文本被用于两套对话语料库时,在其中一套数据集评判器打分普遍远低于标签,另一套数据集打分则与标签接近。
也有可能是训练数据带来的先验、或是评判器普遍不愿给出最高等级,造成这一现象。ELLIPSE 数据集评判标准中最高等级描述为 “接近母语水平”,仅这句话本身就可能压低模型打分。人工标注员阅读的是基准数据集原始标注指引,而不是我们修改后的评判细则版本。本研究没有做对照消融实验修改文本,因此以上都只是观测层面的推论。
Jev 的置信度指标,在绝大多数多级打分面板上,可以区分预测错误的样本。这天然支持构建级联系统:Jev 置信度高直接输出,不确定样本交由 LLM。但评判器之间错误高度相关,削弱这套方案收益。Jev 置信度最高的错误样本中,LLM 评判器有 96.0% 会输出和 Jev 完全一样的错误答案;而独立出错的基线预期只有约 50%。
我们基于已有全部预测结果,事后复现这套级联方案:虽然可以降低开销,但对比面板内最优单一评判器,采用交叉验证阈值时,精度最多提升 1.5 个点;即便理想先知阈值,最大提升也只有 2.0 个点。
本研究公开所有评判器输出结果;表 5 总结实验得到的各项建议,每条建议标注证据等级。
2 相关工作
郑等人 (2023) 发现 LLM‑as‑judge 存在位置偏好、冗长偏好、自我美化偏差;GPT‑4 和人类偏好的一致程度,大致等同于人类标注员之间的一致性。Chiang & Lee (2023) 发现,如果把人类标注员完整提示给到 LLM,LLM 打分可以达到专家水平。
JUDGEBENCH 数据集研究表明,LLM 评判的可靠性,取决于评估的属性以及标注专家水平。高百分比一致性指标,会掩盖评判器和人工标签之间巨大的分数差距。人类标签本身的不确定性,会造成机器评测指标看起来和第二位人类标注员水平相当。因此本研究除一致性外,还报告分数偏移量指标。同时标注员之间的分歧既可以是信号,也可以是噪声,我们会区分完全一致样本对和存在分歧的样本对分别统计。
Prometheus 系列模型专门训练开放权重模型,根据用户提供评分细则做文本打分。CheckEval 把李克特量表打分改造为二元清单式问题,提升一致性。HealthBench 迭代评判标准,直到评判意图清晰。LLM‑Rubric 将每条评分问题建模为选项概率分布,训练小型网络映射概率到人工标签,可以吸收本研究观测到的系统性偏移;因此本研究不在任何评判器之上叠加这类校正网络。
对话领域已有很多无参考评测指标,GEval、LLM‑Eval 使用 LLM 做评估。ELLIPSE 数据集上监督模型在 6 个分析维度加权卡帕 QWK 可以达到 0.854;零样本 GPT‑4 整体得分加权卡帕仅 0.307。
基于 LLM 的作文打分普遍比人类给分偏低,会惩罚人类会忽略的微小错误;本研究中 Jev 在 ELLIPSE 数据集上同样出现打分偏低现象。提供标定示例可以改善 LLM 对二语学习者短文打分效果。和人工标签的相关系数,无法检测恒定的分数偏移,因此本文同时报告精确匹配准确率与偏移量,在统一实验协议下对比 4 个评判器。
已有工作发现,不同厂商的大模型会产生高度相关的错误;模型能力越强,错误相似度越高。混合多个不同家族小模型组成陪审团,可以降低单一大模型的偏差。
闭合候选集之上输出的概率,可以表征预测正确与否;选择性预测模型利用置信度选择放弃输出;级联系统利用置信度实现从廉价模型向昂贵模型的升级。Trust or Escalate 工作设计带人类一致性保证的级联评判器;本文基于已经记录好的全部预测结果做事后复现级联,分别使用理想先知阈值与交叉拟合阈值。
3 评判器、数据集面板与实验协议
所有评判器运行在开源 AutoRubric 评判框架下。9 个面板中,RiceChem、HealthBench 是二元二分类面板。多级评判标准的选项是有序等级;7 个多级面板里,有 4 个同时混杂二元评判标准。
表 1:9 个数据集面板信息
-
面板 待评估单元(词数中位数) 评判标准(词数) 量表类型 人工标签来源 标注员参考 单元数 样本对总数 RiceChem 化学长作答 27(3‑21) 二元 助教标注 无 121 819 HealthBench 聊天机器人输出 34(7‑481) 二元 2‑5 名医师多数投票 无 200 406 ELLIPSE 学习者作文 (392) 6(27‑36) 5 等级 2 名受过训练标注员均值 有 258 1548 FED‑Turn 对话轮次回复 (9) 7+1 条二元 (4‑13) 3 等级 最多 5 名众包标注员均值 有 75 600 FED‑Dialogue 完整对话 (123) 9+1 条二元 (6‑13) 3 等级 最多 5 名众包标注员均值 有 25 250 HelpSteer2 助手回复 (215) 4(15‑32) 5 等级 官方发布单标签 无 90 360 LFQA ELI5 问答回答 (100) 3(14‑33) 3‑4 等级 3 名众包标注员均值 有 120 360 USR‑TC Topical‑Chat 对话回复 (19.5) 3+2 条二元 (11‑43) 3 等级 3 名研究者均值 有 72 360 USR‑PC PersonaChat 对话回复 (12) 3+2 条二元 (11‑43) 3 等级 3 名研究者均值 有 60 300 注释:单元指被评判的样本;评判标准列给出评判标准总数量以及评判句子词数范围。Rater ref. 代表是否可以计算标注员参考指标。USR‑TC、USR‑PC 分别代表 USR 数据集的 Topical‑Chat 与 PersonaChat 子集。TA 代表助教。 数据集来源:RiceChem、HealthBench、ELLIPSE、FED、HelpSteer2、LFQA、USR。
3.1 Jev
厂商将 Jev 称为 “系统一号” 模型,定价为每百万输入 token 0.042 美元,输出 token 免费。实验调用别名 jev‑latest,稳定性校验日志记录版本 jev‑1.13.0。
一次请求除了每个评判标准对应的问题,还会携带结构化记录(state 字段),包含输入上下文与待评判样本。Jev 不会读取框架的系统提示词;它会严格按照量表顺序读取全部选项,看不到框架附加给每个等级的 0‑1 数值。
Jev 提供三种原语(primitive),各自有解码规则:
不同任务下的调用方式(framing)
多级面板内部嵌套的二元样本对统一使用 Noul 原语。
Jev Choice 与 3 个 LLM 评判器作为主对比匹配评判器;Jev Score 作为备选调用方式。
置信度:Choice、Score 接口直接返回 confidence 字段;Noul 置信度定义为\(2|P(yes)-0.5|\)。Choice 返回置信度近似最大概率做缩放,均匀分布置信度输出 0;厂商没有公开精确公式,本文只用置信度做样本排序。
3.2 LLM 评判器
每个 LLM 评判器在框架内使用默认系统提示词;每组样本对独立调用一次 API。DeepSeek 通过 OpenRouter 接口调用。每次调用会用固定种子打乱选项顺序消除位置偏差。 温度参数 temperature=0,Luna 接口强制只能使用 temperature=1.0。推理强度保持厂商默认;三个模型都会输出推理 token,Luna 输出推理 token 数量远少于另外两者。
多选择任务系统提示词要求模型:留意否定、限定修饰词;不确定时不要直接选择中间等级;样本内部自相矛盾时,选择质量更低的等级。
3.3 数据集面板
FED 拆分为 FED‑Turn、FED‑Dialogue;USR 拆分为 USR‑TC、USR‑PC。LFQA 问题与人工答案源自 ELI5。ELLIPSE 把评判维度称为 traits;HelpSteer2 称为 attributes。
多级面板是原数据集 10% 或 20% 采样子集,采样种子在调用任何评判器之前就已经固定。RiceChem 是每个问题响应 10% 测试划分;HealthBench 包含 200 条生成结果、406 组样本对,使用经过医师验证的共识评判标准。
评判标准句子、等级描述来自本研究之前另一份未发表研究写的评判细则版本。ELLIPSE 直接沿用原语料评分细则的等级描述,评判句子中将最高等级标记为 “native‑like facility(接近母语水平)”——原始人工标注员读取的是基准数据集自带标注说明,而不是我们改写后的评判文本。所有评判器看不到标签、整体分数、采样分层信息。本研究的观测性分析(第五节)是全部评判结果跑完之后才开展。
3.4 标签与参考基准
多级样本的人工标签:多名标注员打分取均值,四舍五入到最近等级,0.5 向上舍入。ELLIPSE 数据集 46.8% 标签属于对半取整的情况。二元样本标签为标注多数投票,RiceChem 直接使用助教标注。
标注员参考指标 (rater reference):将某一位标注员,拿其余标注员打分的舍入均值作为标准答案做评测。6 个有多份打分的多级面板可以计算该指标。注意该指标目标仅相当于少一名标注员,不能作为评判器性能绝对上限。
两个不读取样本内容的基线模型:HelpSteer2 常量预测基线,直接输出每条属性出现频次最高等级,精确准确率 60.0%;LFQA 来源基线,仅区分回答来自 ChatGPT 还是 Reddit 用户,精确准确率 68.1%,加权卡帕 0.28。
3.5 指标与统计方法
多级评判属于有序分类任务:
二元评判:报告判定准确率、科恩卡帕 κ、MET 率偏移量(预测达标率减去标签达标率,百分点)。
由于不同等级数量会影响随机猜测的基线精确准确率,跨面板对比依靠 QWK、偏移量、gap,而不直接比较精确准确率数值。
成对对比统计方法:只统计两个评判器都输出结果的样本对。成对精度差 = (仅第二个评判器预测正确样本数 − 仅第一个评判器预测正确样本数) / 总样本。由于同一个单元的多组样本对存在相关性,我们对单元做有放回 bootstrap 重采样,重采样 10000 次,得到差异的百分位置信区间。
5 个百分点等价边界是在全部评判结果拿到之后确定。27 组 Jev Choice 对比 LLM 的多重比较,使用 bootstrap p‑value 做 Holm 校正。
弃权、调用失败不计入分母;DeepSeek 在二元面板 3 次调用失败,框架直接记为 UNMET。本论文中等级平移、级联系统全部为事后基于已有预测做的反事实分析,没有重新调用模型,文中会明确标注。
4 Jev 的准确率、开销与速度
本章评估 Jev 作为 LLM 评判器替代品的表现,权衡精度、成本与耗时。开销节约在所有面板都非常可观;精度差异取决于评判标准类型、替换哪一款 LLM。我们逐个面板、逐个 LLM 开展成对对比,之后讨论价格、墙钟耗时,最后讨论调用方式与弃权选项带来的影响。
4.1 成对对比下的准确率
RiceChem 二元数据集:Jev Choice 取得全部匹配评判器中最高精度 81.0%;LLM 为 76.1‑79.2%。HealthBench 二元数据集 Jev Choice 排第二,次于 Gemini。
21 组多级面板对比:16 组无法区分 Jev Choice 与 LLM;最大差距是 Gemini 在 ELLIPSE 数据集领先 16.4 点。Gemini 同时在 FED‑Dialogue、HelpSteer2 领先;Luna 在 USR‑PC 领先,在 HelpSteer2 落后 Jev Choice。DeepSeek 没有任何一组对比判定存在显著差异。6 组达成等价,10 组统计区间过宽,既不能判定等价,也不能判定存在差异。
Holm 多重校正后保留 4 组显著差异:Gemini 在 ELLIPSE、FED‑Dialogue 领先;Jev Choice 在 HelpSteer2 胜过 Luna、在 RiceChem 胜过 Gemini。
Jev Choice 在多级面板上从来不是精度最高的匹配评判器;Gemini 几乎在所有面板是第一或者并列第一。ELLIPSE、FED‑Dialogue、USR‑PC 上所有评判器都弱于标注员参考指标。ELLIPSE 数据集上最强 Gemini 精确准确率仅 29.8%,而标注员参考达到 51.4%。HelpSteer2 数据集上,简单常量基线(60.0%)比绝大多数自动评判器更准。LFQA 数据集所有评判器精确准确率和来源基线没有显著差异,但全部评判器平均 QWK(0.43‑0.51)高于基线 0.28。
4.2 Jev 相比 LLM 更加廉价、速度更快
全部 9 个面板汇总开销:Jev Choice 总花费仅 0.063 美元。Luna 开销是它 29 倍,DeepSeek 66 倍,Gemini 高达 325 倍。单面板开销比值区间 18 倍(Luna‑HealthBench)~770 倍(Gemini‑FED‑Dialogue)。
全部 9 个面板墙钟运行时间:Jev Choice 仅 29 秒;Luna859 秒,Gemini950 秒,DeepSeek6298 秒。LLM 耗时达到 Jev 的 30‑220 倍。
注意:Jev 一次请求处理同一个单元全部评判标准,开销随每个单元评判标准数量上升;LLM 则每条评判标准独立一次调用,开销线性随评判标准数量增长。
本实验没有测试 “单条 LLM 请求处理一个单元全部评判标准” 的方案;该方案可以降低 LLM 开销,但对精度的影响未知。
4.3 调用方式与弃权
二元评判任务中 Jev Noul、Jev Choice 输出高度一致,RiceChem 数据集 κ=0.945。Wrapper 包装定义 MET/UNMET,在 RiceChem 相比 bare Noul 提升 10.7 个百分点,HealthBench 仅提升 1.0 点。
多级面板中,Jev Score 在 4 个面板显著优于 Jev Choice;在 FED‑Turn 差距最大,相差 10.5 个百分点。FED‑Turn 数据集 Jev Score 的 within‑one 准确率更高;它大量使用中间等级 “Somewhat”,而 Jev Choice 极少输出中间等级。
Jev Choice 提供 NA 弃权选项:3414 条多级有序样本对内仅弃权 28 次;其中 17 次集中在 FED‑Dialogue 的 error_recovery 评判标准,该标准下很多人工标注员同样选择 N/A 不适用。Jev 输出 NA 的概率,与标注员给出 N/A 的数量斯皮尔曼相关系数 ρ=0.62。
5 评判器共同偏离人工标签的现象
第四节对比评判器之间的性能差异;本章对比 4 个匹配评判器与多级面板人工标签。多级打分面板下,评判器之间的一致性 > 评判器与人工标签一致性;所有评判器系统性给分偏低。该现象的来源可能来自评分细则文本缺失标注惯例、训练集共享先验等,下文为观测性证据。
5.1 评判器互相之间一致性高于评判器‑标签一致性
表 2 结果显示,全部 7 个多级面板,评判器两两之间平均 QWK,大于评判器和人工标签之间的 QWK。ELLIPSE 数据集 64.0% 样本对上,4 个评判器全部预测错误;如果幻想一个 “每次选对至少一个评判器答案” 的虚拟集成模型,也只能拿到剩余 36% 样本,依旧低于标注员参考。
仅靠标签噪声,不足以完全解释该现象;系统性统一偏移,会压低评判器‑标签一致性,却不降低评判器互相之间一致性。
5.2 精度差距集中在偏移量为负的评判标准
针对有标注员参考指标的 31 条评判标准:4 个评判器平均偏移量,与平均精度差距斯皮尔曼 ρ=0.92。绝大多数精度严重落后于人类的评判标准,都伴随显著负偏移(评判器打分低于标签);偏移量接近 0 的评判标准,精度差距都很小。 35 条多级评判标准中,25 条所有评判器偏移全部为负数,仅有 2 条全部为正数。
5.3 对等级做常量平移,消除大部分精度差距
对某评判标准,给评判器预测结果整体平移固定整数等级(留一法选择最优平移量)。平移之后,平均精度差距与偏移量之间相关性消失。大部分评判标准经过平移后,和标注员参考差距缩小至 8.4 点以内。仍然有少数评判标准即便双方都做最优平移,依然存在巨大差距,例如 FED‑Dialogue informative、LFQA factuality。
ELLIPSE 数据集偏移现象最为突出:Jev Choice 偏移‑1.25 等级,Gemini‑0.77。Jev Choice86.1% 预测结果低于标签,仅 0.5% 高于标签。评判器极少使用量表最高两档;人工标签 36.3% 落在 4‑5 级,所有评判器输出 4‑5 级占比最高不超过 4.2%。
做 + 1 等级整体平移之后:Jev Choice 精确准确率从 13.4% 上升到 50.4%,接近标注员参考。但平移不能修复样本内部等级压缩问题:评判器输出等级分布范围相比标签更窄。
同时,评判器对作文样本的排序能力,和人类标注依旧接近:单元维度 6 个评判维度平均分,与整体作文得分斯皮尔曼 ρ=0.62‑0.72。
5.4 观测到的候选惯例(Conventions)
表 3 列举多类标签编码、但评判标准文本没有写明的惯例:人群参照标准、语料库相对标准、标注习惯。
证据 1:固定评判文本,更换语料库USR‑TC、USR‑PC 两套数据集,
engaging评判标准文本完全一致。PersonaChat 语料库人工标注大量使用最高等级;评判器在该语料库偏移非常大;Topical‑Chat 数据集偏移很小。给全部预测 + 1 等级,PersonaChat 数据集所有评判器精确准确率暴涨;但 Topical‑Chat 数据集效果变差。说明标注打分是相对于本语料库回复分布给出,而不是只看评判标准字面描述。证据 2:同一套评判集,不同评判维度表现分化(ELLIPSE)
cohesion(衔接)等级描述写的是可观测语言手段,所有评判器该维度表现最好;grammar(语法)等级只使用模糊量词:throughout/many/some/minimal/few or no,所有评判器该维度表现最差。证据 3:二元评判标准错误方向随标准变化,不是模型固定偏向USR‑TC 两条内嵌二元标准:
understandable评判器过度判定达标;uses_knowledge评判器过度判定不达标。同一批回复,模型错误方向完全取决于评判标准本身,说明 Jev 在二元面板倾向过度给 MET,多级面板普遍负偏移,不是模型本身固定的全局偏向。候选解释一:人群参照标准。ELLIPSE 原始标注员是针对 8‑12 年级英语学习者训练;评判标准写 “level5 = native‑like facility”。自动评判器只读到字面描述,没有学习者人群的先验认知,因此打分普遍压低。 候选解释二:标注习惯。LFQA factuality 最高等级描述为 “完全准确,可以作为可信信息源”;人工标注经常给到最高等级,但 LLM/Jev 会揪出微小瑕疵拒绝最高等级。 候选解释三:共享训练先验。模型预训练数据带来共同先验,造成统一行为;本研究无法区分以上哪一种是真正原因。
5.5 标签噪声、框架提示词、共享先验
单纯标签噪声不能解释 ELLIPSE 几乎全部错误都是预测等级低于标签;LFQA factuality 上,模型在标注员完全一致的样本对上错误率反而更高。
虽然第五节第一条排除框架系统提示词作为统一偏移唯一来源(Jev 完全看不到系统提示词,偏移依然很大),但 LLM 的系统提示依然会加剧偏移。 “不愿意输出最高等级” 的共享倾向可以解释 USR‑engaging 现象。共享训练数据带来先验也会造成高度相关错误。想要区分这些假说,需要给模型提供标注示例,或者使用没有经过相关训练的人类受试者做对照。
6 高度相关的错误,抵消级联方案的收益
级联系统思路:廉价评判器先处理全部样本;置信度低于阈值 τ,交由昂贵的后备 LLM 评判;置信度高直接保留廉价模型输出。 前提假设:廉价模型置信度可以有效识别自身错误。但如果两个模型错误高度相关,这套方案收益会被严重削弱。
在大部分多级面板,Jev 置信度越高,出错概率越低;但 Jev 置信度最高的错误样本,LLM 评判器绝大多数会重复同样错误。事后复现实测:级联可以降低开销,但对比面板最优单一评判器,精度提升非常有限;多模型陪审团也无法超过最优单个评判器。
6.1 Jev 置信度可以排序自身大部分错误
除 ELLIPSE 以外,其余 6 个多级面板,置信度对预测正确性 AUROC 处于 0.57‑0.70 区间。ELLIPSE 数据集 AUROC 仅 0.49;不同置信分箱错误率几乎不变。
置信度在部分子评判标准上失效,例如 LFQA factuality(AUROC=0.41),USR‑PC engaging(AUROC=0.52);这些评判标准错误几乎全部朝同一个方向偏移。
6.2 LLM 评判器会复刻 Jev 置信度最高的错误
重复错误(repeated error):Jev 预测错误时,LLM 输出和 Jev 一模一样的错误答案。 对比基线:对同一条评判标准 + 同标签,统计 LLM 输出该错误答案的频率,模拟模型互相独立出错的预期。
在 Jev 置信度最高分箱,LLM 重复错误比例达到 80.5%‑92.8%;独立基线预期仅 33.6%‑63.7%。 专门采样每个多级面板 Jev 置信度最高 12 条错误样本(合计 84 条):LLM252 次判定中,242 次复刻 Jev 错误(占比 96.0%);独立基线预期仅 50.3%。
观察样本:Jev 置信度最高错误,很多落在标注员存在分歧(split)的样本对上,但也存在大量标注员完全一致(unanimous)的样本对。说明重复错误不完全来自标签本身的模糊性。
6.3 级联可以降本,但精度增益微弱
事后回放级联实验,两种阈值设置:
交叉拟合条件下,所有面板级联对比该面板最优单一评判器,平均提升最多 1.5 点(HealthBench);6 个面板级联结果反而比最优单模型更差。即便使用 oracle 先知阈值,最大提升仅 2.0 点。
公式推导级联与后备评判器精度关系: \(a_{cascade }-a_{fallback }=s_{kept }\left(a_{Jev }^{kept }-a_{fallback }^{kept }\right)\) \(s_{kept}\):Jev 保留不交给后备模型的样本占比。级联相比后备 LLM,提升只能来自:Jev 判断正确、后备 LLM 判断错误的那部分保留样本。但二者错误高度相关,这样的样本数量非常稀少。
开销收益:交叉拟合条件,6 个面板级联开销仅为最优 LLM 评判器开销的 16%‑48%,代价精度损失 0.2‑1.8 点。RiceChem 数据集 Jev 本身就强于 LLM,级联开销仅为 LLM 的 6.6%,同时提升 1.2 点。ELLIPSE、FED‑Dialogue 数据集几乎要把全部样本交给 LLM 后备,级联失去意义。
6.4 陪审团集成也无法超过最优单一评判器
取三个 LLM 输出的中位数作为陪审团输出,对比面板最优匹配评判器。中位数陪审团在全部 9 个面板上,都无法超过最优单一评判器。在 Jev 置信度最高 84 个错误样本上,三 LLM 陪审团 82 次输出和 Jev 一样的错误答案。增加 Jev 作为第四名陪审员,依旧没有显著收益。
7 讨论
7.1 评判器验证与模型组合
同一批样本对下做成对对比,是判断一个评判器能否替代另一个评判器的正确方法。评判器距离人类标签的差距,很大一部分来自评判文本之外,标注员所掌握的额外惯例。 当评判标准描述的是样本中可直接观测现象时,所有评判器和标签一致性最好;当打分依赖人群参照、语料库相对标准、标注隐性习惯,所有评判器都会共同出现系统性偏差,即使最强 LLM 也不能幸免。
Jev 置信度在大部分面板可以识别高风险样本,交给 LLM 后备。但高度相关错误带来双刃剑:
本研究建议:评估多模型集成 / 级联方案时,需要报告重复错误占比,并和独立错误基线做对比。
7.2 实践建议
-
优点:Jev 高置信结果可以保留,几乎不会损失精度,显著节约开销; -
缺点:二者错误高度重合,很难获得显著精度提升。 -
Separated(存在显著差异):95% 置信区间不包含 0; -
Parity(等价):90% 置信区间落在 ±5 个百分点以内,等价双单侧检验 α=0.05; -
Inconclusive(无结论):既不能判定存在差异,也不能判定等价。 - Exact accuracy(精确准确率)
预测等级与标签完全相等占比; - within‑one accuracy(±1 级准确率)
预测与标签相差不超过 1 个等级就算正确; - Mean QWK
每条评判标准的二次加权卡帕的无权重均值; - Offset(偏移量)
预测等级减去标签等级的均值; - Gap
评判器精确准确率减去标注员参考指标,负数代表弱于人类标注员。 - Unanimous(完全一致样本对)
所有标注员打分完全相同; - split(分歧样本对)
标注员打分存在差异。 -
二元面板: Jev Choice候选集合为 MET(达标)、UNMET(不达标)、CANNOT_ASSESS(无法评估);Jev Noul使用 Noul 原语。wrapper 包装会在评判标准前增加固定指令句子,定义 MET、UNMET 含义。Bare Noul 不使用该包装。 -
多级打分面板: Jev Choice使用和 LLM 完全相同的选项文本作为标签,末尾增加 NA(无法评估 / 不适用);Jev Score读取等级描述,不支持 NA 弃权输出。 - oracle threshold 先知阈值
在全部样本上挑选最优阈值,结果属于乐观上界; - cross‑fitted cross‑validation 交叉拟合阈值
在一半单元调参,另一半做测试;重复 50 次取平均,更贴近现实部署。 - Noul
输出答案为 yes 的概率,阈值取 0.5; - Choice
输出给定候选标签的概率分布,取概率最大作为输出; - Score
接收有序等级描述,输出期望等级数值,四舍五入到最近等级;遇到 0.5 就近舍入偶数。 -
建议 证据 证据状态 二元二分类标准,考虑使用 Jev 替代轻量级 LLM 评判器 RiceChem 精度第一,HealthBench 第二;LLM 开销 18‑326 倍于 Jev 实测(2 个面板) 多级打分任务:部分对比 Jev Choice 与 LLM 差距在 5 点以内;部分面板 Jev Choice 弱于最优 LLM 21 组多级对比 6 组等价、10 组无结论;Gemini 在 3 个面板领先,Luna1 个,Jev Choice 胜过 Luna1 个 实测 不需要弃权输出的多级打分场景,优先考虑 Jev Score;做匹配对比报告 Jev Choice 结果 4 个面板 Jev Score 显著优于 Jev Choice,没有显著劣于 Jev Choice 的面板;Jev Score 无法弃权 实测 二元任务务必使用 wrapper 包装,提供 MET/UNMET 定义 Bare Noul 相比包装版本精度下降 10.7/1.0 点 实测 多级评判标准全部开启 NA 无法评估选项 3414 有序样本对 28 次弃权;NA 概率与人工 N/A 标注 ρ=0.62 观测得到 按单条评判标准检查置信度有效性,再做级联转交 ELLIPSE 置信度失效;LFQA factuality AUROC 仅 0.41 观测得到 Jev 前置级联可以降低开销,但不要期待大幅精度提升 交叉拟合最大提升 + 1.5 点;6 个面板开销降至 LLM 的 16‑48%,最多损失 1.8 点;RiceChem 开销 6.6% 同时 + 1.2 点 实测(事后交叉拟合)