


10 个关键问题问与答(Q&A)
Q1:CosmoH2G 要解决什么核心问题? A:解决从人类演示视频向机器人平行夹爪迁移复杂三维空间操作(物体旋转、翻转),现有方法大多只支持简单平面拾取‑放置,受本体差异、跟踪漂移限制。
Q2:数据集为什么用 UMI 手持夹爪采集,不用真实机器人遥操作? A:UMI 手持设备操作便捷,低成本复刻人手复杂运动;相比机器人遥操作,采集速度快、适合大规模生成配对样本,不用反复部署实体机器人。
Q3:数据集多大?复杂度优势是什么? A:1254 个物体、6189 条操作片段;相比 RT‑1、MimicPlay,样本包含大量大角度旋转、翻转,空间运动复杂度更高。
Q4:为什么不用直接端到端生成完整夹爪序列? A:复杂运动下直接端到端会产生误差累积漂移,微小轨迹偏差会被快速放大,抓取、放置精度大幅下降。
Q5:两阶段框架分别做什么? A:阶段 1:扩散模型预测起始、终止关键帧夹爪 6‑DOF 位姿,简化学习目标;阶段 2:基于关键帧生成完整动作序列。
Q6:第二阶段为什么解耦:模型学朝向,平移做后优化? A:夹爪朝向没有简单几何启发式,必须数据驱动学习;平移可以依靠 “人手‑夹爪抓取接触区域对齐” 先验初始化,再做优化修正,降低模型学习负担,抑制漂移。
Q7:夹爪姿态为什么采用三关键点表示,而不用四元数 / 齐次矩阵? A:三个关键点(中心、左右指尖)直接表达夹爪接触区域与朝向,和点云输入处于同一三维空间,消除跨域映射,降低学习难度,性能显著提升。
Q8:主要评价指标 GOA/SR/TS/TOPA 含义? A:GOA 抓取朝向角度误差;SR 任务放置成功率;TS 轨迹相似度;TOPA 最终物体放置朝向角度误差。角度越低、SR/TS 越高效果越好。
Q9:模型泛化能力有什么边界? A:对不同成年人手尺寸、多种相机视角泛化良好;儿童小手不在训练分布,性能显著下跌。
Q10:论文现存主要局限性和未来方向? A:局限:框架为开环系统,没有实时纠错,无显式碰撞规避。未来:扩充数据集;增加闭环反馈与碰撞感知运动规划;探索统一单阶段端到端模型。
关键词
-
机器人操作 -
从人类演示学习 -
人‑机器人跨本体迁移 -
模仿学习 -
扩散模型 -
6‑DOF 抓取生成 -
数据集构建 -
手持通用操作接口 (UMI)
附录 CosmoH2G:面向复杂空间运动物体操作的人手‑夹爪迁移数据集与基线方法
作者:赵鸿祥(香港中文大学(深圳),理工学院,中国);徐牧天†(真核智能,中国);金泽宇(香港中文大学(深圳),理工学院,中国);郝一鸣(香港中文大学(深圳),理工学院,中国);崔曙光(香港中文大学(深圳),理工学院;深圳未来网络研究院,中国);韩晓光†(香港中文大学(深圳),理工学院;深圳未来网络研究院;真核智能,中国) †通讯作者 项目主页:https://cosmoh2g.github.io 额外关键词:机器人操作、从人类演示学习、人到机器人迁移

图 1:CosmoH2G 是一套数据驱动框架,将人类手部运动迁移为机器人夹爪动作。输入杂乱场景下单目 RGB 人类演示视频(包含手部旋转、物体翻转),该框架把观测到的人手轨迹转换为夹爪可执行运动,即便是高难度的空间运动也能稳定执行。
摘要
将人类手部演示迁移至机器人夹爪,是机器人学习领域一种高性价比方案。但现有方法大多局限于简单平面任务,难以处理机器人操作中必不可少的复杂空间运动(例如旋转、翻转等复杂轨迹)。针对该研究缺口,本文采用细粒度手部姿态运动引导的隐式数据驱动方案。为此,本文搭建一套可扩展采集流程,用于采集人手‑夹爪配对演示数据。该流程遵循严格协议,优先保障运动复杂度,并借助手持夹爪实现动作的流畅复刻。基于该流水线,本文构建大规模配对数据集:包含1254 个独特物体,共计 6189 条操作片段,空间运动复杂度显著高于现有基准。
然而学习这类复杂映射仍然极具挑战。实验发现,简单端到端直接生成完整夹爪姿态序列效果不佳,在复杂动力学下微小轨迹偏差会快速累积放大。为此本文提出两阶段框架:第一阶段预测稀疏的夹爪关键帧姿态(初始帧与终止帧),简化映射学习目标;第二阶段基于上述关键帧生成完整连续动作序列。为缓解累积漂移,模型学习夹爪的朝向,同时结合抓取启发式规则以及运动学一致性对夹爪平移做后优化。
仿真、真实机器人实验表明,本框架能够稳定、精确地完成复杂空间操作的人手‑夹爪迁移,性能大幅超越传统基线方法。
1 引言
高质量大规模动作数据是机器人学习的基础,但获取这类数据集耗时费力。近期,利用人类演示(天然蕴含操作动力学特征)成为更加高效低成本的思路。但受限于形态、运动学、本体结构的巨大差异,现有研究大多只能完成简单平面物体操作(拾取‑放置、推物体),很难处理复杂空间运动。而旋转、翻转这类动作广泛存在于人类日常操作,是执行高难度机器人任务的必备能力(见图 2)。
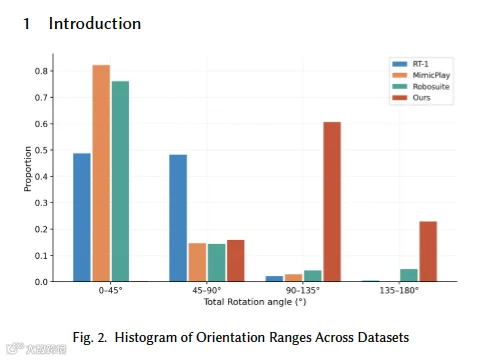
图 2:各数据集姿态转动范围统计直方图

现有方案分为两大范式:
- 基于规则的重定向
依靠手工设计运动学启发式,将人手关键点映射到机器人夹爪。但是在复杂空间运动中本体形态差异被放大,手工规则无法弥合本体鸿沟(图 4)。 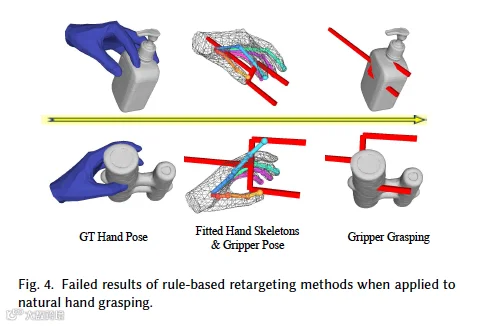
图 4:自然抓取场景下,基于规则的重定向方法的失败案例
- 轨迹条件方法
(分为优化类、学习类):从人类演示中提取本体无关、以物体为中心的运动路径指导机器人。但杂乱环境中很难可靠提取轨迹;更关键的是该类方法丢失人手姿态细粒度动力学信息,而该信息对复杂操作至关重要。当发生大角度旋转,跟踪点被遮挡,跟踪器会发生漂移,跟踪失效,光流结果严重恶化(图 3)。
本文提出两条核心见解:
- 从手工规则转向数据驱动映射
抛弃刚性显式运动规则,依靠大规模配对数据,让模型隐式学习人手‑夹爪之间复杂对应关系。 - 从仅使用轨迹转向人手姿态引导
仅依靠夹爪或者物体轨迹不足以完成复杂任务,必须引入人手姿态作为引导,使用人手‑夹爪配对数据学习细粒度姿态动力学。
基于上述两点,本文搭建面向复杂空间运动的可扩展人手‑夹爪配对数据采集流水线。
- 人手侧
制定严格采集协议,丰富轨迹与姿态变换,包含平面旋转、竖直翻转;针对同一个物体使用不同抓取手势,抓取物体不同功能区域,提升运动多样性。 - 夹爪侧
使用手持设备 UMI 采集,该设备易于操控,可以复刻人类复杂手部运动。利用深度相机采集单目 RGB‑D 视频;使用前沿姿态估计、跟踪模型提取统一全局坐标系下的高保真 3D 数据:6 自由度夹爪姿态、人手、物体点云、接触图,无需频繁重新标定。
得到数据集:1254 个物体、6189 条操作片段;空间运动复杂度显著高于现有人‑机器人迁移基准。
初步实验证明:暴力端到端直接把物体、人手点映射为夹爪动作,无法达到可靠抓取的精度。因此本文设计两阶段框架:
-
第一阶段:生成起始、终止帧的夹爪姿态,简化学习目标。 -
第二阶段:基于稀疏关键帧生成完整连续动作序列。
进一步做解耦设计缓解累积漂移:夹爪平移轨迹从人手操作序列推导,结合运动学一致性、抓取区域对齐做后优化;夹爪朝向没有简单几何启发,由配对数据隐式学习。
整套框架输入单目 RGB‑D 人类演示视频(深度可来自真实传感器或者预测模型)。仿真与真机实验和多种基线对比,在复杂空间任务上获得一致性能提升。
本文贡献总结
-
据我们所知,首个聚焦复杂空间运动的人手‑夹爪配对数据集。 -
可扩展人手‑夹爪配对数据采集流水线,重视操作复杂度;基于 UMI 建立严谨采集流程与高效标注方案。 -
两阶段数据驱动框架,实现复杂操作的人手‑夹爪迁移;该算法依托配对数据集才得以实现。
数据集、采集流水线、算法将会全部开源。
2 相关工作
2.1 基于人类演示的跨本体学习
从人类演示学习,是替代昂贵机器人采集数据的高可扩展低成本路线。一部分工作使用人类视频演示训练机器人策略;另一部分研究单样本模仿:仅依靠一段人类演示,让机器人完成新任务。
单样本模仿的一类主流做法是运动学重定向,逐帧将人手姿态映射为机器人末端姿态。实现简单,但会引入人‑机器人本体差异带来的误差。 另一类是轨迹条件策略,使用本体无关、以物体为中心的表征。但二维轨迹无法感知朝向变化;三维轨迹方法依靠光流跟踪点 SVD 求解姿态,一旦复杂运动发生跟踪漂移,性能就会下降。因此数据驱动路线更有前景。 Human2Robot 虽然构建配对数据集,但依靠繁琐的机器人遥操作采集,任务简单,几乎不存在姿态变化,可扩展性差,无法泛化到真实场景的人类演示。本文利用 UMI 构建高质量可扩展配对数据集,重点针对物体复杂空间运动。
2.2 机器人学习数据采集
传统机器人演示采集手段为遥操作,由人直接操控机器人生成数据。大量研究使用 VR 实现遥操作,部分工作利用 VR 采集人‑机器人配对演示用于模仿学习。但遥操作人力成本高,很难完成精细复杂任务。
UMI(通用操作接口)手持设备的出现,使得便捷规模化采集机器人数据成为现实。很多研究为 UMI 增加触觉、深度点云等传感器。本文利用 UMI 规模化采集面向复杂物体运动的高质量人‑机器人配对数据集;搭配深度相机提取三维动作,切换场景时无需反复标定。
2.3 手部条件的抓取检测与生成
面向平行夹爪的任务导向抓取生成,越来越多研究直接从人类手部演示学习。 早期端到端映射大多依赖手工规则。例如 Phantom 将拇指食指中点作为抓取点,无法适配多样化人类抓取,生成机器人抓取不稳定。 后续学习类方法将抓取生成分解为两阶段:先采样任务无关抓取候选,再利用人类先验(抓取区域、区域‑朝向联合约束)筛选。该方案需要大量采样同时满足稳定性与任务约束,效率较低。 最新研究采用单阶段生成模型,以手部观测作为条件直接输出抓取姿态,统一生成与任务对齐。本文将该思路拓展至动作序列生成,因为任务意图往往蕴含在一整段手部操作序列之中。
3 数据集
数据集三大特点:
-
高可扩展采集策略:使用 UMI 手持夹爪,采集固定视角配对 RGB‑D 视频。 -
从原始 RGB‑D 视频提取三维运动数据,服务跨本体学习。 -
对比其他数据集,本数据集任务拥有更多样、更复杂的空间运动。
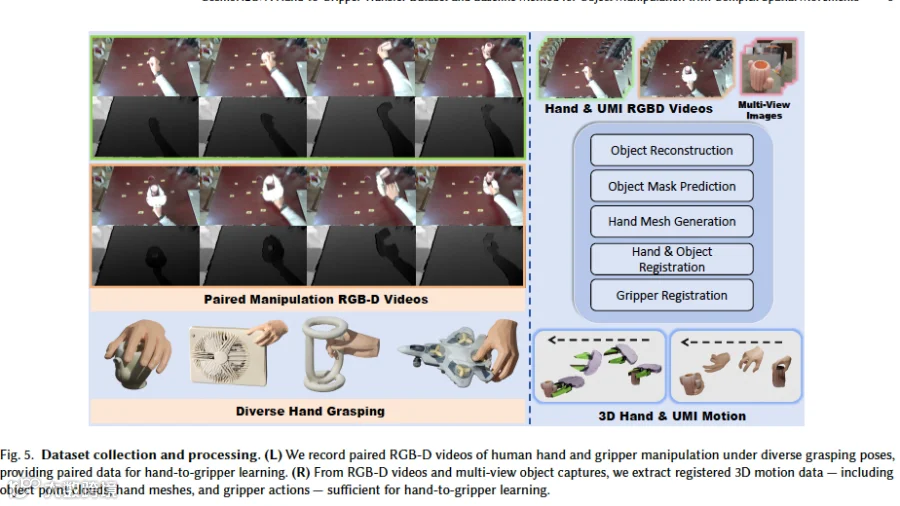
图 5:数据集采集与处理。左:录制人手、夹爪配对 RGB‑D 操作视频,为手‑夹爪迁移提供配对数据;右:从 RGB‑D 视频、多视角物体采集结果提取配准完毕的三维运动数据:物体点云、人手网格、夹爪动作。
3.1 数据采集
数据集的多样性体现在两点:包含丰富自然人手抓取手势(不限于捏取),提升模型对真实世界人类演示的泛化;包含复杂手内旋转,学习超越简单平移的高级操作技能。
采集策略:
-
人手操作阶段:采集者自由变换手势、变换与物体的接触区域,不做约束。 -
每个任务包含复杂姿态变换:平面旋转、竖直翻转,模拟杂乱环境的精准放置。 -
配对夹爪视频:操作者手持 UMI 复刻完全相同任务,复刻人类演示的接触区域、抓取朝向、操作运动。 -
校验过滤:保证人类演示与 UMI 演示在起始帧、终止帧物体姿态对齐,偏差大的片段直接丢弃。
最终数据集:1254 个不同物体,6189 条操作片段。每个物体采集 3‑5 组配对演示。
3.2 三维运动数据提取
为保证可扩展性,不依赖复杂标定设备,直接从 RGB‑D 视频提取三维运动数据,共四步:
-
使用 ReconViaGen 做多视角图像物体网格重建; -
将物体在三维场景配准; -
重建并配准人手网格; -
UMI 夹爪的配准与跟踪。
整套流程使用 FoundationPose++,输入 RGB‑D 帧、网格、初始掩码完成配准跟踪。
物体与人手处理:起始帧、终止帧没有人手与 UMI 遮挡,利用这两帧做配准。人手‑物体检测器检测物体包围框,SAM2 生成掩码。人手不做逐帧跟踪,使用 WiLoR 对采样帧重建人手网格、掩码,直接注册到三维场景。
UMI 夹爪配准跟踪:标注 UMI 抓取开始帧、操作结束帧;点击交互用 SAM2 生成起始帧掩码;结合 UMI 的 CAD 模型、预测掩码,完成全序列配准跟踪,输出 6 自由度姿态序列,直接作为机器人动作数据。
数据集配对过滤:对每一组人手‑UMI 配对计算三维轨迹相似度(附录 D.1),只保留相似度大于 0.9 的样本。保留样本平均相似度 0.957,中位数 0.958,配对质量很高。
3.3 数据集统计信息
本数据集核心特征为复杂空间运动,用操作总旋转角度做量化指标。现有主流机器人数据集(Robosuite、MimicPlay、RT‑1)大多是推、滑动、拾取放置这类以平移为主、几乎没有姿态调整的动作。图 2 直方图显示本文数据集姿态变化幅度远大于现有数据集。
物体分为五大类别,占比:
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
-
食品:蛋挞、油条、吐司、冰淇淋等烘焙食品、零食; -
装饰:铜制摆件、花瓣饰品、金马摆件、海螺贝壳; -
美妆:化妆刷、哑光口红; -
日用品:三层抽屉收纳、木质手表支架、按压喷雾瓶; -
玩具:相机模型、火车、挖掘机、植物大战僵尸手办。
4 方法
任务目标:输入人类视频中的人手运动,输出机器人末端执行器 6‑DOF 姿态序列。现有优化类、轨迹类方法在复杂空间运动任务性能下降。本文完全基于配对数据集,使用纯数据驱动学习迁移映射,不依赖任何预定义对齐规则。采用两阶段框架:
-
阶段一:预测起始帧、终止帧 6‑DOF 夹爪姿态; -
阶段二:生成完整操作姿态序列。
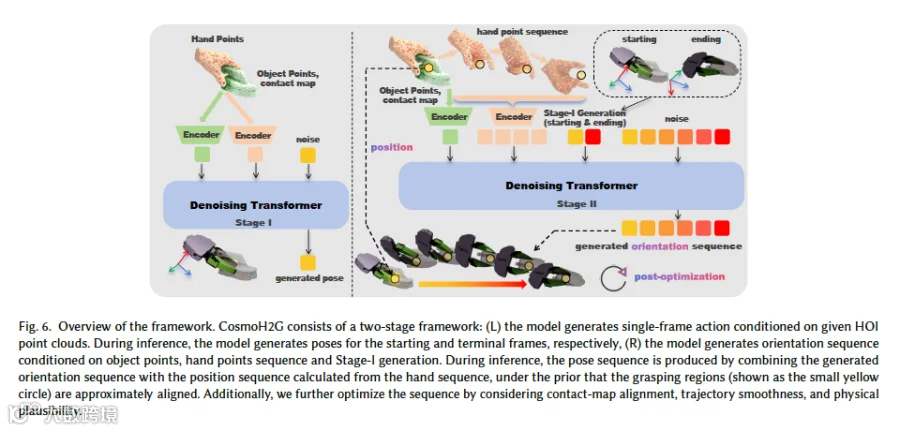
图 6:框架总览。CosmoH2G 两阶段框架。左:输入人‑物交互点云,模型生成单帧动作;推理阶段分别生成起始、终止帧姿态。右:以物体点云、人手点序列、阶段一输出作为条件生成朝向序列;推理时,生成的朝向结合从人手序列算出的位置序列(黄色小圆代表抓取区域)得到姿态序列;再结合接触图对齐、轨迹平滑、物理合理性进行后优化。
4.1 问题形式化
输入单段人类演示 RGB‑D 视频(深度来自采集或模型预测),希望机器人复现该任务。人类演示视频 \(V^{h}=\{I_{i}^{h}\}_{i=0}^{N^{h}-1}\),\(N^h\)代表总帧数。经过 3.2 处理得到三维数据:起始、终止帧物体点 \(p_{i=0}^{o},p_{i=-1}^{o}\);从 MANO 人手网格采样得到人手点序列 \(\{p_{i}^{h}\}_{i=0}^{N^h-1}\)。
- 阶段一
模型独立生成起始帧夹爪姿态 \(g_{i=0}\in SE(3)\)、终止帧夹爪姿态 \(g_{i=-1}\in SE(3)\);条件输入为人手点、物体点、接触图(附录 A.3)。 - 阶段二
以人手点序列、物体点、接触图、阶段一输出为条件,生成夹爪朝向序列;夹爪位置序列基于抓取区域对齐先验从人手点序列推导,再做优化。
4.2 阶段一:生成起始与终止动作
训练去噪 Transformer 扩散模型,独立生成起始帧、终止帧单帧 6‑DOF 夹爪姿态;条件输入:人手点云、物体点云、接触图。
点特征:两套独立 Point‑Transformer 编码器 \(\theta_1,\theta_2\),分别提取物体、人手点云全局特征。物体编码器 \(E_{\theta_1}^o\) 输入物体点 \(p^o\) 和逐点接触图 m,输出物体特征 \(f^o\);人手编码器 \(E_{\theta_2}^h\) 输入人手点 \(p^h\),输出人手特征 \(f^h\),特征维度为 d。
本方法仅需要粗糙接触区域,不需要手指级精准接触:①开源人手估计器的接触误差大多出现在手指;②五指人手和两指夹爪本体差异巨大,精细手指位置对迁移没有意义。
动作表示:不使用齐次变换矩阵 / 四元数‑平移对。借鉴 HGDiffuser,用夹爪三个关键点(夹爪中心、左指尖、右指尖)参数化 SE (3) 姿态。优势:条件输入与生成动作共享三维点空间,消除跨域映射,简化学习。关键点坐标通过线性层投影为特征 token;去噪结束再用线性层映射回动作空间。
模型 \(G_{\eta_1}\) 使用均方误差损失训练:
\(L_{MSE}=\mathbb {E}_{a_{0},t}\left[ \| a_{0}-\mathcal {G}_{\eta _{1}}\left( a_{t},t,f^{o},f^{h}\right) \| _{2}^{2}\right]\) \(a_0\):真值干净动作(三关键点);\(a_t\):扩散时间步t的带噪声动作;总扩散步数 \(T=1000\);\(f^o,f^h\)分别为物体、人手特征。
4.3 阶段二:预测动作序列
直接训练扩散 Transformer 同时生成完整位置 + 朝向姿态序列会带来严重累积漂移。因此采用因子化解耦策略:模型只学习朝向映射;位置序列从人手视频推导,再通过优化做修正。
朝向序列生成:夹爪位置由中心点定义;朝向由左右指尖相对于中心点的相对位置定义。阶段二模型只学习生成朝向序列;真值监督来自夹爪关键点的相对坐标。条件输入:物体点 + 接触图、全部帧人手点序列、阶段一输出的起始、终止姿态。人手序列每一帧、噪声朝向序列每一帧编码为独立 token;起始、终止姿态也作为 token 送入 Transformer,逐步去噪输出干净朝向序列。
模型 \(G_{\eta_2}\)损失:
\(L_{MSE}=\mathbb {E}_{s_{0},t}\left[ \| s_{0}-\mathcal {G}_{\eta _{2}}(s_{t},t,f^{o},\{ f_{i}^{h}\} _{i=1}^{N_{h}},\hat {a}_{0},\hat {a}_{-1})\| ^{2}\right]\) \(s_0\):真值朝向序列;\(s_t\):时间步t带噪声朝向序列;\(\hat a_0,\hat a_{-1}\):阶段一生成的起始、终止动作。
位置序列优化(推理阶段)初始化:基于 “人手‑夹爪接触区域空间对齐” 先验,由人手轨迹初始化夹爪位置序列。初始化结果没有物理约束,执行三步优化:
- 起止帧位置优化,保证抓取稳定
\(\Delta x^{*}=arg min _{\Delta x}\left[L_{contact }+\lambda_{pen } L_{pen }+\lambda_{reg }\| \Delta x\| ^{2}\right]\) \(\Delta x\):起止帧夹爪位置修正;\(L_{contact}\)促使夹爪靠近人手接触区域;\(L_{pen}\)惩罚物体穿透;\(\lambda_{pen},\lambda_{reg}\)为权重。
- 中间帧优化:固定起止位置,优化中间帧,保证轨迹平滑且贴近初始化参考曲线
\(\left\{x_{i}^{*}\right\}=arg min _{\left\{x_{i}\right\}} \lambda_{smooth } L_{smooth }+\lambda_{ref } L_{ref }\) \(L_{smooth}\)惩罚运动突变;\(L_{ref}\)约束每一帧靠近初始化位置插值得到的参考曲线。
- 逆运动学 IK 优化,保证运动学可行
\(a_{i}^{*}=arg \operatorname* {min}_{a_{i}}\left[ L_{i k}\left(a_{i}\right)+\lambda_{reg }\left\| a_{i}-\overline{a}_{i}\right\| ^{2}\right]\) \(\bar a_i\):该帧初始化姿态(优化后位置 + 模型生成朝向);\(L_{ik}\)惩罚 IK 求解与目标姿态的误差、关节越界;第二项正则,姿态不能远离初始化。
4.4 实现细节
两阶段全部使用基于 Transformer 的扩散模型;物体、人手分别使用 Point‑Transformer 编码器输出 256 维特征。夹爪姿态使用三关键点表示,线性层映射为 token。 两个去噪 Transformer 从零开始训练,AdamW 优化器,固定学习率\(10^{-4}\),batch size=32,单张 A100 显卡训练 20000 步。扩散总步数 1000,余弦噪声调度;推理 DDPM 采样,采样步数 500。
5 实验
从三个维度评估 CosmoH2G:①人类演示引导下的带朝向抓取;②轨迹贴合度、最终放置精度;③目标放置朝向精度。
5.1 实验设置
数据集按物体划分;测试集包含 40 个未见物体,合计 186 个样本。主要任务为拾取‑放置,测试包含未见过的人手运动;更多任务类型留作未来工作。 仿真环境 GalaxeaManipSim,机器人本体 R1‑Lite;测试片段完整在仿真重建,物体几何、初始配置、目标放置完全复现人类演示。真实机器人使用 Galaxea R1‑Lite。
评价指标
- GOA 抓取朝向精度
执行抓取姿态与真值抓取姿态角度偏差,角度越小越好;评估复现演示抓取朝向的能力。 - TS 轨迹相似度、SR 任务成功率
TS 衡量机器人轨迹和演示轨迹贴合;SR 衡量任务是否完成。 - TOPA 目标放置朝向精度
物体最终姿态与目标姿态的角度误差;角度越小放置朝向越精准。
基线选择:基于规则重定向的方法在本任务中甚至无法完成抓取(图 4),因此只对比轨迹类基线。
-
优化类基线:MimicFunc、3DFlowAction -
学习类基线:Im2Flow2Act、Track2Act(无公开权重,在本文数据集重新训练)
5.2 实验结果
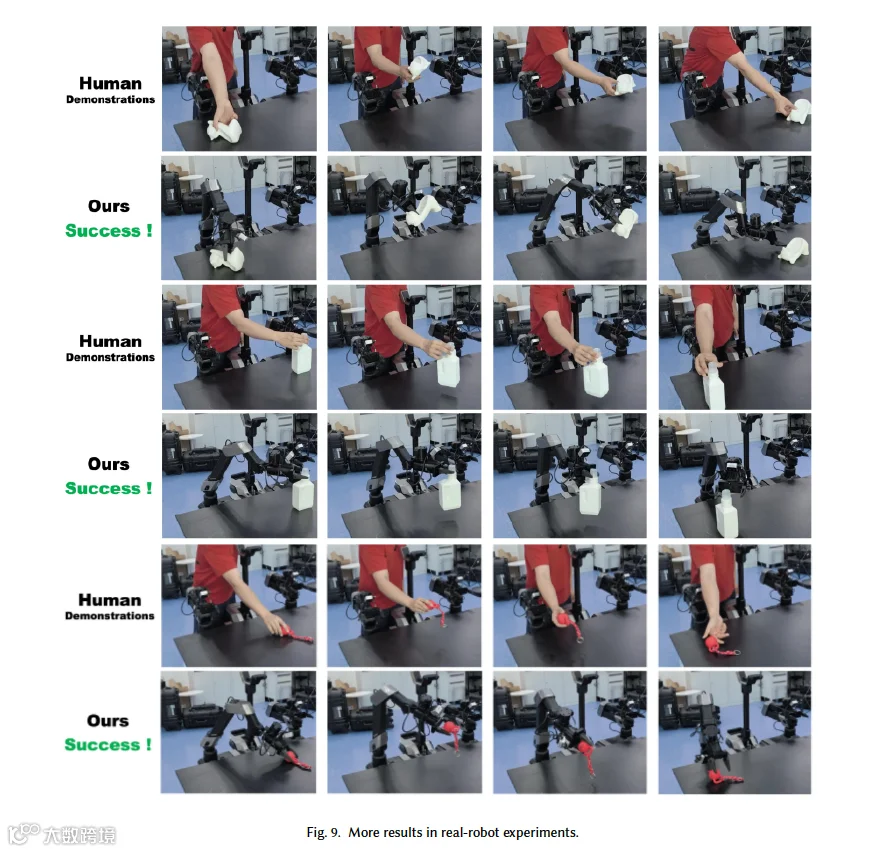
仿真、真实机器人上 CosmoH2G 全面优于基线。真实机器人性能略低来自两点物理现实:①大角度旋转过程物体打滑,姿态偏移甚至掉落;②物体未完全抬离桌面就发生移动,摩擦力过大导致掉落。
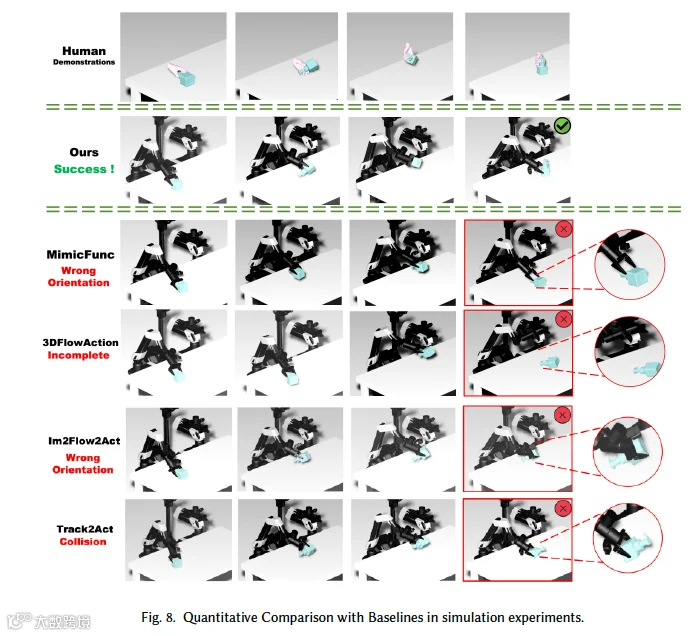
MimicFunc 依赖 CoTracker 跟踪,复杂空间运动发生遮挡时跟踪退化,动作生成出错。3DFlowAction、Im2Flow2Act 依赖二维跟踪,引入大量误差。即便在本文数据集重新训练,Track2Act 的计算‑修正框架,当计算结果与目标动作偏差较大时预测效果变差。 消融证明性能提升并非来自接触图输入;即便移除接触图,CosmoH2G 依旧优于全部基线。
表 2:仿真、真实机器人定量对比 | 方法 | 仿真‑GOA (°) ↓ | 仿真‑SR ↑ | 仿真‑TS ↑ | 仿真‑TOPA (°) ↓ | 真机‑GOA (°) ↓ | 真机‑SR ↑ | 真机‑TS ↑ | 真机‑TOPA (°) ↓ | |---|---:|---:|---:|---:|---:|---:|---:|---:| | 优化‑重定向| | | | | | | | | | MimicFunc |19.37 |56.45% |0.7673 |32.47 |19.37 |43.01% |0.7714 |44.84 | | 3DFlowAction |20.84 |44.62% |0.6752 |29.17 |20.84 |36.02% |0.7936 |47.27 | | 学习类| | | | | | | | | | Im2Flow2Act |29.86 |57.53% |0.7835 |50.27 |29.86 |51.61% |0.7381 |57.89 | | Track2Act |10.67 |77.42% |0.9015 |12.48 |10.67 |60.22% |0.8732 |20.58 | | 本文 Ours|7.53|83.87%|0.9672|10.27|7.53|70.43%|0.9413|19.34|
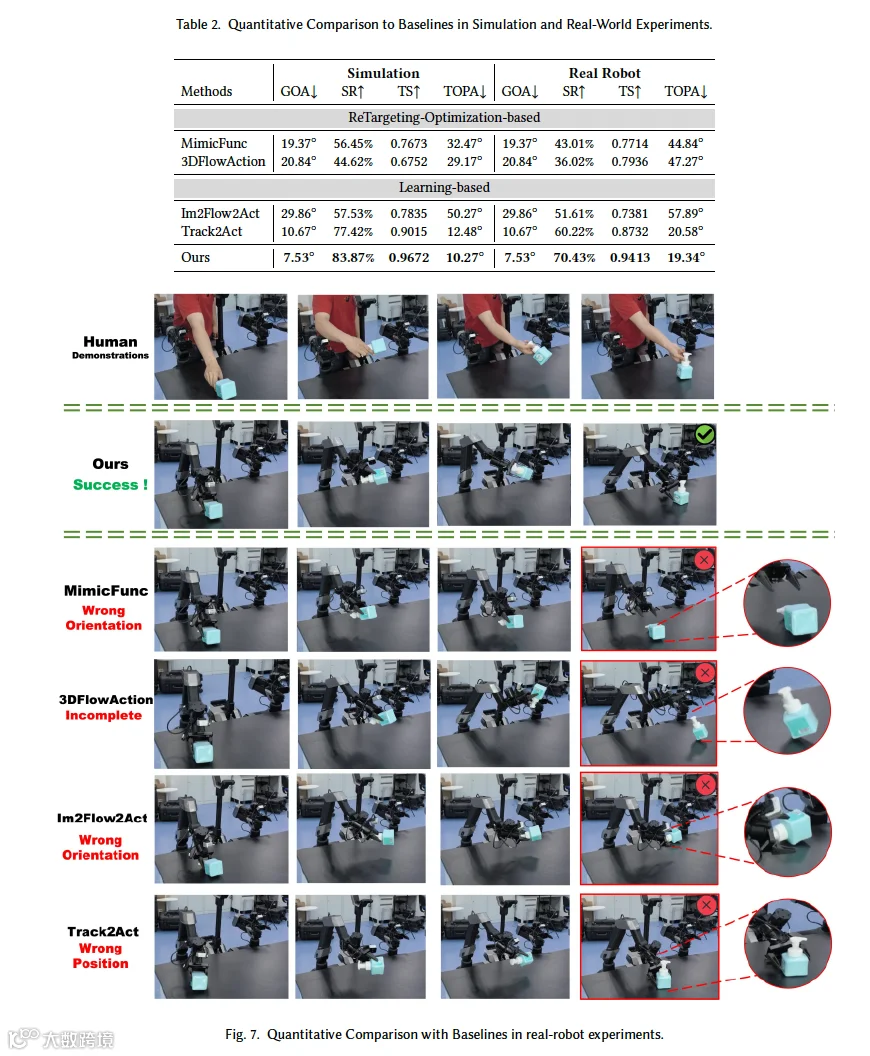
图 7:真实机器人基线可视化对比;图 8:仿真实验基线可视化对比。基线会出现朝向错误、任务中断、碰撞、位置错误等失败。
5.3 消融实验
表 3:消融:单阶段 vs 两阶段(仿真)。全部单阶段方案性能显著变差,证明单阶段框架本身存在性能上限。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
7.53 | 83.87% | 0.9672 | 10.27 |
表 4:消融:模型条件输入(仿真)。去掉接触图小幅下降;去掉终止帧条件,TOPA 大幅变差;终止姿态约束对放置朝向精度至关重要。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
7.53 | 83.87% | 0.9672 | 10.27 |
表 5:消融:机器人动作表征(仿真)。三关键点表征优于齐次矩阵、四元数,关键点显式表达夹爪接触区域、朝向。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
7.53 | 83.87% | 0.9672 | 10.27 |
表 6:消融:阶段二生成策略(仿真)。Direct:直接生成位置 + 朝向;Computed:全部依靠几何计算 + 优化;Ours:生成朝向,优化平移。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
7.53 | 83.87% | 0.9672 | 10.27 |
6 结论
本文提出 CosmoH2G,面向复杂空间物体操作的数据驱动人手‑夹爪迁移方案。数据层面:搭建优先保障运动复杂度的可扩展采集流水线,构建大规模人手‑夹爪配对数据集(1254 物体,6189 片段),空间操作复杂度远超现有基准。算法层面:采用两阶段学习框架,先预测关键帧姿态,再生成完整连续动作序列。实验证明该方法可以实现复杂空间操作稳定、精准的人手‑夹爪迁移。
7 局限性与未来工作
虽然两阶段框架可以很好完成空间迁移;但随着配对数据集进一步扩大,统一单阶段直接迁移方案会变得可行。未来计划利用本流水线扩充数据集,优化架构,提升泛化性能。 当前框架是开环系统,没有实时纠错,也没有显式碰撞规避。未来重点方向:引入闭环反馈、碰撞感知运动规划。 我们希望数据集与框架,能够为未来数据驱动跨本体学习、复杂机器人操作研究提供基础。
致谢
本研究得到广东省重点研发项目、深港河套项目、国家自然科学基金、广东省杰出青年基金、深圳市优秀人才基金、广东省未来智能网络重点实验室、深圳市大数据与人工智能重点实验室、广东省无线电科学数据中心、国家重点研发计划的资助。
附录 A 实现细节
A.1 配准跟踪可视化

图 10:配准跟踪可视化。UMI 配准将 UMI 底座直接注册进三维场景,输出 6‑DOF 姿态直接作为夹爪姿态。
A.2 夹爪关键点可视化

图 11:夹爪关键点示意图:中心点、左指尖、右指尖。
A.3 手‑物体交互接触图
统一坐标系下人手点云 \(\{p_{i}^{h}\}\)、物体点云 \(\{p_{j}^{o}\}\)。对物体每一个点,构建人手点 KD‑Tree,查询最近邻距离 \(d_j\)。设置最大交互半径 \(d_{max}\),计算归一化软接触置信:
\(m_{j}=clip\left(1-\frac{d_{j}}{d_{max}}, 0,1\right)\) \(m_j=1\)代表直接接触;距离超过\(d_{max}\)线性衰减到 0;设置阈值筛选高置信接触点集合 V。
A.4 位置序列优化
初始化:推理阶段,基于 “人手‑夹爪接触区域对齐” 先验,由人手接触中心初始化夹爪位置序列。 人手接触中心:人手点到物体距离小于阈值的点的质心; 夹爪接触中心:夹爪左右指尖的中点。以此锚点得到夹爪位置初始序列,后续再优化。
然后执行抓取优化、逆运动学优化,公式见原文。
A.5 真实机器人实验设置
Galaxea R1‑Lite 机器人,两套 7‑DoF A1X 手臂,G1 平行夹爪。世界坐标系原点设置在桌角。双目相机固定在原点上方 0.4m 向下拍摄;每次采集前做相机‑机器人外参标定。全部实验机器人从固定初始位姿启动。物体位置相对于锚点计算;物体姿态由 FoundationPose++ 估计。
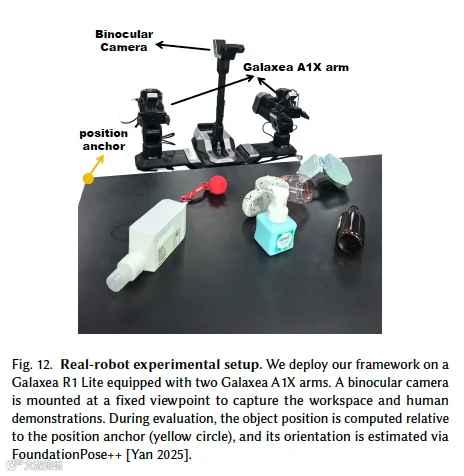
图 12:真实机器人硬件实拍图。
A.6 仿真设置
物体质心为网格几何中心;等效密度约\(1000\mathrm{kg/m^3}\),接触摩擦系数 0.15。该物理配置和 GraspVLA、Im2Flow2Act 保持一致。
附录 B 基线细节
优化类基线 MimicFunc、3DFlowAction,先用 GraspNet/AnyGrasp 采样初始抓取位姿,再通过物体变换得到完整序列。本文不对比基于规则重定向基线,因为该类方法主要面向捏取手势,在本文任务中持续失败。 Track2Act 在本数据集重新训练,输入替换为 3D 人手点序列;即便提供更强 3D 输入,性能依旧低于 CosmoH2G。
附录 C Computed 变体细节
Computed 变体不使用生成模型,全部依靠计算 + 优化得到夹爪序列。 核心难点:人手与夹爪形态差异巨大,不能直接把人手姿态作为夹爪朝向优化目标。因此引入物体作为几何中间锚点。利用初始帧稳定抓取的刚性假设,由人手网格序列反推物体完整 6D 轨迹。 边界抓取姿态从 GraspNet 采样筛选;中间帧朝向使用 SLERP 球面线性插值;再执行完整优化。 该变体在翻转等复杂任务上失败:SLERP 插值初始化与真实朝向差距大,优化器陷入局部解;位置、朝向联合优化存在大量等价解,破坏时间连续性,出现突变运动。证明朝向轨迹必须从数据中学习。
附录 D 评价指标定义
D.1 轨迹相似度 TS
使用 FastDTW 计算真值、执行轨迹的动态时间规整距离;使用任务容忍阈值做归一化,得到\([0,1]\)相似度分数。
\(S=1-min \left(\frac{D_{metric }}{\tau}, 1\right)\) 人手轨迹取人手接触区域中心点;夹爪轨迹取夹爪接触中心点。真机从关节编码器 + 正运动学获取轨迹;仿真直接从物理引擎读取末端位姿。
D.2 成功率 SR
物体最终放置位置与目标的欧氏距离小于桌面宽度 10% 判定成功。
\(R=\frac{N_{success}}{N}\times100\%\)
D.3 目标放置朝向精度 TOPA
取每一轮物体最终姿态与目标姿态角度误差的平均值,单位度。
\(TOPA =\frac{1}{N} \sum_{i=1}^{N} \theta_{i}\)
附录 E 泛化分析
- 不同演示者人手尺寸
模型对成年男女泛化效果好;儿童手尺寸不在训练分布,性能明显下降。 - 不同相机视角
因为输入是视频重建得到三维数据,模型对第一人称、俯视、第三人称等视角不敏感,仿真下 SR 维持 75%‑90%。 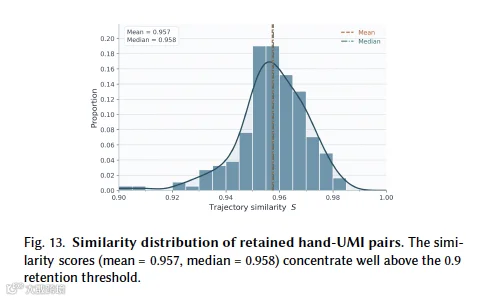
图 13:保留配对样本的轨迹相似度分布直方图,均值 0.957,中位数 0.958,全部大于 0.9 筛选阈值。
参考文献
省略。。。。。。