

Agent越来越强,但真正决定一个Agent能不能把任务做好的,并不只有底层大模型。
模型外面的提示词、工具、工作流、记忆和上下文管理,同样会直接影响Agent的执行效果,这些部分被称为 Agent Harness。
最近,Google Cloud AI Research联合北卡罗来纳大学教堂山分校、斯坦福大学等高校研究者,提出了 RRSI(Regularized Recursive Self-Improvement of Agent Harnesses),发布当天就登上了Hugging face 日榜第二。
研究的就是一个越来越重要的问题,Agent Harness自己不断进化,会不会也“学过头”?
论文发现,现有的Harness自动进化方法,很容易在自己反复优化的任务上获得明显提升,但换到没见过的任务和基准后,效果却大幅下降。
RRSI的思路很直接,不限制Harness能改什么,而是限制它“怎么改”。
最终,在8个基准、3类任务上的实验中,RRSI在进化任务上最高提升14.1个百分点,在未参与进化的OOD基准上最高提升4.7个百分点,同时相比未加正则化的进化方法,策略Token消耗明显降低。
-
论文题目: RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
01
Agent Harness自己进化,
也会过拟合
既然Agent的执行能力不仅取决于模型,那么一个自然的问题能不能让Agent自己不断修改Harness,从而获得更强的任务能力?
RRSI关注的正是这一方向。
它让Agent根据任务执行结果和反馈,持续调整自己的Prompt、工具调用方式、控制流程、Memory等组件,并通过“提出修改—测试效果—保留有效修改”的循环,让Harness逐步完成自我进化。
但问题也随之出现。
如果每一轮修改都只盯着当前的进化数据集,Agent很容易学会一些只对当前任务有效的技巧。
在有限的测试集上,分数可能不断上涨,但换到新的任务或未见过的基准后,性能却可能下降。
这其实和模型训练中的过拟合类似,Harness不是学会了更通用的解决方法,而是在“记住”当前的评测环境。
因此,RRSI并没有单纯追求让Harness“改得更多”,而是进一步约束哪些修改值得提出、哪些修改值得保留,让Harness的自我进化能够真正迁移到新的任务上。
02
RRSI给Harness进化加上两道“门”
RRSI把正则化放在了Harness进化过程的两个位置:Proposal端 + Selection端。
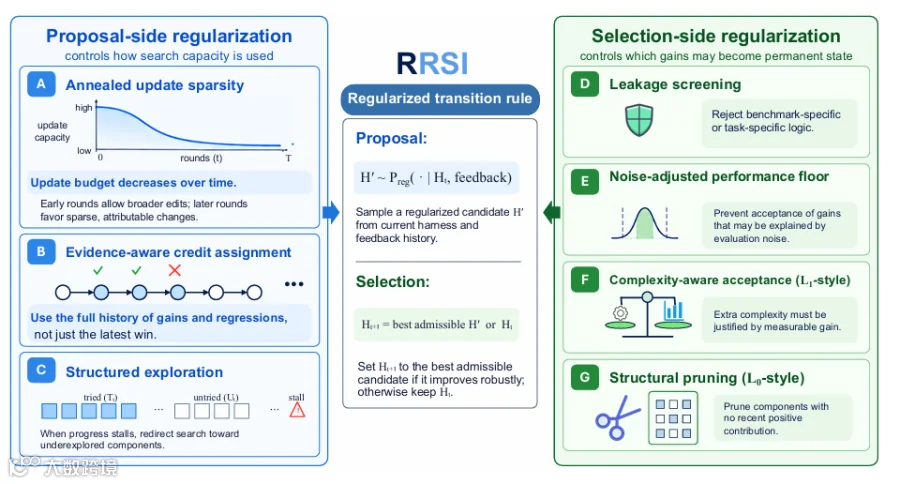
前者控制“怎么改”,后者控制“哪些修改能留下”。
第一道门是限制一次修改到底能改多少东西。
在进化早期,允许模型进行相对大范围的修改,用来探索新的机制;随着进化轮次增加,修改预算逐渐下降,让后面的更新越来越小、越来越容易判断究竟是哪一个改动带来了效果。
也就是说前期大胆探索,后期精细修改。
同时,RRSI还会记录之前每次修改改了什么、测试了什么假设、最终得分和Token成本发生了什么变化。
如果某个方向已经被证明没有效果,后续就不会反复在同一个方向上浪费搜索资源。
当搜索长期没有明显进展时,RRSI还会主动把一部分搜索预算转向之前没有尝试过的Harness组件。
这样可以避免Agent一直反复修改同一个Prompt,却忽略工具、Memory或者控制流程等其他部分。
第二道门则负责判断,一个看起来有效的修改,到底值不值得留下。
RRSI首先使用critic检查候选修改,过滤掉直接写入任务名称、实体名称、答案或者其他Benchmark特定信息的方案。
随后,它还会考虑评测噪声。
如果一次成绩提升可能只是随机波动,RRSI不会轻易接受。
同时,如果一个修改虽然提高了成绩,却带来了大量额外Token消耗,也需要证明这部分成本是值得的。
对于长期没有带来正向收益的组件,RRSI还会进一步进行结构化裁剪。
所以,RRSI并不是简单地让Agent“改得更多”。
它真正做的是让每一次修改都更有依据,让留下来的机制更可能具有可迁移性。
03
进化集涨得少了,
OOD反而涨得更多
RRSI最终在三个领域、8个Benchmark上进行了测试,包括Coding、Agentic Workspace和Engineering Design。
其中,Coding包括Terminal-Bench 2.1和SWE-bench Verified;Agentic Workspace包括Harvey LAB、JobBench、GDPval和APEX-Agents;Engineering Design则包括EngDesign和Frontier-Eng。
实验结果非常有意思。
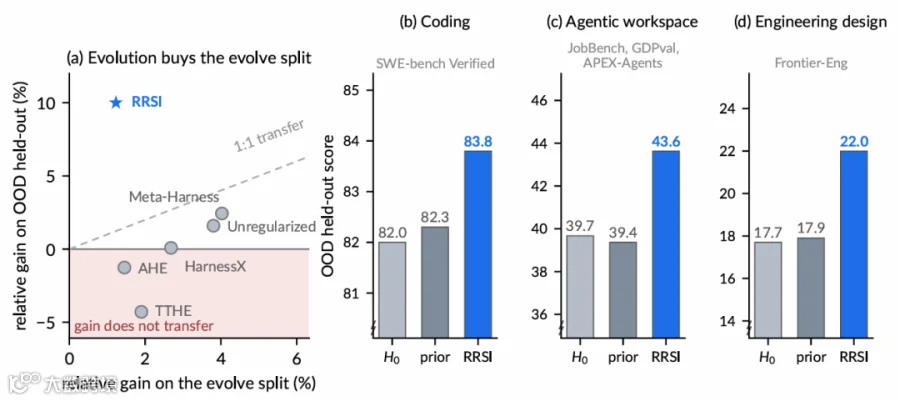
在Terminal-Bench 2.1上,RRSI从基础Harness的74.2%提升到80.2%,提高6.0个百分点;但真正没有参与进化的SWE-bench Verified上,也从82.0%提升到了83.8%。
在Agentic Workspace任务中,RRSI在Harvey LAB进化集上提升1.1个百分点,而在JobBench、GDPval和APEX-Agents三个OOD基准上分别提升4.7、3.5和3.7个百分点。
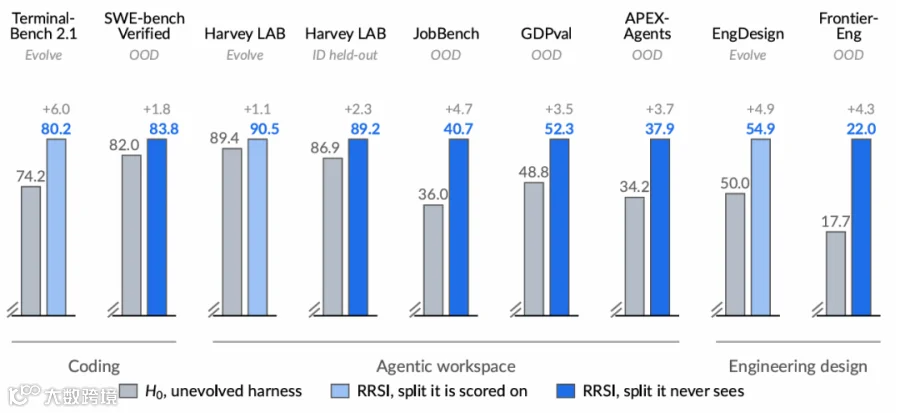
在Engineering Design中,EngDesign进化集提升4.9个百分点,完全没参与进化的Frontier-Eng则提升4.3个百分点。
更值得注意的是,RRSI并没有追求进化集上的最高分。
在Agentic Workspace实验中,未加正则化的进化方法可以把Harvey LAB的成绩做到92.8%,而RRSI只有90.5%。
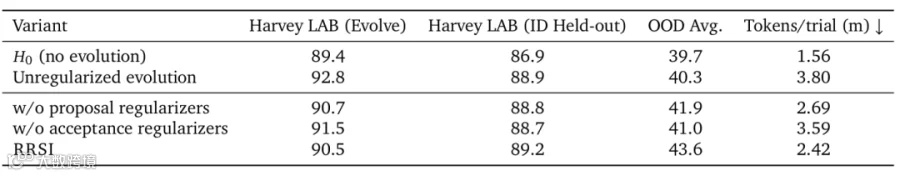
但到了OOD平均成绩,未正则化方法只有40.3%,RRSI则达到43.6%。
同时,未正则化进化每次试验平均需要3.80M个Policy Tokens,而RRSI只需要2.42M。
这恰恰体现了RRSI的目标,不只是让Harness在“练习题”上拿到最高分,而是让它学到真正可以迁移的Agent机制。
论文还进一步测试了不同模型。

使用Gemini 3.5 Flash进行Harness进化时,Terminal-Bench 2.1从64.6%提升到78.7%,并在从未参与进化的SWE-bench Verified上获得2.2个百分点提升。
即使把进化得到的Harness换到从未参与搜索的Gemini 3.1 Flash Lite上,Terminal-Bench 2.1也从11.2%提升到14.6%。
这说明RRSI学到的并不完全是某个特定模型的“使用技巧”。
至少在论文测试范围内,一部分Harness机制可以跨任务、跨Benchmark,甚至跨模型迁移。
04
Agent自我进化,
下一步不是“改得更多”
从RRSI的实验来看,Agent Harness的自动进化正在从简单的“试一个修改,看分数涨不涨”,走向更加系统的搜索过程。
如果Harness不断根据同一批任务反馈修改自己,那么它同样可能出现过拟合。
因此,真正需要解决的问题已经变成:怎样让Agent从自己的执行反馈中学到可复用的机制,而不是记住某个Benchmark。
RRSI给出的答案,是把传统机器学习中的正则化思想引入Harness进化;
限制单轮修改规模、记录历史证据、鼓励探索未尝试方向,同时过滤任务泄漏、控制评测噪声、限制额外成本,并删除长期没有贡献的组件。
这也意味着,未来Agent的自我改进可能不只是“让Agent自己改代码”。
如何控制它的搜索空间、如何判断一次改进是否真的有效,以及如何让改出来的能力迁移到没见过的任务,可能会成为Agent自我进化的重要问题。
END
关注+星标,获取AI前沿进展与开源一线动态