

智猩猩AI整理
编辑:金水
长程 LLM Agent 在做仓库级工程、跨应用流程、多步骤实验时,一旦早期计划走偏,或中间删错文件、改坏配置,错误会沿着上下文和环境状态一路扩散,后续再怎么“修修补补”,也很难把局面扳回来。
现有工作多在事前下功夫,更好的规划、更严的安全检查、或失败后再开一轮并带上经验,真正发生在同一次执行中途的系统性恢复,几乎是空白。
为此,来自中国科学院大学、清华大学的研究者提出了 AgentRewind,一套面向长程 Agent 的运行时恢复框架。
当前轨迹难以推进时,Agent 可回退到更早检查点,同时恢复上下文与工作区,并把对失败尝试的总结(rewind memory)注入后继续执行。
在他们构建的长程工程基准 MettleBench(82 个任务、有序验收清单)上,以 GPT-5.4 为例,AgentRewind 将任务成功率从 Continue 的约 62% 提升到约 88%,平均清单进度从约 81% 提升到约 94%;
在多种 harness 与 Terminal-Bench 2.0 上也同样优于“硬继续”和“整任务重启”。
下面按框架设计、工程实现与实验,展开 AgentRewind 如何做到“可恢复的长程执行”。
-
论文题目: AgentRewind: Recoverable Execution for Long-Horizon LLM Agents
01
让长程 Agent 也能“倒带重来”
长时序任务中,早期决策失误会同时污染 Agent 的对话上下文与外部文件环境;全局重启虽能清场,却丢弃已完成工作,带来大量重复计算。
为同时缓解「状态污染」与「重启浪费」,本文设计并实现可恢复执行框架 AgentRewind。
框架以非侵入式运行时中间层的形式,部署在大模型智能体与受控外部环境之间,不改动原有 Agent 的推理逻辑与工具业务代码,只在决策与观察的通路上完成记录与恢复。
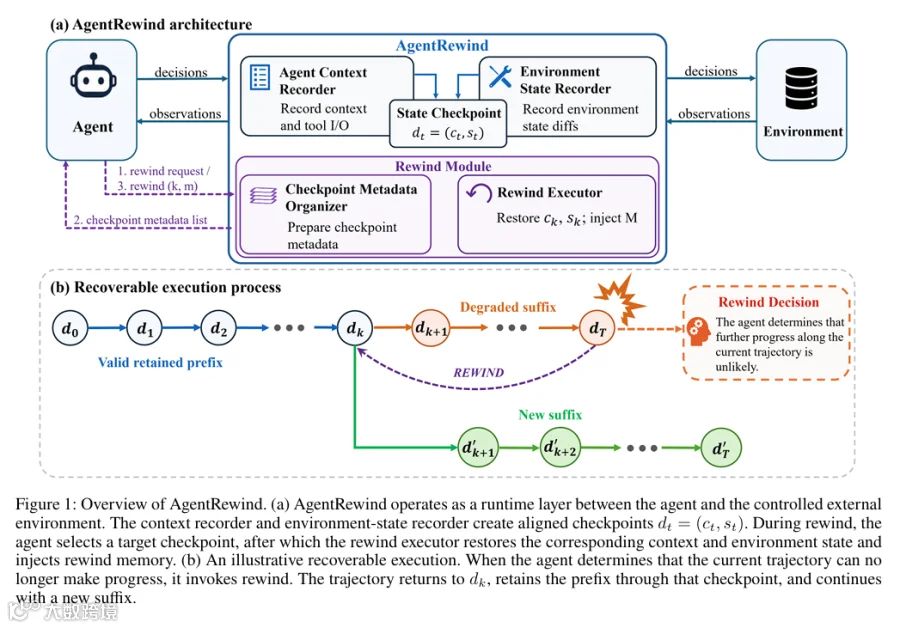
整体由三部分协同工作:
一、对齐检查点记录
二、检查点元数据管理,将历史轨迹整理为可供选择的回退候选;
三、回滚执行,恢复选定检查点上的上下文与环境,并注入回滚记忆后继续执行。
设计上对应三个核心目标。
第一,上下文与环境同步对齐,快照与恢复始终成对进行,避免只回滚一侧造成信息割裂。
第二,按 LLM 决策断点做局部回退,保留断点前已完成的有效工作,无需任务失败后全盘重置、从头再来。
第三,引入回滚记忆,在回到历史干净状态的同时,保留失败轨迹中的经验与教训,降低重复犯错的概率。
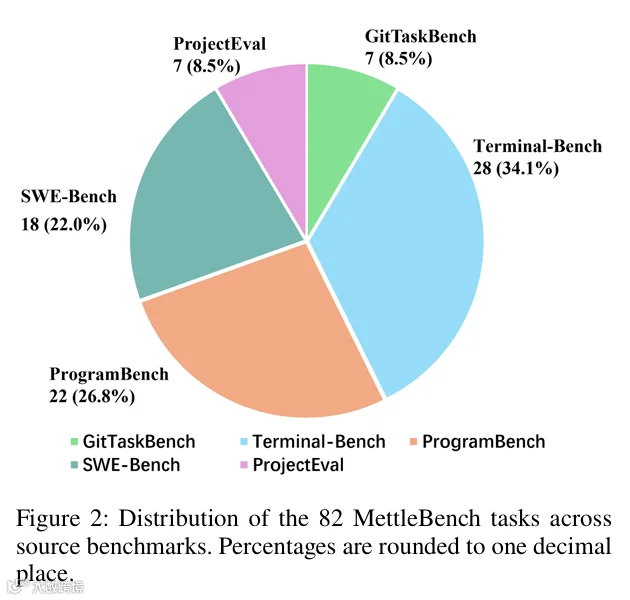
与之配套,本文同步构建长时序工程评测基准 MettleBench。
基准面向真实工程工单,为每项任务设置一组存在依赖关系的有序验收标准,既可判定任务是否最终完成,也可量化中间执行进度,为可恢复执行策略提供更贴近现实场景的评估手段。
02
工程设计
AgentRewind 以非侵入式中间层接入,不改 Agent 核心逻辑,只在两处挂钩采集数据:
第一是LLM 调用,拦截 OpenAI / LiteLLM 补全接口,记录请求、响应与 token 消耗;
第二是工具调用,封装工具执行,记录名称、入参、返回值及文件变更。
兼容 LangChain、LangGraph,可自动埋点。
(1)轨迹存储
轨迹按 JSONL 逐行存储,区分 LLM 事件与工具事件;每条带唯一 ID,并附带执行前后工作区的 Git 提交哈希,便于对齐上下文与文件状态。
工作区快照用任务外的独立裸 Git 仓库完成,不污染业务仓库。
每步 LLM / 工具执行后自动提交;回滚时对比目标快照与当前文件树,删除新增、还原修改、恢复删除。
(2)回滚完整执行流程
回滚时,Agent 先通过 backtrack_candidates 查看可回退的 LLM 断点,再调用 backtrack_commit 提交断点 ID 与失败总结。
Runner 捕获后恢复文件与上下文,注入历次失败记忆,并从断点继续;
断点前的调用一律走本地缓存回放,不重复调模型、不重复跑工具。
(3)能力边界
恢复范围只覆盖工作目录内的文件系统。网络请求、外部服务、进程内状态等无法撤销。
项目另提供轨迹可视化,支持导出Mermaid、JSON与离线HTML,便于对照原始路径与回滚分叉。
03
性能评估
(1)实验配置
实验统一采用 temperature=0.0 的贪心解码(Kimi K2.5 固定为 0.6),连续 5 次提交卡在同一验收标准即终止任务,不设步数与时长上限,以保证策略对比公平。
对比策略包括 Continue、Restart with Experiences、Safety Review(用 AgentDoG 在执行前拦截危险操作)以及本文的 AgentRewind。
主评测使用 MettleBench(82 个任务),并在 Terminal-Bench 2.0 上做泛化验证;
基线模型覆盖 GPT-5.4、GPT-5.4 mini、Qwen3.7-Max、Qwen3.5-27B、Kimi K2.5、DeepSeek-V4-Flash、GLM-5.1,框架通用性在 mini-SWE-agent、FnCallAgent、smolagents CodeAgent 上检验。
消融实验分别去掉环境回退、上下文回退与回滚记忆,以验证各模块作用;
另选取 50 条 Continue 策略下卡死终止的轨迹,从完全相同的失败起点对比 Continue 与 AgentRewind 的恢复能力。
(2)核心结果
在 Continue 基线下,七个模型的任务成功率约在 28.0%–73.2%,无一饱和;
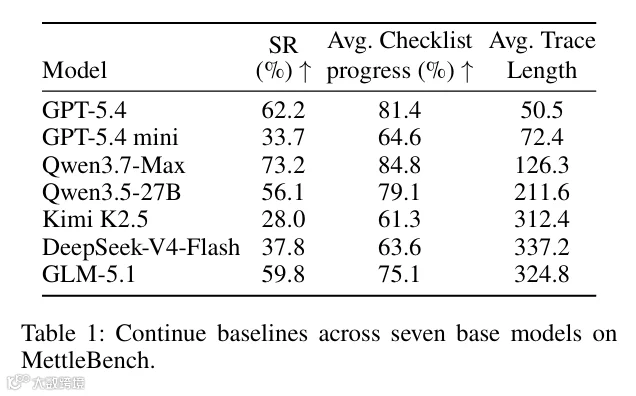
Qwen3.7-Max 最高(成功率 73.2%、清单进度 84.8%),平均轨迹长度从约 50 到 300 余不等,更长并不意味着更好,而清单进度能区分“未完成但走得更远”的程度。

换到执行策略对比,GPT-5.4 上 AgentRewind 将成功率与清单进度提升至 87.8% / 94.3%,明显高于 Continue、Restart with Experiences和 Safety Review;GPT-5.4 mini 上同样是 AgentRewind 最高。
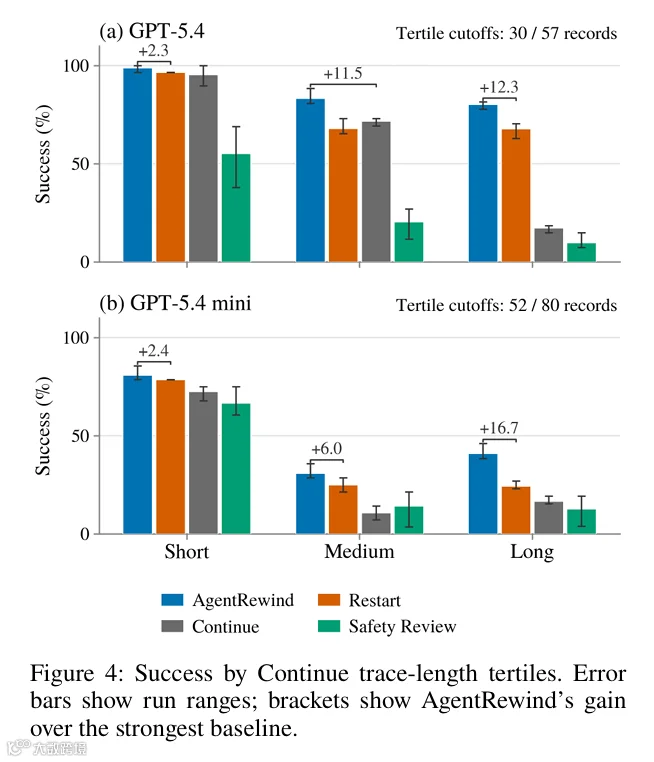
各策略早期都会上升,但 Continue 很快平台、Restart 波动较大、Safety Review 在强模型上甚至更差,而 AgentRewind 在基线平台后仍能继续抬升,且在中长程任务上相对最强基线的增益更明显。

收益不限于 MettleBench:在 Terminal-Bench 2.0 全量上,AgentRewind 的成功率与平均通过标准比例为 83.1% / 90.2%,优于 Continue 与 Restart;
在 mini-SWE-agent、FnCallAgent、CodeAgent 三种 harness 上,相对 Continue 的成功率提升分别约 +25.6、+23.2、+15.8 个百分点,说明主要来自运行时恢复能力本身。

从 50 条 Continue 卡死终点出发的成对恢复中,AgentRewind 的恢复率与进度提升(30.0%、+12.2 pp)也明显高于 Continue(8.0%、+5.1 pp)。

消融进一步表明,环境回退影响最大:后缀造成的文件污染若不回退,恢复很难。上下文不回退会留下错误结论干扰决策;没有 memory 容易重复失败路径。
04
总结
长程 Agent 真正难的,往往不是再多走几步,而是走偏之后回不了头。
AgentRewind 把「上下文 + 环境」对齐成检查点,在同一次执行里支持倒带,并带上失败里有用的记忆,从而少做无效重试、多保住已完成的工作。
开源实现以中间层方式接入,不绑死某一套 Agent 框架;代码与 MettleBench 均已公开。
若你也在做长程工具调用或仓库级工程 Agent,不妨看看这条「可恢复执行」的路子,按需接入、在真实任务里试一把回退。
END
关注+星标,获取AI前沿进展与优质开源项目