

最近,Jev 在 Agent 圈里的热度越来越高。
这个由 TypeSafe AI 推出的模型和 GPT、Claude 这类大语言模型走的并不是同一条路线。传统 LLM 更擅长理解问题、长程推理和生成文本,而 Jev 更强调 System 1 快速决策。
它面对的不是开放式写作任务,而是大量高频、边界明确的判断问题。给定当前状态和一组合法选项,模型直接决定下一步应该选择什么,而不是花时间生成一大段文本。
这种思路很快就被用到了 Browser Agent 上。
Browser-Use 此前开源了 jev-ultrafast,把 TypeSafe 的 Jev API 接入浏览器操作流程。网页被转换成结构化 DOM 状态,再由 Jev 决定下一步操作和目标元素。项目发布后迅速获得大量关注,也让一种新的 Browser Agent 路线开始受到讨论。
现在,这条路线又出现了一个新的开源项目。
APUS-AI-Lab 开源了纯本地 Browser-Use Agent Skill。
该项目基于开源模型(Qwen3.5-9B和Qwen3.5-35B-A3B)复刻 Jev 的“System 1”离散打分思想,通过将可见交互原子映射为 Token 进行单步 Logits 打分,从机制上彻底杜绝选择器幻觉,并封装为开箱即用的 Agent Skill,支持纯本地模型离线执行。
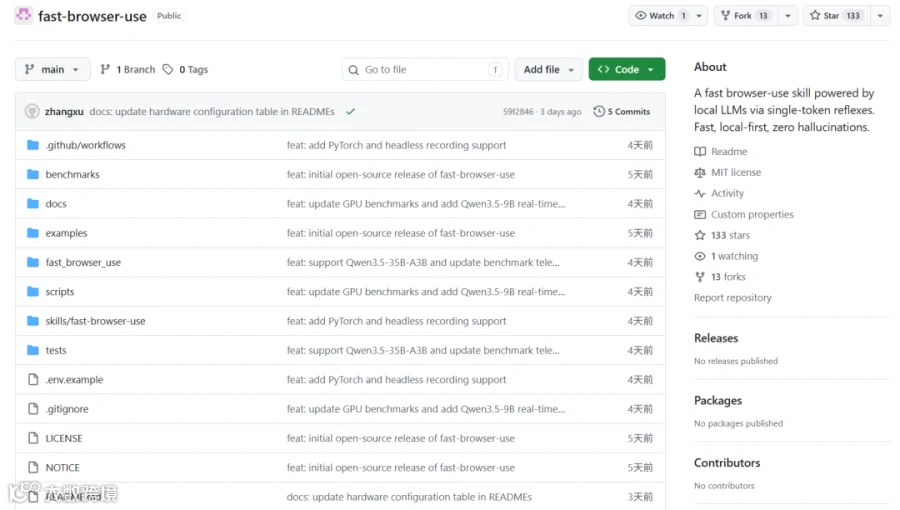
在项目公布的从 Wikipedia 英文首页出发,检索并打开介绍 Python 编程语言的词条,严格校验最终 URL 与页面标题测试中。Qwen3.5-9B 三次耗时分别为 4.055 秒、3.935 秒和 4.067 秒。
01
不让模型写浏览器代码,而是
直接选择下一步动作
Fast Browser Use首先读取已经渲染完成的 DOM,从页面中找到当前真正可见并且能够操作的元素。
按钮、输入框、链接和下拉菜单会被提前整理成一组合法候选动作。
模型看到的不再是一个完全开放的问题,而是一组已经确定存在的选择。
比如点击搜索按钮、向输入框填写内容、选择某个下拉选项或者继续滚动。
模型不再负责创造动作,而只负责从合法动作中选择一个。
因此,它所强调的减少 Selector Hallucination,并不是说模型从此不会判断错误,而是因为 CSS Selector 和 XPath 根本不需要模型生成。
模型无法凭空写出一个不存在的 Selector。
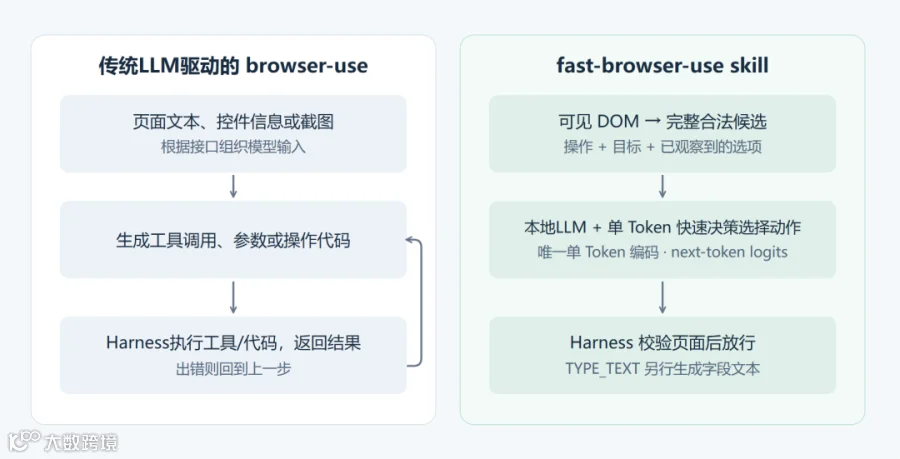
Fast Browser Use 还进一步把一次动作选择压缩到单 Token。
系统会把当前所有合法候选动作映射成 tokenizer 中的单个 Token。
模型完成一次前向传播后,不需要继续自回归生成完整 JSON 或操作代码,而是直接读取下一 Token 的 Logits,在合法候选中比较分数并选择下一步动作。
这就是项目使用的 Single-Token Logits Scoring。
原本需要模型一步步写出来的浏览器操作,被压缩成一次候选动作打分。
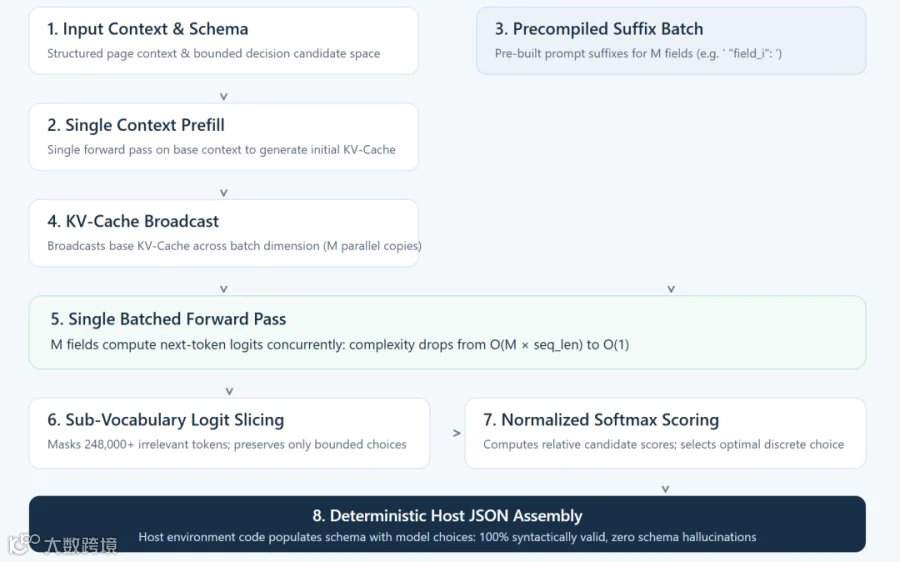
当然,搜索框里真正需要填写的文字还是需要生成。
所以项目把动作选择和文本生成拆开。
点击、下拉选择和滚动等结构化操作直接走离散决策,只有模型真正选择 TYPE_TEXT 时,才使用本地模型生成需要填写的文本。
能选择的地方就直接选,需要写字的时候才真正生成。
02
单Token决策之外,还有一套
Harness负责兜底
浏览器 Agent 的难点不只是模型推理。
模型判断某个按钮可以点击时,这个按钮可能还存在。真正准备执行时,页面已经刷新,DOM 节点也可能被替换。
Fast Browser Use 因此在本地模型之外加入了一套 Harness。
模型开始决策之前,系统会先等待页面进入相对稳定状态。
默认情况下会观察页面变化,避免网页仍在渲染时就立即进行下一次判断。
模型选择动作以后,执行器还会重新检查目标元素。
包括元素是否仍然存在,是否被其他内容遮挡,当前 DOM 是否还是模型做决定时看到的状态,以及目标元素是否真的能够操作。
如果网页已经变化,这次旧决策不会直接继续执行。
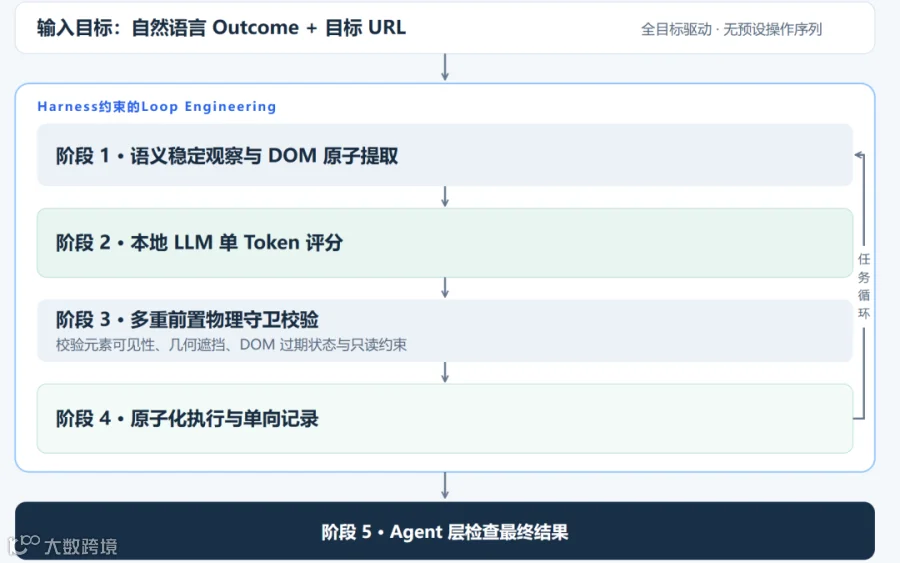
项目对于模型输出的 DONE 同样没有完全相信。
模型认为任务已经完成,只代表一次判断。
实际运行时还可以通过最终 URL、页面标题和网页文字等条件再次验证结果。
例如要求 Agent 打开 Wikipedia 的 Python 编程语言页面,系统最终可以直接核对浏览器是否真的进入了目标页面,而不是只看模型有没有输出完成。
整个流程因此变成了一个更加清晰的分工。
模型负责选择下一步动作,Harness负责检查动作能不能执行,最后再通过独立条件验证结果。
03
Jev范式被搬到本地
Fast Browser Use 不调用 Jev API ,而是使用本地 Qwen3.5 去实现类似的受限决策机制。
项目也支持在 Apple Silicon 上通过 MLX 运行,同时支持 Linux 和 Windows 上的 PyTorch 后端。
当然,它现在仍然属于实验阶段。
当前版本主要处理可见 HTML 和 ARIA 元素的点击、文字输入、原生下拉菜单以及滚动操作,对复杂 iframe、深层 Shadow DOM、Canvas、文件上传和多标签页等场景仍有限制。
END
关注+星标,获取AI前沿进展与开源一线动态