


千问办公为何把企业上下文推向前台?
今年云栖大会现场逛下来,AI超维度分析师有一个很强烈的感受:各种办公Agent展台成了人流最密、关注度最高的地方。
从陪人聊天的Chatbot,到会拆任务替人干活的Agent,再到领了工牌、进组织走流程的企业级Agent,这轮变化从2022年11月底ChatGPT上线算起,还不到四年。弹指一挥间,AI的竞争已经从跑分榜单,延伸到了企业每天真正要完成的工作里。
这次大会安排了100多场分论坛,产品发布一场接一场。回看这些发布,最让我们回味的,是9月22日千问办公的那一场。"掌门人"陈宇森给自己的演讲起了一个非常大胆的标题:Context is All You Need。
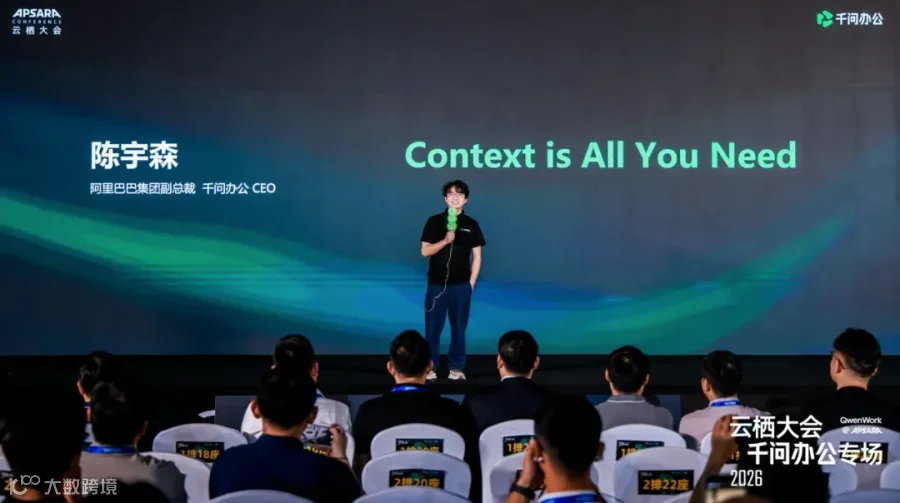
这不禁令人想起九年前那篇奠定现代大语言模型架构基础的论文《Attention is All You Need》。
2017年以前,注意力机制还只是机器翻译模型里的一个辅助角色,帮助模型在生成译文时,找到原文里最相关的词。而主流模型仍依赖循环网络,信息沿着序列逐步传递,训练难以充分并行,远距离信息之间的计算路径也很长。
论文以注意力机制为核心构建Transformer,不再依赖循环或卷积进行序列建模,这既缩短了信息传递路径,也让训练更容易并行。此后,主流大语言模型大多沿着这条路线发展。
九年后,陈宇森把Attention换成Context。实际上,当天千问办公发布了七项产品与功能,从数字员工到协作空间再到安全中心,还有一款AI硬件。但他的演讲标题里唯独强调了Context,为什么?
AI再聪明,也不知道"我们公司"的"我们"是谁
陈宇森在演讲时问了一个问题,如果向AI提问:"我们公司上季度华东区的毛利率是多少?"
"没有一个AI能答得上来。"他说。
模型纵然精通财务,也不会知道"我们公司"是哪一家,"华东区"划了哪几个省,毛利率按哪个口径算。用陈宇森的话说,模型再高的智商,也无法猜出一个没有提供过的事实。
古茗的案例更直观。这家一万多家门店的茶饮企业,芭乐冰奶茶的茶汤放多少毫升、制冰机滤芯多久换一次,网上查不到,AI更是答不上,店员只能问同事、问店长。我们把这样的信息叫作"企业内部知识",每家企业可能都攒了数年乃至数十年之久的"内部知识"。
那么把这些一股脑全塞给AI是不是就大功告成了?陈宇森提到两个关键数字:中大型企业内部的数据平均有150PB,而眼下最强的模型上下文窗口只有100万token。如果一次性把企业数据都塞给AI,窗口将直接打爆;就算塞得下,新旧资料混在一起,AI很可能照着一份过时的数字说得头头是道。
模型能力竞赛打到今天,Agent会干活已经不稀奇了。真正卡住企业Agent的,是它懂不懂一家公司。企业要的是一个知道眼下该用哪份资料、按哪套规矩办事的Agent。
两条路
模型公司的思路,是把Agent做得更聪明再接上工具。今年6月,Anthropic发布Claude Tag,把Claude直接放进Slack:同事在频道里@它,它就调用工具去查系统、翻文件,把事情办了,也在一项项任务里记住这个团队的情况。
这条路能解决不少问题,代价是企业知识得靠Agent自己现找、现拼。华东区划了哪几个省、毛利率按哪个口径算,散在不同系统和文件里,每接一次任务都要重新翻一遍,读进去的每一段都烧Token,翻到的还未必是最新那一版。一家公司用好几个Agent,这笔账单还得重复付钱。
千问办公的解法,是把企业上下文(Enterprise Context)做成一个独立产品。企业先把信息理好,并随业务的变化持续更新,Agent执行任务时,再按需提取相关内容。
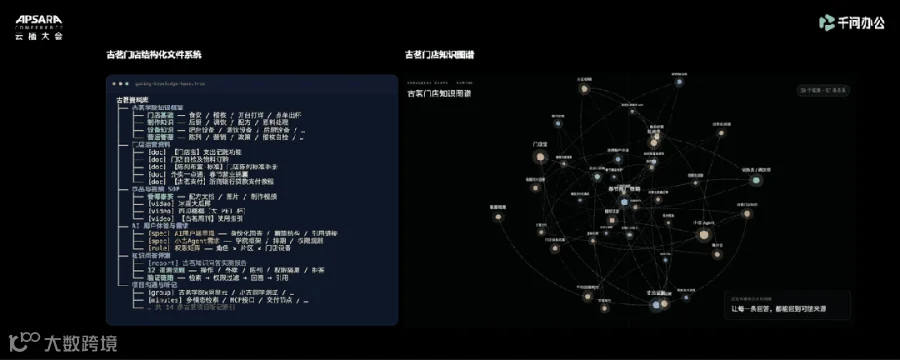
古茗通过 Enterprise Context 对原始资料进行结构化处理
注意,理好的知识是留在企业这一层的——换哪个Agent来干活,都从企业上下文里面取。
把企业上下文做成用得起的基础设施
但企业上下文最难的,是"水面下"那张复杂的关系网。
一个项目走到哪一步,关联了哪些人,都有哪些工作文档、哪些群聊,这些信息是分散各处的。只有连到一起,Agent才判断得出这个项目眼下走到了哪一步。
接入各个系统,只是找到资料的第一步,把资料之间的关系理清楚,才知道它们在企业里意味着什么,而且这些关系可能每天都在发生变化。
"织出"这张网,业内有一套成熟方法,叫本体论(Ontology):把一家公司的客户、订单、设备理成一个个对象,理清它们之间的关系,记下它们眼下的状态,再规定好能对它们做哪些操作,让机器既看得懂,也用得上。
陈宇森提到的Palantir就是靠这套方法行走江湖。但它有个问题:成本非常高。因为大量信息根本不在系统里,一次特批,可能只是群里的一句"老板同意了,按上次的价格走",过去的软件哪里知道它指的是哪位客户、哪份报价,这种只能靠人一条条整理,自然贵。
但重型数字化工程的成本,不是绝大多数企业承受得起的。
千问办公的做法是连接加压缩:实体关系用图数据库连起来,信息按文件系统层层组织、逐层压缩,Agent工作时先读取与任务相关的信息,少读无关内容,需要时再逐级展开。这种做法在技术上叫渐进式暴露。
这些整理和压缩,由企业上下文内置的一个专属模型来完成。官方称用很低的Token成本就能做到。
只有整理和更新"隐性知识"足够便宜,使用也无需每次都付出高昂的推理成本,企业上下文才有机会从一项重型数字化工程,变成一套每天都用得起的基础设施。
企业开门做生意,家家都有一本账。如果用AI省下的工夫,还抵不过整理数据、维护知识的投入,这笔账就算不过来。但如果把企业上下文做成了基础设施,一旦跑起来,就可以长在企业的业务里了。很显然,陈宇森押注的是这个。
这很难,但千问办公手里有一张别人难以复制的牌。
钉钉。
8月千问办公上线时,AI超维度在评论里写过:"个人变快,不代表企业变快",把许多个人的上下文放在一起,也不会自动得到企业上下文。
一家公司最难理清的关系,往往是谁向谁汇报、谁能批多少,这些很少写在文档里,却天天在企业的审批流里跑。钉钉服务着2700万余家企业组织,承载着大量企业的文档、沟通和审批记录,记录着每家企业如何运转。
过去因为这些,钉钉常被嫌"重",但现在看来,这些年累积下来的组织、身份、审批等工作流,正好是构建企业上下文的宝贵"原料"。
中国企业软件被嫌弃多年的"重",到了Agent时代,成了一座富矿。
但知道越多,责任也越大。做网络安全出身的陈宇森,把"信得过"放在与"懂业务、能协同"并列的位置。Agent能访问什么、能执行什么,要先划清边界,高风险操作要审批,事后还得有记录可查。在他看来,让企业放心交出内部知识,安全得从架构设计之初就做进去。
九年前,《Attention Is All You Need》把注意力机制从配角变成主角,让模型更有效地处理信息之间的关系。今天,陈宇森借这个标题,把目光投向Agent进入企业组织之后。
他相信,模型和Agent随时能换,但一家公司对自己的理解替换不走,掌握企业上下文(AI资产)才是最重要的。
"你不需要用一个最强的大模型,只需要一个性价比非常合适的大模型,就能解决企业里面各种各样的办公问题。"陈宇森说。
生意难做,有时候是因为,企业自己都说不清自己。
过去二十多年,阿里使命一直是那句"让天下没有难做的生意",或许未来,千问办公的使命可以说:"让天下没有AI不懂的企业"。
-END-
获取更多AI非共识!