


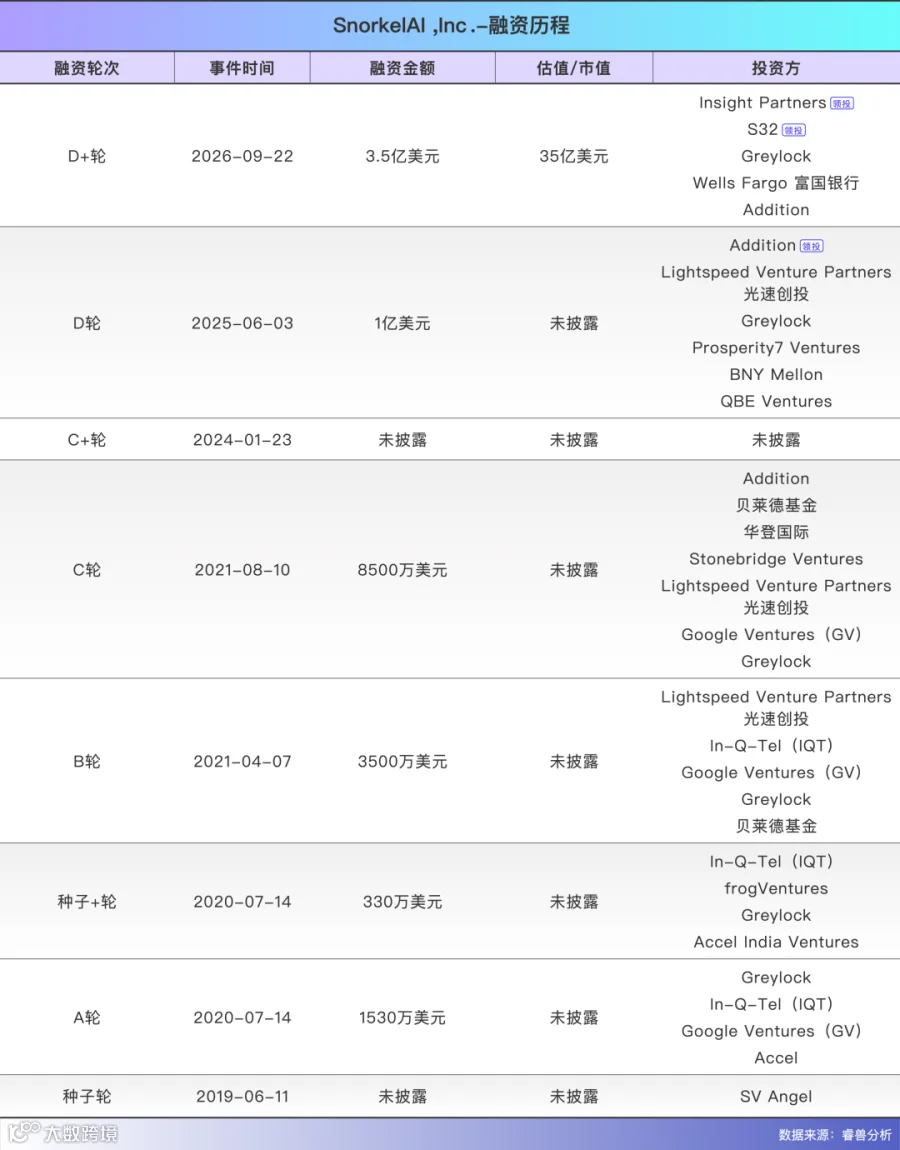
AI训练数据赛道再现大额融资。9月22日,AI数据服务商Snorkel AI宣布完成3.5亿美元E轮融资,投后估值达35亿美元(约合235亿元人民币),由Insight Partners和S32领投。这距离其2025年5月完成的1亿美元D轮融资(估值13亿美元)仅过去17个月,估值翻近3倍。
资本狂飙的背后是陡峭的收入曲线。Snorkel AI目前年化收入已达3.75亿美元,较一年前的2000万美元暴增约18倍,并预计今年实现盈利。一家不造大模型、不产芯片的公司,凭何在AI基础设施赛道跑出如此增速?
从斯坦福实验室走出的“数据编程”先驱
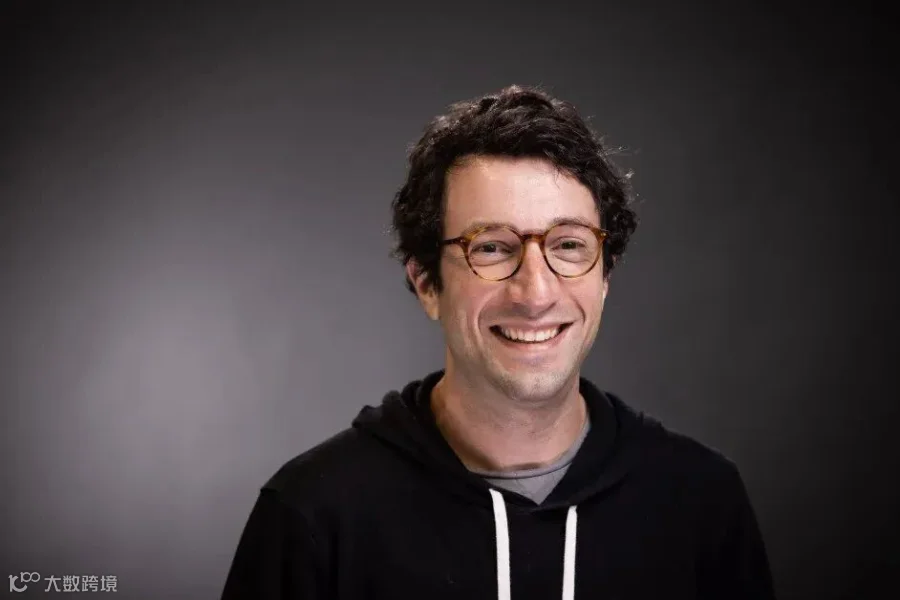
Snorkel AI的故事源于斯坦福AI实验室。联合创始人兼CEO Alex Ratner在攻读博士期间,致力于解决机器学习中的数据瓶颈。当时,模型训练高度依赖专家逐条人工标注,耗费巨大。

颠覆传统人工标注
2017年,Ratner等人提出“数据编程”(Data Programming)方法:专家不再直接贴标签,而是编写判断规则,由系统批量生成训练标签并处理冲突。例如在医学影像场景中,医生只需定义疾病特征标准,系统即可处理海量数据。这套方法随后在Google、Intel、Apple等机构得到应用。
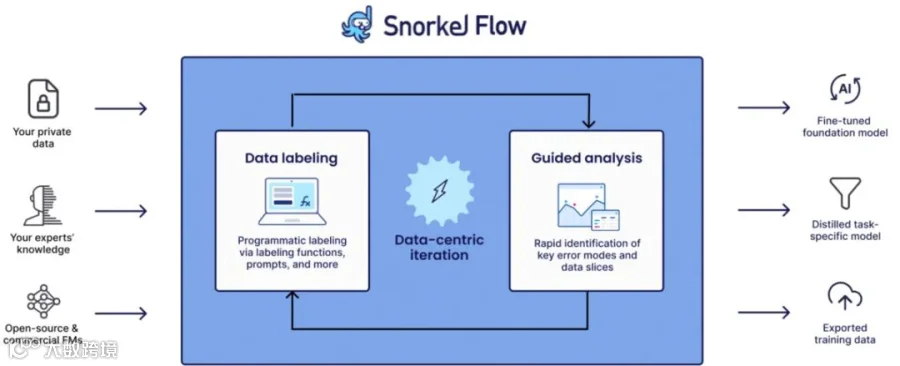
2019年,Ratner带领团队正式创业。2020年推出核心商业产品Snorkel Flow,本质是一家数据基础设施软件公司,通过自动化流程,以更少的专家处理更大规模的数据。然而,随着大模型进入后训练阶段,模型不仅需要“标准答案”,更需要专业人士解释逻辑,Snorkel随之开始业务转型。
从“卖工具”到“卖数据”,年收入暴增18倍的秘诀
向模型评测与专家数据延伸
2025年5月,Snorkel AI完成1亿美元D轮融资。同期案例显示,其帮助某大型美国银行构建AI系统,使贷款问题准确率从25%提升至93%;AI销售公司Rox使用后,模型准确率提升10%至12%。此时,Snorkel已深度参与定义模型学习内容。

2025年9月,Snorkel AI推出Data-as-a-Service服务,结合专家网络与AI模型,直接向客户交付成品训练数据、评测数据和强化学习环境,完成从“卖工具”到“卖数据”的转身。
“专家+AI”重塑数据生产线
Snorkel拥有数万名涵盖编程、法律、医疗等领域的专家。他们负责定义任务和标准,而繁重的数据生成与初筛交由AI Agent完成。在编程数据生产中,单个任务最多调用数百个专用模型交叉检查,使质检效率提升50%以上,准确率提升超15个百分点。
这种“专家定义标准,AI规模执行”的模式,形成了数据开发的“递归自我改进”循环:AI提升数据生产效率,专家的反馈又持续优化AI系统,推动公司收入快速攀升。
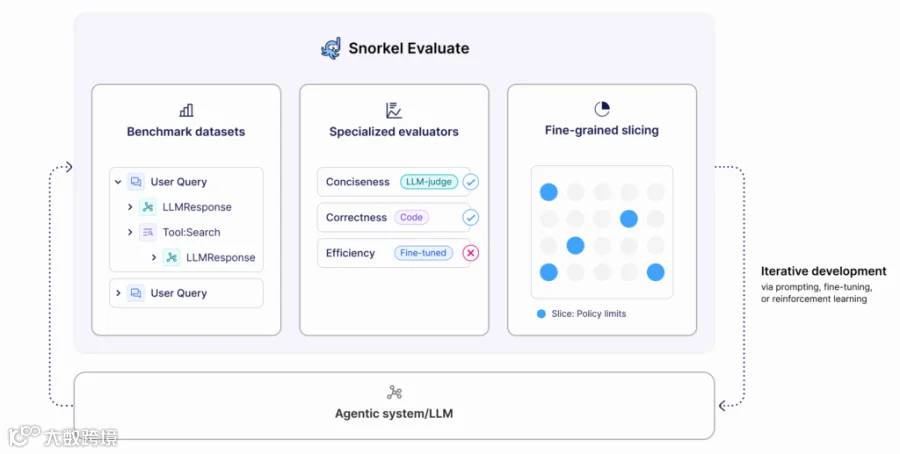
发力Agent强化学习环境
针对Agent时代对数据的新需求,Snorkel开始提供模拟真实工作流程的强化学习环境。以代码Agent为例,系统可模拟代码库操作,记录状态变化并验证结果;在保险领域,则联合专家搭建模拟承保环境,让Agent在真实业务流中接受评估。

AI数据赛道分化,竞争向高价值环节转移
海外巨头路线各异
在AI数据赛道,Scale AI、Mercor与Snorkel AI呈现出不同的商业化路径:
Scale AI主打规模,从数据标注切入,现已扩展至数据采集、RLHF及模型评测。2025年6月获Meta 143亿美元投资,估值约290亿美元。

Mercor侧重专家网络,汇聚各领域专业人士,为AI公司提供模型训练与人工反馈。

Snorkel AI致力于专家知识产品化,结合软件、专家网络与AI模型,交付完整数据基础设施。随着业务深水区拓展,三家边界正逐渐重合。
国内企业的差异化探索
国内AI数据赛道同样呈现分化:海天瑞声、数据堂等传统厂商延续数据采集与标注的规模优势,向大模型评测延伸;手亿、星忆、真觉万象等则切入Physical AI(物理AI)数据采集,通过穿戴设备获取真实世界交互数据,解决机器学习的真实世界数据来源问题。
当前,AI数据产业已形成清晰分层。行业竞争焦点已从“谁能生产更多数据”转向“谁能控制数据生产链条的高价值环节”。对Snorkel AI而言,其押注的正是将专家知识通过软件和AI规模化,转化为持续交付的数据基础设施。未来的下一站,属于那些能为AI产出更优质任务与更真实训练环境的企业。
