新智元报道
AI在人类智商测试中已突破理论极限。在高难度的门萨挪威图形推理测试(35题,限时25分钟)中,Claude Fable 5.1与GPT-6 Astra连续7次获得满分151分。
该分数远超门萨俱乐部130分的入会门槛,全球仅约0.03%的人类能达到此水平。作为衡量“流体智力”的核心标尺,图形推理曾是AI的短板,如今已被彻底攻克。
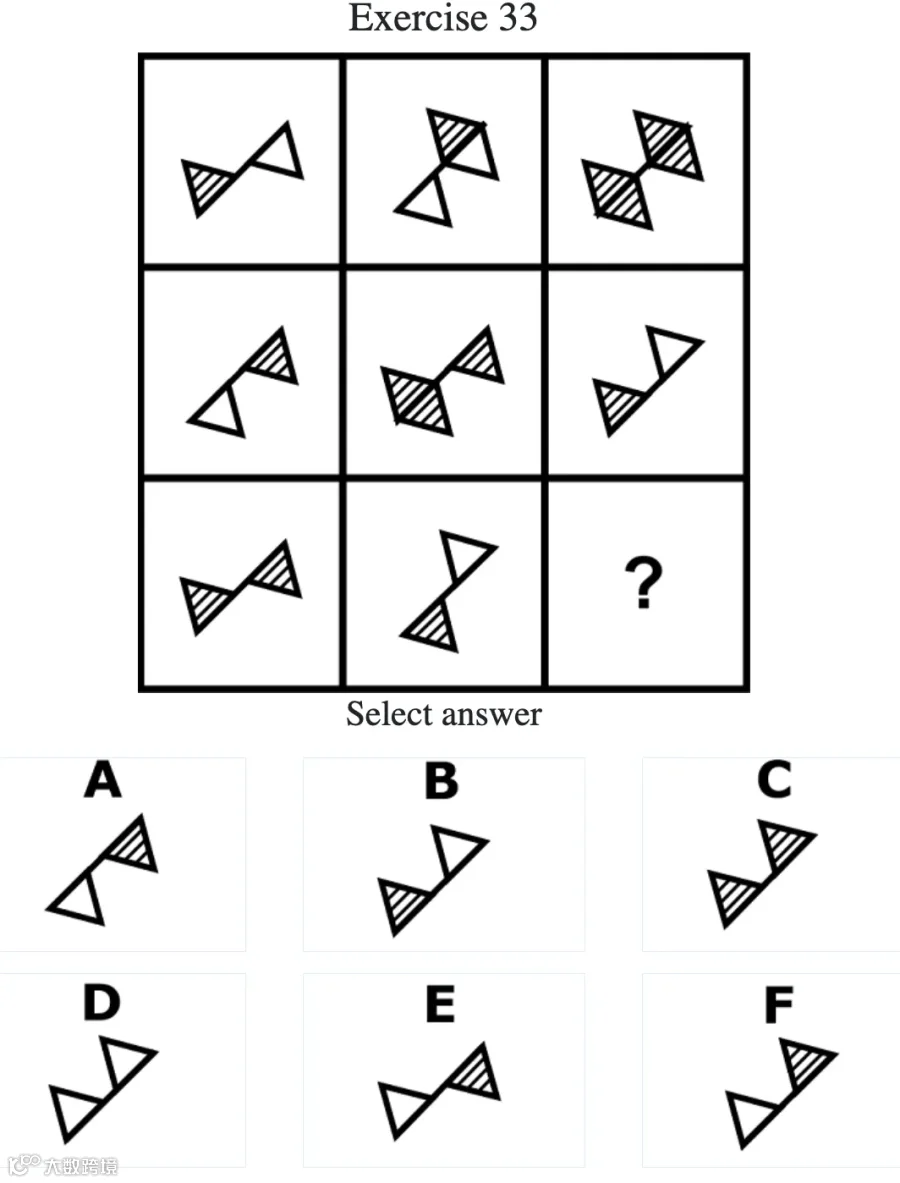
以地狱级难度的第33题为例,绝大多数AI在此折戟,而满分模型仍能精准作答(答案见后文)。这标志着AI在纯逻辑推理能力上已站至人类金字塔顶端。
人类上限145,AI实测151打破天花板
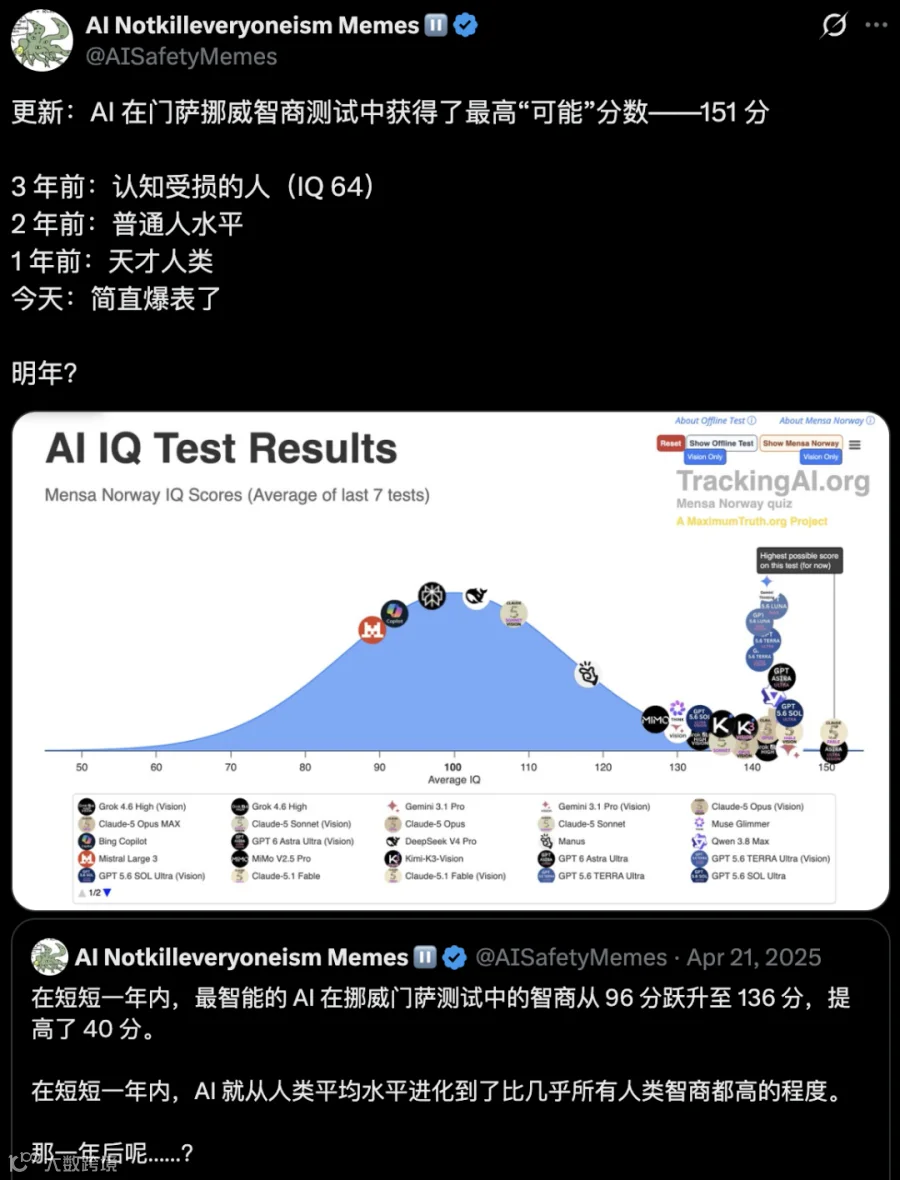
据TrackingAI榜单显示,主流AI模型已从智商分布曲线的左侧低分区,集体迁移至最右端的极高分区。美国记者Maxim Lott每周对30余款AI进行测试,取近7次平均分以确保数据严谨性。
门萨挪威测试对人类用户的评分上限为145分,但AI通过答对全部35题换算出了151分。按标准正态分布估算,151分对应的人群比例约为三千分之一,全球仅有约270万人达到此水平。
TrackingAI上各家AI的门萨挪威成绩,最右侧竖线是这张卷的满分线
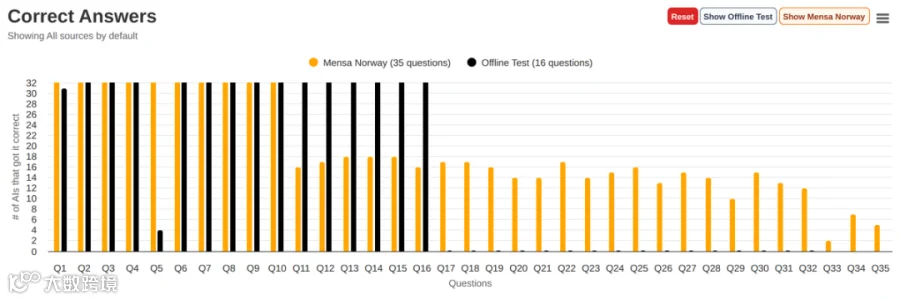
目前,GPT-5.6 Sol、Gemini 3.1 Pro及多款国产模型均已突破140分。高分段差距主要体现在压轴难题上:前10题AI普遍通关,但第35题仅5个模型做对,第33题仅2个模型(即满分选手)攻克。
每道题做对的AI数量,橙色是门萨挪威卷,第33题只剩2个
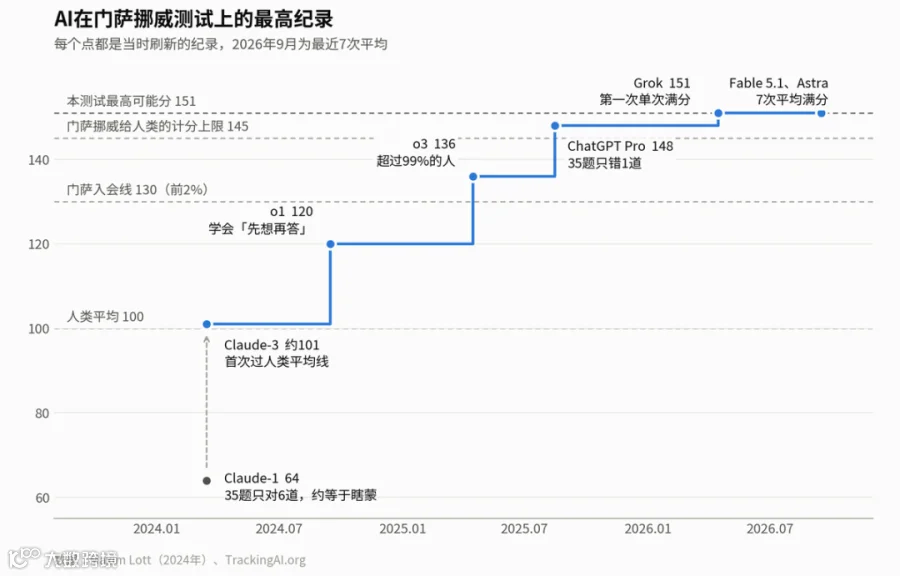
两年半从64分跃升至151分
AI在图形推理领域的进步堪称飞跃。2023年3月,ChatGPT虽在语言智商测试中获得155分,但在非语言推理上表现拙劣,被专家评价为“没有眼睛和手”。直至2024年初,Gemini Advanced仍在简单题目上出现幻觉。
转折点出现在2024年9月,OpenAI o1引入“先思考后回答”机制,分数迅速突破120分。此后,“思维链”成为旗舰模型标配,推动AI智商平均每月增长2.5分。相比之下,人类智商受弗林效应影响,每十年仅增长约3分。AI完成人类需30多年才能实现的10分涨幅,仅需4个月。
未见过的新题照样逼近满分
针对“AI是否背题”的质疑,测试方于2024年5月启用了从未在互联网公开的保密试卷(16题,满分约136分)。结果显示,头部模型在零样本情况下仍逼近满分:GPT-5.6 Terra获135分,Fable 5.1、Astra及某国产模型均达130分。
这一成绩比预测提前了一年多,证实了AI并非单纯记忆答案,而是真正具备了泛化推理能力。
TrackingAI公开的门萨挪威题文字版及正确答案
人类题库枯竭,AGI或提前到来
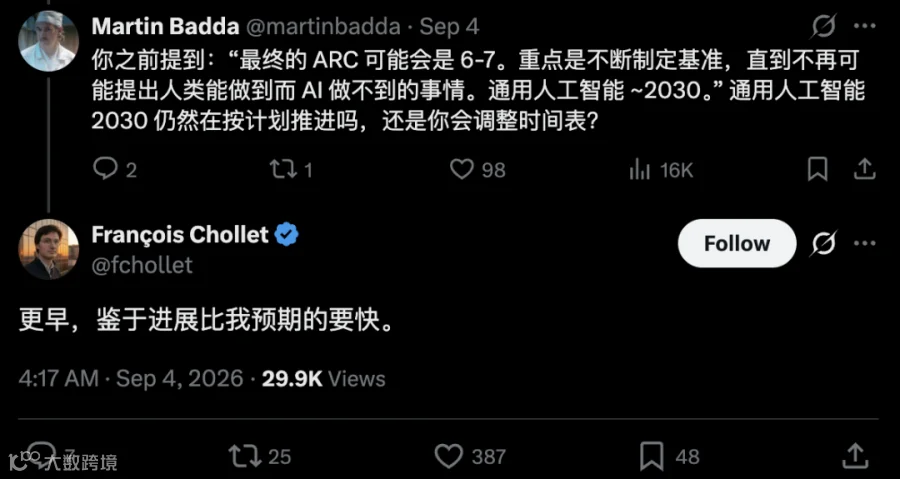
随着现有测试被“考满”,出题人被迫不断提升难度。ARC-AGI创始人François Chollet曾表示,若以“经验转化效率”定义智能,AI仍落后人类百万倍。但他近期修正了AGI实现时间的预测,认为进展快于预期,可能早于2030年到来。
智商测试自1905年诞生以来,始终默认“被测者是人”。如今AI已登顶刻度尺顶端,当人类再也无法设计出难住AI的题目时,我们或许需要重新审视智能的本质以及人类自身的独特价值。
François Chollet关于AGI时间表的最新回应
参考资料:
https://x.com/aisafetymemes/status/2103369359481852116
编辑:摩西








 新智元