


Claude Code团队成员Thariq近日发表文章《Using Claude Code: Spending your effort》,深度解析了“effort”参数的核心机制及适用场景。该参数本质上并非用于修正错误逻辑,而是分配模型的算力预算,以应对隐藏边界条件和自我验证。值得注意的是,调节effort档位不会破坏提示词缓存。Thariq基于Opus 5.5和Fable 5.1模型,在标准测试集与日常开发中进行了全面对比复盘。
effort的本质是计算量预算
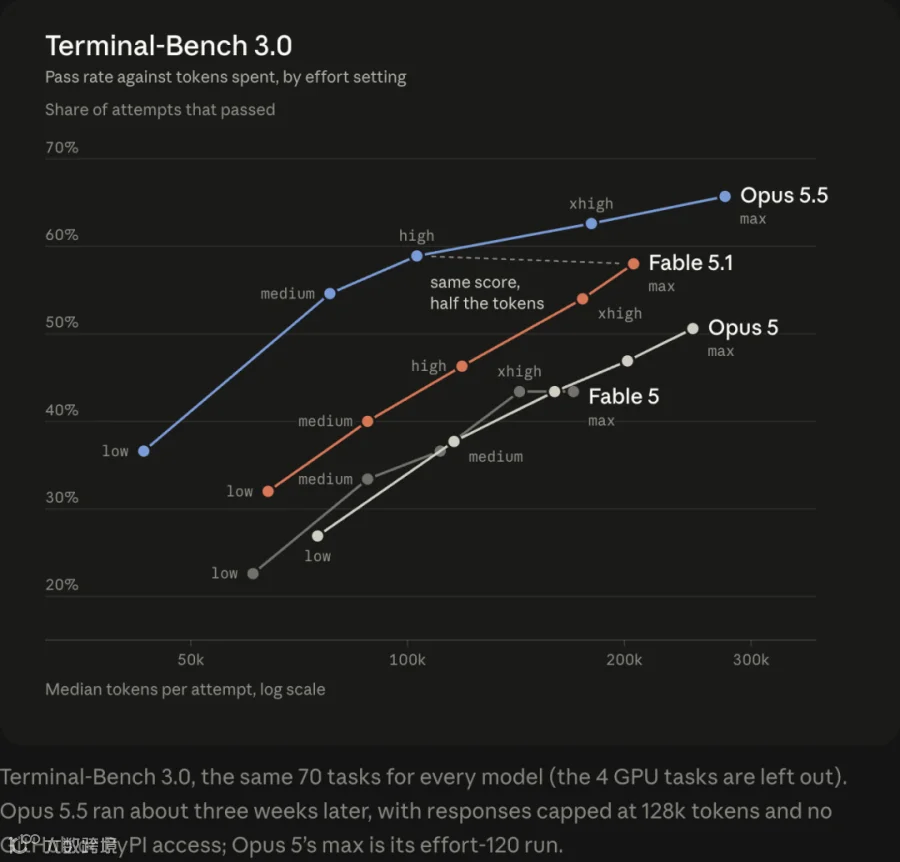
effort决定了模型在特定任务上投入的计算资源。低effort下,模型快速生成基础实现,留待人工调整;高effort下,模型会自主进行边界测试、独立判断甚至源码反查。Terminal-Bench 3.0基准测试表明,随着effort提升,Token消耗中位数增加,测试得分同步大幅上涨。
日常任务中的实际表现差异
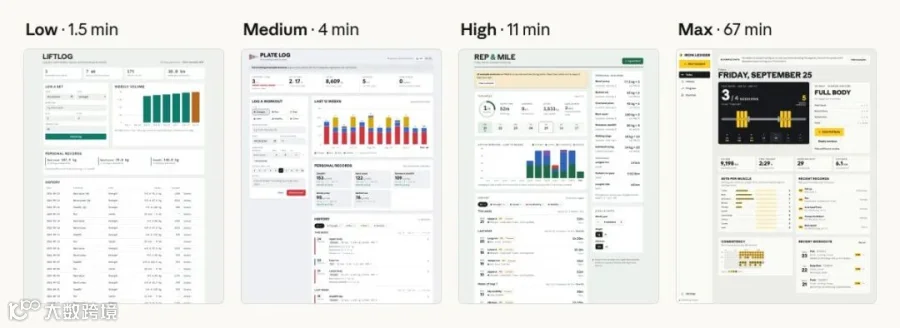
Thariq使用Opus 5.5测试了三类任务,展现了不同effort的实际区别:
1. 极简需求(如开发健身记录应用):低effort仅提供基础日志与图表;最高effort则自主完成产品决策,增加热力图等丰富界面。
2. 轻度明确设计(如重设计config菜单):低effort耗时1分钟输出交互草图但风格偏离;最高effort耗时28分钟输出符合原风格的高保真原型及多流程演练。
3. 高度明确开发(基于详细规格书):各档位输出架构与外观基本一致,高档位仅精简部分细节。
结论:紧密参与迭代选低effort;期望一次性成熟方案选高effort。推荐高效循环:低effort挖掘需求 -> 低effort生成初版 -> 低effort快速迭代 -> 高effort全局验证。
复杂任务中高effort的核心价值
在Terminal-Bench 3.0等涵盖硬件、安全、科学等领域的真实工程难题中,高effort的核心价值在于消灭隐藏边界问题。以HTML-JS-Filter任务为例,低effort通过率为20%(单次编写简单测试),最高effort达100%(耗时33分钟,进行对抗性自审、源码排查及模糊测试)。
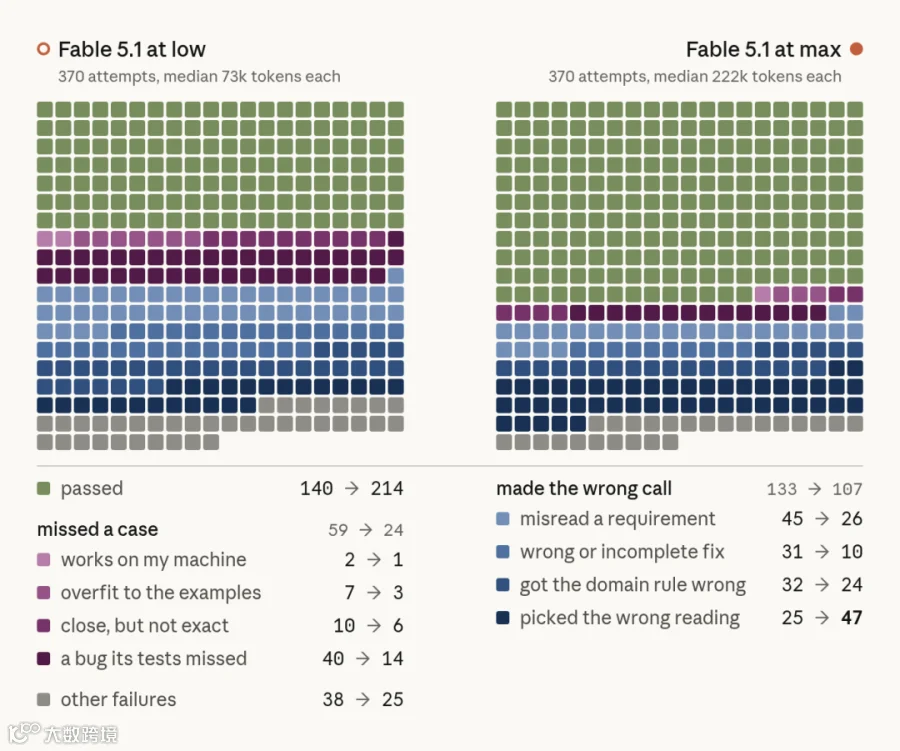
数据分析表明:提升effort能大幅减少遗漏边界条件导致的失败,但无法挽救初始思路完全跑偏的问题。最高effort下,因测试遗漏和修复错误导致的失败显著降低,但“选错需求理解”的失败率反而上升。
高算力投入的领域收益差异
不同工程领域从最高effort中获得的通过率提升差异显著:硬件(34%至75%)、网络安全(64%至87%)、机器学习(54%至73%)、科学计算(41%至61%)、常规软件开发(43%至56%)、多媒体处理(18%至30%)、运维(12%至22%)。硬件与安全等低容错率领域收益最为惊人。
具体用例如存储引擎崩溃修复、线性规划求解器及蛋白质组学富集分析,高effort均通过复现崩溃、暴力校验或对比数据预处理等深度思考,将通过率从0大幅提升。

Claude Code effort档位选择指南
基于上述规律,日常使用Claude Code的档位选择建议如下:
低档位:适合头脑风暴、原型草图及明确的小改动等需人类高频参与的场景。
中档位:适合实现定义清晰的新功能等常规软件开发。
高档位:适合老旧代码库排查疑难Bug等极度看重验证和边界条件复杂的任务。
最高档位:适合端到端开发复杂应用、深挖关键生产代码安全漏洞等极端复杂问题。
注:用户可通过输入/effort指令,在对话中途灵活切换思考深度。
参考来源:Claude官方博客