

会写代码已经不够了,懂你的系统才是企业 AI Coding 真正的分水岭。
前段时间有个朋友提到一个典型案例:业扩预受理增加一个校验,AI 很快写出了代码,能编译、测试也能跑,但架构师一看,改错地方了。
这种情况在大型存量系统里几乎是常态。给 AI 一个全新项目,它往往表现不错;但把它扔进一个跑了十几年、几十万甚至上亿行代码的企业系统,情况就不同了。它不知道页面是否为业务入口、接口属于哪个服务、能否跨中心调用、字段来自哪张表、规则是全国通用还是仅限某省。
模型越来越会写代码,但依然不一定懂你的系统。这也是为什么 Context Engineering 正在从 AI 圈的新词,变成企业 AI Coding 必须解决的工程问题。
本文看点
01
Context 五层拆解
02
Discover→Harvest 闭环
03
从 Context 到 Harness
01 存量系统里,瓶颈到底在哪
普通互联网项目用 AI 写代码很简单:需求输入、Prompt 生成、AI 编写并测试。因为项目无历史包袱,技术栈公开,架构简单。但大型企业系统截然不同。以电力营销系统为例,一个普通需求往往牵涉五类知识:
业务规则
如扩报装、更名过户等流程规则,且不同省市口径可能各异。
架构边界
多中心微服务中,业务服务与平台服务的调用关系及跨中心限制是硬约束。
数据知识
庞大的数据模型中,字段口径与枚举含义难以凭空猜测。
私有技术栈
内部自研框架、工单引擎等外部无法查阅的技术,模型无从预习。
存量代码
海量代码本身即为最真实的系统知识。
当代码规模达千万甚至上亿行,AI 的最大困难已非编写代码,而是从海量代码中精准定位相关部分。
「企业 AI Coding 的核心,不是 AI 能否写代码,而是能否从业务问题精准定位到代码落点。」
02 缺的不是 Prompt,是 Context
发现 AI 编写不准,多数团队会试图把 Prompt 写得更长、更细,最终将其变成“小说”,但问题依旧。原因在于:Prompt 解决“如何告诉 AI 做什么”,而 Context Engineering 解决“AI 工作时应该知道什么”。
我们习惯将企业 AI Coding 中的 Context 拆解为五层:

1. 指令上下文:编码规范等约束条件。
2. 工具上下文:Git、数据库查询、MCP 等工具能力及其 Schema 和权限。
3. 技能上下文:开发 SOP,规定需求分析、方案设计与代码 Review 流程。
4. 项目知识上下文:业务规则、系统架构、数据模型、API 契约及私有技术栈,这是大型企业最欠缺的一环。
5. 运行时上下文:当前需求、对话历史及已验证的证据。
「真正的 Context 并非单一文件,而是一整套工作环境。」
03 别把 Context Engineering 做成写 Markdown
许多团队误以为建目录、疯狂编写 Markdown 文档就是 Context Engineering,这仅是将企业 Wiki 搬给 AI,并未解决根本问题。
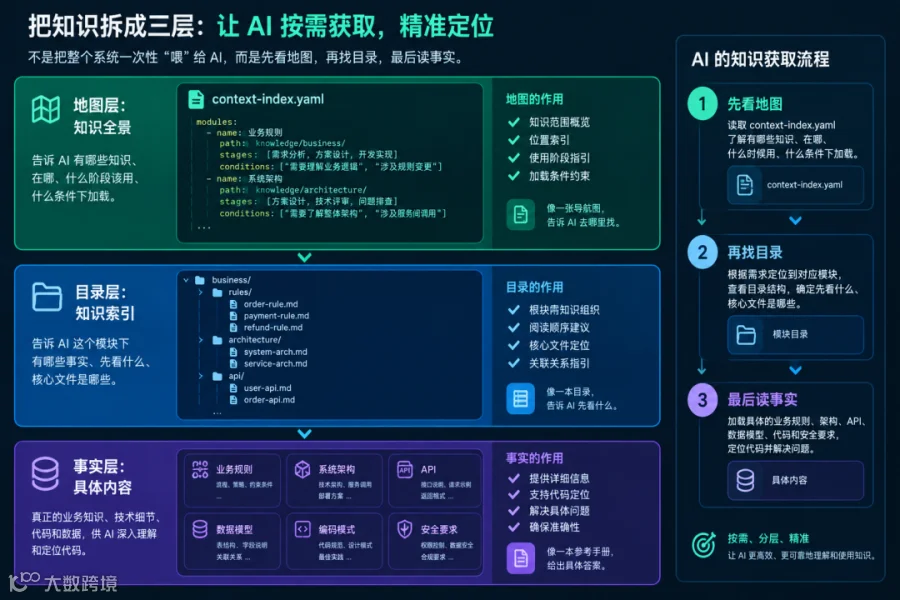
Context Engineering 的核心是让正确的信息在正确的时间、以正确的粒度进入模型。将大量规则塞进单一文件会导致上下文臃肿且难以维护。更好的做法是给 Agent 一张“地图”,而不是一本千页说明书。
实践中,可将知识拆分为三层:
1. 地图:如 context-index.yaml,指引知识位置与加载条件,不解释具体知识。
2. 目录:说明模块内的事实、核心文件及阅读顺序。
3. 事实:业务规则、系统架构、API 等底层具体内容。
AI 拿到需求后先看地图,再查目录,最后读取事实并定位代码,避免一次性吞噬整个系统。
「Context 设计的目标不是提供更多信息,而是让 AI 更快找到所需部分。」
04 企业 Context 目录该怎么搭
无需一开始就构建“企业级 AI 知识中台”,朴素的目录结构即可:
踩坑提示:通用知识与单次需求产生的临时知识必须分开存放,避免规则混淆,导致 Context 混乱。
05 不要指望一次性把系统整理完
许多企业试图先成立专项组,花数月整理全系统知识,交付厚重的“AI 知识库”,但实际开发时 AI 仍找不到代码。脱离真实需求整理的知识,易出现抽象层次不一、信息过期、临时规则误作通用规则等问题,反而增加人工纠错成本。
「更可靠的方式是让 Context 随真实需求自然生长,而非先建百科全书。」
06 一套实用的机制:Discover → Update → Harvest → Review
此流程可转化为团队日常 AI Coding 工作方式,使 Context 在开发中自然沉淀。
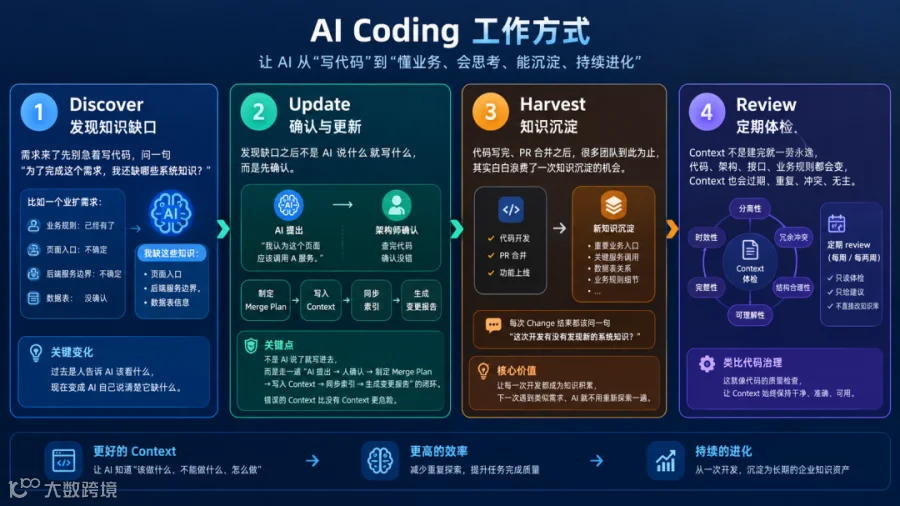
Discover(发现):需求输入后,先让 AI 明确“还缺哪些系统知识”,列出知识缺口。从“人告诉 AI 看什么”转变为“AI 自己说缺什么”。
Update(更新):AI 提出假设后需人工确认。走通“AI 提出 → 人确认 → 写入 Context”的闭环。错误的 Context 比没有更危险。
Harvest(收获):每次代码合并后,进行知识回流,沉淀新发现的系统知识,避免 AI 重复探索。
Review(复盘):定期体检 Context,检查分离性、冗余冲突、时效性等,提供修改建议但不直接改动知识库。
07 比“Context 太少”更危险的:Context 是错的
AI 极易自信地相信错误信息,因此需对 Context 设定证据等级:
A 级(直接证据):源码、配置、API 查询结果,作为事实基线。
B 级(间接证据):文件名、目录结构、注释,需交叉验证。
C/D 级(未经验证):命名推断等,仅作假设,不入事实层。
X 级(绝对禁入):密钥、账号、生产地址等敏感信息,严禁进入 Context。
此外,需区分 Current State(当前状态)与 Target State(目标状态),避免 AI 将目标方案误认为现状。需求、Spec、Design、Code 之间须有清晰的状态边界。
08 AI 擅长整理和执行,但事实裁决还得靠人
企业需保留 Human-in-the-Loop。AI 可高效扫描代码、生成 Context,但不适合独立判断业务事实或高风险改动。Checklist 全绿不等于事实正确,人工抽查仍能发现语义丢失。合理分工是 AI 扩大检查覆盖面,人负责最终事实裁决。
同时,不要为“好读”过度压缩 Context,以免丢失分支条件、异步关系等关键信息。
「Context 工程追求最小必要 Context,而非最短 Context——提炼不等于精简。」
09 从 Context Engineering 到 Harness Engineering
解决“AI 知道什么”后,还需解决“AI 能做什么、做错了怎么办”,即从 Context Engineering 走向 Harness Engineering。
Context → Skills → Tools → Workflow → Guardrails → Evaluation
Harness Engineering 旨在设计让 Agent 可靠工作的工程环境。
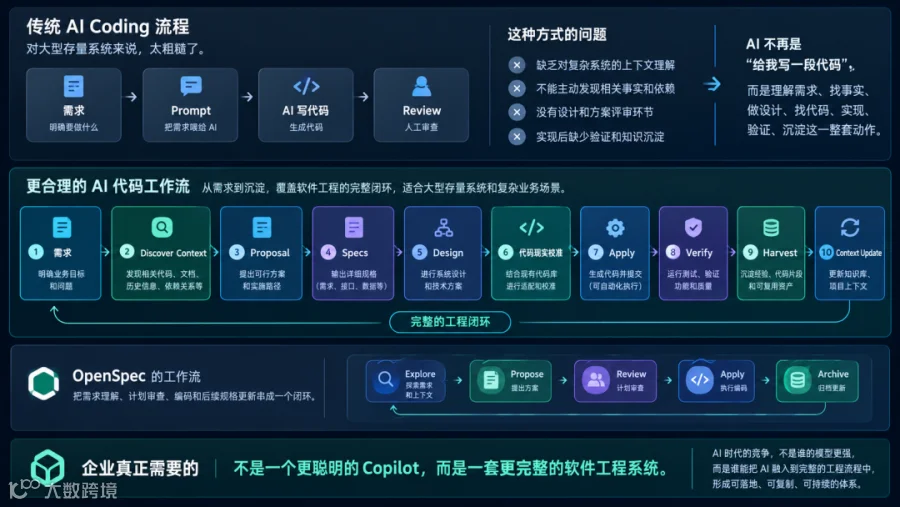
更合理的 AI-SDD 链路为:
需求 → Discover Context → Proposal → Specs → Design → 代码现实校准
→ Apply → Verify → Harvest → Context Update
「企业真正需要的不是一个更聪明的 Copilot,而是一套更完整的软件工程系统。」
10 明天就想开始,应该怎么落地
STEP 01 挑一个真实需求当起点
选择业务真实、即将开发、有明确验收标准的复杂需求。
STEP 02 先做 Context Discover,再补 Context
让 AI 明确涉及的业务规则、系统及知识缺口,初步补充核心事实,够用即可。
STEP 03 先出设计,架构师确认再开始 Coding
确认需求理解、方案及调用关系后,让 AI 在准确的 Context 下编写代码。
STEP 04 验证要过代码、功能、架构、事实四层
确保编译通过、需求实现、未越界,且 Context 与实际代码保持一致。
STEP 05 Harvest 新知识,回流成通用 Context
将单次开发产生的新知识沉淀为通用 Context,为后续开发提供养料,实现“一次开发,持续受益”。
写在最后
进入大型企业后,常被忽略的变量是:你的系统是否为 AI 可理解与工作的环境。若架构知识仅存于人脑,业务规则散落各处,即使使用最强模型,AI 也难以稳定工作。反之,若业务、架构、数据等知识成为 AI 可读取、验证的工程资产,模型能力的提升将惠及整个团队。
未来成熟的 AI Coding 团队,将是“懂业务与架构的人 + AI 可理解的工程环境 + Agent 集群 + 验证治理机制”的组合。
「AI Coding 的终点,不是让 AI 替你写代码,而是让 AI 真正成为系统里的工程师。」
END