


2026年9月20日,阿里通义千问正式开源 Qwen-Image 2.1,这是一款融合“文生图”与“图像编辑”功能的综合性模型。其核心优势在于支持全本地化运行,用户无需将提示词、参考图或生成结果上传至云端服务器,彻底解决数据隐私顾虑。
本文记录了在 RTX 3060(12GB 显存)设备上部署该模型的完整实操过程,并以“济南把子肉十二道工序”为主题生成了一组配图。针对部署过程中易导致“安装成功却无法使用”的两个隐蔽故障,本文提供了详尽的排查与解决方案。

一、模型解析:Qwen-Image 2.1 核心特性
根据官方说明,Qwen-Image 2.1 的视觉生成部分参数规模为 7B,由 32 层 Single-Stream DiT 构成,同步支持文生图与图像编辑任务。官方重点列出了四大核心升级:
一是紧凑高效。 采用混合粒度注意力与前缀 KV 缓存复用技术,在较低算力下依然能保持出色的画质。
二是原生透明。 这是其最具辨识度的能力——可直接生成带 alpha 通道的 RGBA 图片,支持编辑透明图层或从照片中抠出主体。生成透明图的推荐提示词格式如下:
This is an RGBA image with transparency. <你的描述>. The image has alpha channel and the background is transparent.
三是编辑能力强。 最多支持 10 张参考图;可通过画圈、涂抹或独立遮罩指定局部修改;在人像和商品编辑中能有效保持身份特征。
四是质感与排版。 文字排版、人像布光及细节渲染均较上一代有显著提升。
模型支持原生 2K 输出,官方推荐的宽高比与尺寸对照如下:
| 比例 | 尺寸 |
|---|---|
| 1:1 | 2048 × 2048 |
| 4:3 | 2400 × 1792 |
| 3:2 | 2528 × 1696 |
| 16:9 | 2752 × 1536 |
| 9:16 | 1536 × 2752 |
默认推理步数为 40 步。
特别提示许可问题: Qwen-Image 2.1 采用 Qwen Research License,而非 Apache 2.0 协议。这意味着虽然权重开放,但并非完全 free-to-use,商用前务必确认授权范围。
此外,官方配套发布了两个提示词改写模型(基于 Qwen3.5-VL-9B 微调,分文生图和图像编辑两类),可将短提示词扩写为细节丰富的长描述。若生成画面元素单薄,建议搭配使用。
二、硬件需求与模型权重选择
本次测试机型为 RTX 3060 12GB。结论先行:可以运行,但需选择 int8 精度的权重。
官方 ComfyUI 权重仓库提供三档精度,主模型与文本编码器各选其一即可,无需全量下载:

12GB 显存推荐配置如下:
qwen_image_2.1_int8_convrot.safetensors(7.26 GB)
qwen3vl_8b_int8_convrot.safetensors(9.35 GB)
qwen_image_2.1_vae_bf16.safetensors(0.68 GB)
上述三个文件合计约 17 GB。bf16 档画质最优但极耗显存(主模型 14.23 GB + 编码器 17.53 GB),w4a8 档体积最小(6.31 GB)但精度折损明显。
需注意,VAE 仅有单一档位——它是 RGBA 变分自编码器,原生透明通道由此实现。
三、ComfyUI 部署避坑:版本兼容问题
Qwen-Image 2.1 在发布首日即 支持 ComfyUI。但此处存在版本时间差陷阱:
支持该模型的核心节点 TextEncodeQwenImage21,于 2026 年 9 月 19 日才通过 PR #16400 合并至 ComfyUI 主干(该 PR 新增约 805 行代码,同时引入 TextEncodeQwenImage21 与 QwenImage21Cache 节点)。
若 ComfyUI 版本低于 v0.37.0(如 v0.33.0),则会出现以下现象:
模型文件路径正确,但节点列表中缺失
TextEncodeQwenImage21,导入工作流直接报错。
解决方案:升级 ComfyUI 至 v0.37.0 以上版本。
避坑提示: requirements.txt 中包含部分 workflow-templates 媒体资源,国内镜像安装时常报 No matching distribution found。这些资源仅用于模板缩略图,不影响生成功能。可跳过报错,仅安装核心依赖:
安装完成后重启,节点即可正常显示。
四、模型文件挂载与路径配置
权重文件可放入 ComfyUI/models/ 对应目录,但强烈推荐通过配置文件挂载,避免数十 GB 文件的重复复制。
在 ComfyUI 根目录创建 extra_model_paths.yaml,配置路径后重启:
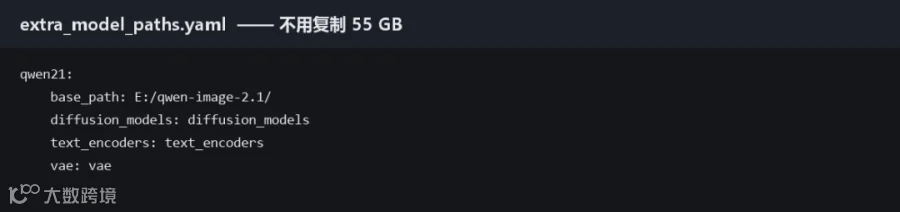
重启后,UNETLoader 和 CLIPLoader 的下拉菜单中即可识别到挂载的模型文件。
五、启动报错排查:PyTorch 环境冲突
启动服务时若遇到以下报错:
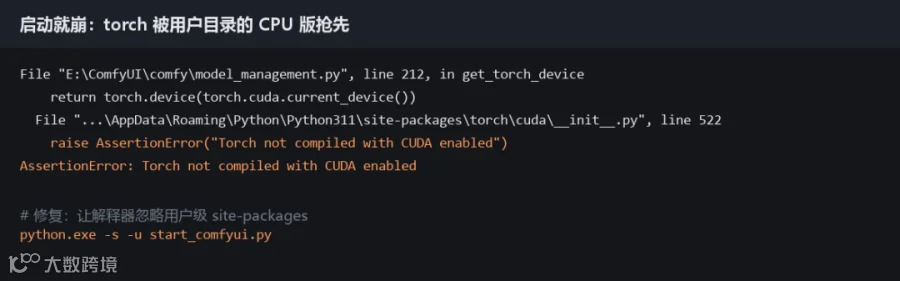
核心原因: 报错路径指向 C:\Users\<用户名>\AppData\Roaming\Python\Python311\site-packages\torch。这是用户级 site-packages,其中残留的 CPU 版 torch 优先级高于 ComfyUI 自带环境中的 CUDA 版 torch,导致运行时实际调用的是 CPU 版本。
解决方案: 添加 -s 参数,阻止 Python 加载用户级 site-packages:
或者设置环境变量 PYTHONNOUSERSITE=1。
验证修复效果:
经验总结: 此问题与 Qwen-Image 2.1 无关,但只要本机安装过其他 AI 工具(常在用户目录残留 CPU 版 torch),就极易触发此冲突。
六、工作流配置与关键参数设置
最小可用工作流包含 8 个核心节点:
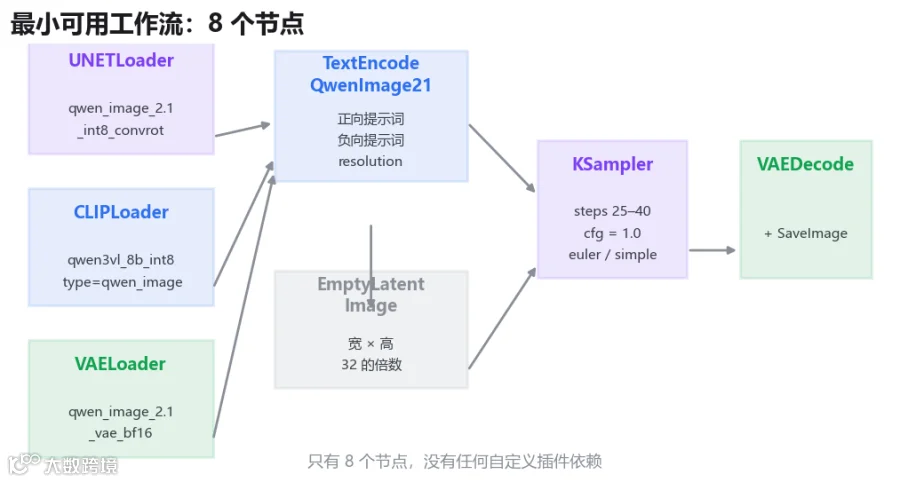
| 节点 | 关键参数 |
|---|---|
| UNETLoader | qwen_image_2.1_int8_convrot.safetensors |
| CLIPLoader | qwen3vl_8b_int8_convrot.safetensors,type 必须选 qwen_image |
| VAELoader | qwen_image_2.1_vae_bf16.safetensors |
| TextEncodeQwenImage21 | 正向提示词、负向提示词、resolution |
| EmptyLatentImage | 宽 × 高 |
| KSampler | 步数 25–40,cfg = 1.0,euler + simple |
| VAEDecode | 连接 VAE |
| SaveImage | 默认 |
三大高频易错点:
qwen_image。选错虽不报错,但会生成纯噪声图。
将工作流导出为 API 格式的 JSON,即可通过脚本实现批量自动化出图。
七、性能实测:分辨率与生成耗时分析
在同等提示词与硬件条件下,实测数据如下:
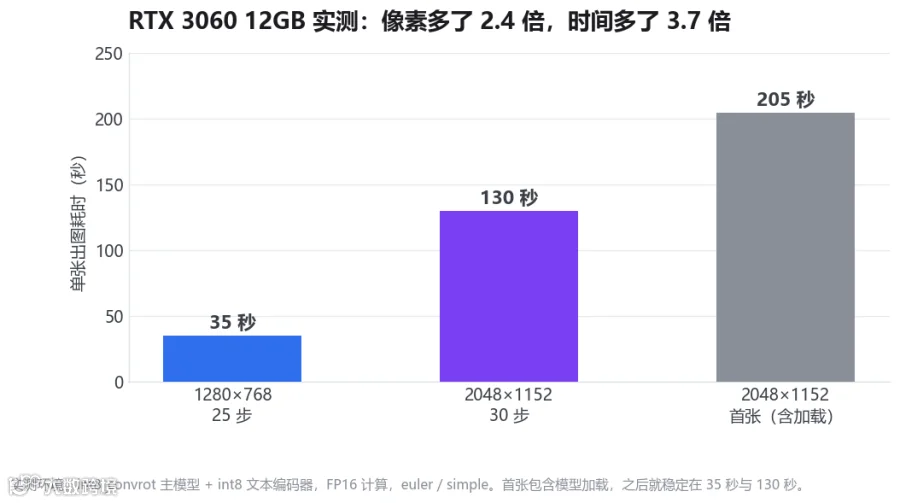
像素面积增加 2.4 倍,耗时增加 3.7 倍,表明分辨率对时间的影响呈超线性。日常配图建议使用 1280×768 档位;仅在制作文字密集型信息图时,才需调用 2K 分辨率。
八、实战演练:信息图生成与文字排版限制
提示词结构模板
实测采用高效的三段式提示词结构:
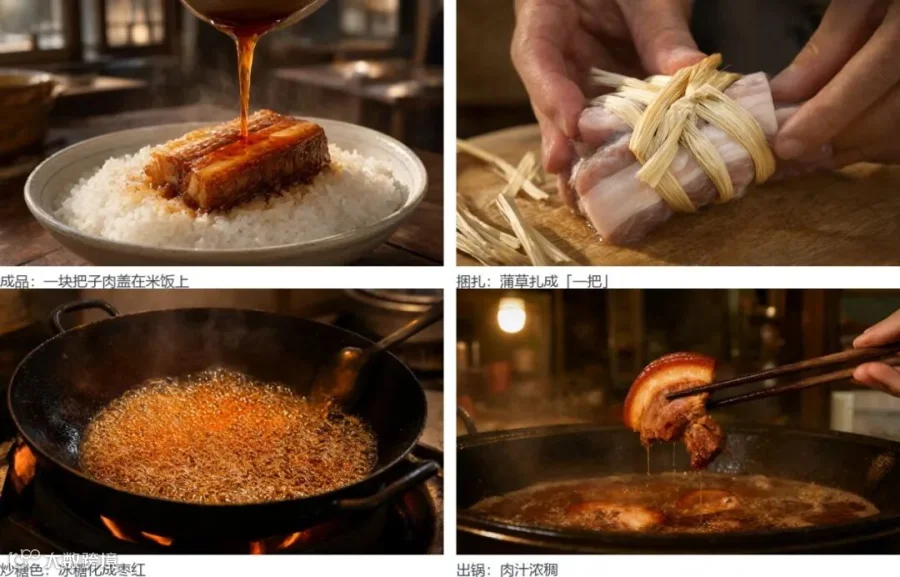
1. 画面描述: 设定主体、场景、光线与构图。例如:“一块新鲜带皮五花肉置于厚实木案板上,肉皮淡金、肥肉雪白、瘦肉鲜红,清晨自然光从窗户斜射。”
2. 风格定义: “纪实美食摄影风格,暖色调,浅景深,横构图,高清。”
3. 负面提示: “文字、水印、签名、低质量、模糊、变形、多余肢体、卡通、插画。”
该模板成功生成 10 张高质量分步配图:
数字序号渲染限制
在尝试生成“十二道工序汇总信息图”时,发现模型在渲染数字序号时存在明显缺陷:
核心结论: 模型对中文字符渲染稳定,但无法准确生成数字编号。 制作信息图时,应将序号排版交由后期软件处理,切勿依赖模型直接生成。
注:由于生成时无法实时查看图像,本文通过 OCR 逐字核对中文(确认无碎字)及像素结构分析(确认网格版式)进行双重验证。
九、进阶应用:API 批量生成与特色功能
API 自动化出图
面对批量配图需求,调用 API 远比手动操作高效。将工作流导出为 JSON 后,可通过极简脚本循环提交:

核心逻辑仅需三步:向 /prompt 提交任务获取 prompt_id;轮询 /history/{id} 等待生成完成;调用 /view 下载图像。此原生 API 方案无需依赖任何第三方插件,模型迭代时脚本无需修改。
原生透明与局部编辑
透明图生成: 结合前文提到的 RGBA 提示词模板,直出带 alpha 通道的图像,完美契合贴纸设计、商品合成等场景,免除二次抠图步骤。
局部精准编辑: 导入参考图,通过遮罩或涂抹指定修改区域,辅以文本指令(如“将背景替换为日落海滩”)。系统支持同时输入 10 张参考图,在多人合影修图或保持商品特征一致性时极具实用价值。
十、常见问题速查表
| 故障现象 | 根本原因 | 解决方案 |
|---|---|---|
缺失 TextEncodeQwenImage21 节点 |
ComfyUI 版本低于 v0.37.0 | 升级至 v0.37.0 及以上 |
启动报 Torch not compiled with CUDA enabled |
用户级 site-packages 的 CPU 版 torch 优先级冲突 | 启动命令添加 -s 参数 |
| 模型下拉框无法识别文件 | 文件路径未正确配置 | 使用 extra_model_paths.yaml 挂载 |
| 输出纯噪声图 | CLIPLoader 的 type 未选 qwen_image |
修正 type 参数 |
| 画面发糊或过曝 | cfg 参数设置过高 | 将 cfg 降至 1.0 |
| 分辨率尺寸报错 | 宽高非 32 的倍数 | 调整为 32 的倍数 |
| 图像内编号为乱码 | 模型不擅长渲染数字序号 | 后期软件添加序号,提示词剔除数字 |
| pip 安装报找不到包 | 国内镜像缺失模板媒体包 | 手动安装核心依赖包 |
附:模型权重下载与目录结构
为提升下载效率,已整理完整的 55GB 权重文件并提供网盘下载。目录结构已对齐 ComfyUI 标准,下载后可直接解压至 models/ 目录下。
下载链接:https://pan.quark.cn/s/71b8a194e823
文件清单及体积明细如下(合计约 51.56 GiB):
| 目录 | 文件名 | 体积 |
|---|---|---|
| diffusion_models | qwen_image_2.1_bf16.safetensors | 13.25 GB |
| diffusion_models | qwen_image_2.1_int8_convrot.safetensors | 6.76 GB |
| text_encoders | qwen3vl_8b_bf16.safetensors | 16.33 GB |
| text_encoders | qwen3vl_8b_int8_convrot.safetensors | 8.71 GB |
| text_encoders | qwen3vl_8b_w4a8.safetensors | 5.88 GB |
| vae | qwen_image_2.1_vae_bf16.safetensors | 0.63 GB |
低显存精简方案: 若无需全量模型,仅需下载以下三个文件即可在 12GB 显存下流畅运行(合计约 16 GB):