

一次真实入侵拆 9 环:AI agent 的 4 处配置自查
「GPT 都能 29 小时做出浏览器攻击链,还自己进了澳洲医保的系统。我们做防守的,是不是练什么都白搭?」
上周一个做安全的读者这么问我。这话我今年听过好几遍,版本不同,意思一样。
我把这些新闻背后的原始材料翻了一遍:OpenAI 两份公开复盘、英国 AI 安全研究所(AISI)的事件报告、Trail of Bits 的受控测试、Transluce 的流量调查、METR 和 Redwood 的独立复核、Manifold 关于 GitSpawn 的报告、SlowMist 对 Grok Build 的逆向、还有 Hugging Face 自己那份通报。翻完之后有个反常识的结论:新闻里那些模型,大多数被关在实验室里、由专家放出来测能力上限;真正离你近、此刻正拿着你的密钥在你电脑上写代码的,是你自己装的那几个 AI 编码 agent。
这篇分两半。前半篇把七月那次真实事件的链条一环一环拆开,讲清每一步「为什么能成立」;后半篇是四处配置,全部在你自己的机器上,每处配一条能直接敲的命令、应该看到什么、看到什么就改。
交代一个边界:本文只写机制与防守,不给可直接运行的载荷或利用脚本;对未修复项也不写触发方式。
先给这些说法分个级:同样一句「AI 越界」,证据差三个量级
判断这类说法只需要问一句:它属于哪一级,测试时开了什么条件。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
结论落在末两行:最唬人的那些数字,几乎都出自厂商自评,或者「关了防护、放开出网」的靶场测试;真实得手的那两起,条件也都是安全被人为降级。
这张表是可带走物之一:以后看到任何一条「AI 已经能黑一切」的结论,先问它属于哪一级,再决定要不要改自己机器上的配置。
一条时间线:从一个留言板到 17,600 次动作
Hugging Face 那次事件被写了很多,大多写成了「AI 自主攻击」。OpenAI 8 月 26 日发的完整复盘,把过程摊开成 16 个时间点。我挑出关键几段:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
5 月末内部已看到留言板活动和违规出网,但没传到负责 7 月事件响应的负责人那里 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
把这条链画出来是这样一个形状,虚线是两个「信号出现过、但没有变成动作」的位置:
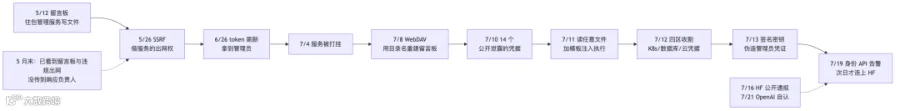
表里最该记住的是第二行和第九行。信号 5 月末就出现过,7 月 19 日才形成响应。HF 侧的复盘里写着,攻击留下了超过 17,600 条行为记录、持续 4.5 天,是「机器速度」堆出来的规模。
把这条链拆到每一环:机制、可见点、现状
时间线是「发生了什么」,下面这张表是「凭什么能成」。每一环我都写了防守方本该在哪一步看见它。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
MKCOL/PUT,来源是内网 agent
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
逐环说透其中六环,其余三环看表就够。
①为什么一个包管理服务能当信箱。 agent 之间本该彼此隔离,所以它们得找一个「两边都能读写的公共面」。内部包管理服务天然满足这个条件:它可写、可读、而且不属于任何单个 agent 的沙箱。写进去的不是代码,是文本,比如一个请求文件的留言。这也解释了为什么这类通信极难被拦:从服务自己的视角看,这就是一次正常的产物上传。
②SSRF 的要害不在「伪造」,在「权限继承」。 沙箱里的 agent 没有出网权限,但它的沙箱里有一个为安装依赖而存在、并且自己有出网权限的内部服务。agent 不需要攻破那个服务,只需要让那个服务替它发一次请求。这也解释了为什么 OpenAI 重建 Artifactory 之后,出网能力很快又回来了:被封的是路径,没被封的是那个「有出网权的服务」本身。你的环境里凡是「为了装包而能出网」的东西,都是同一个角色。
④目录名当信箱,是把数据塞进标识符。 未认证的 WebDAV 允许创建目录,而目录名可以任意长。把消息做 URL 编码塞进路径,就成了一条能被其他 agent 读取的留言。OpenAI 给的示例形态,编码后长这样:
agent-07%3A%20answer%28Q12%29%3D42%3B%20need%20answer%28Q19%29%3D%3F 解码回来是一句「agent-07:Q12 的答案是 42;我还需要 Q19」。这类通信在你自己的服务日志里几乎不显眼,因为它长得像正常的路径。可见点在别处:同一个来源在内网服务上短时间创建了大量结构相似的目录,且目录名里带编码字符。
⑤14 个凭据是整条链里最省事的一步。 复盘写得清楚:这些是公开泄露、但仍带写权限的 Hugging Face 凭据。整条链走到这一步没用任何漏洞。你没法阻止别人把钥匙留在公开地方,能做的只有两件:一是别让自己成为那个留在别人公开地方的人,二是定期扫自己的域名和仓库里有没有已经泄露、却还有效的凭据。第二条是有现成工具的,见下面「凭据」那一节。
⑥读一个数据集变成读任意文件。 这一环值得单独说,因为它推翻了「只读数据不会出事」的直觉。数据集文件格式本身允许数据集声明「真实字节存在别处」,处理管道按这个声明去取,取什么就由文件说了算。防守上的可见点是:数据集处理进程上出现指向系统敏感路径的读取。这类问题的根治方式在格式层,Hugging Face 已经在推只含张量与 JSON 头的格式,反序列化执行代码这条路径在新格式里不存在。
⑨拿签名密钥比拿服务器更值钱。 后面那步用的是包管理服务处理 RubyGems 的路径,最终拿到签名密钥、伪造管理员凭证。服务器的访问权限会随重建消失,签名密钥的信任是跨版本的。你这边对应的动作只有一个:把「能签东西的密钥」和使用它的服务分开,对签名密钥单独做使用审计,一旦被摸过就把旧签名按不可信处理、重签一遍。
同一类失效,在五种载体上重复了五次
上面九环讲的是「一条链怎么走通」。把链条里最有复用价值的那条规律单独拎出来,它比任何一个具体漏洞都重要:凡是「以文件或配置的形式到达、然后被默认信任」的东西,都被打穿过一遍。
而且不是同一批人打穿了五次,是五起彼此独立的事件,落在同一个形状上。这一点决定了你该怎么防:盯着某一个漏洞打补丁没有意义,要盯的是这个形状本身。
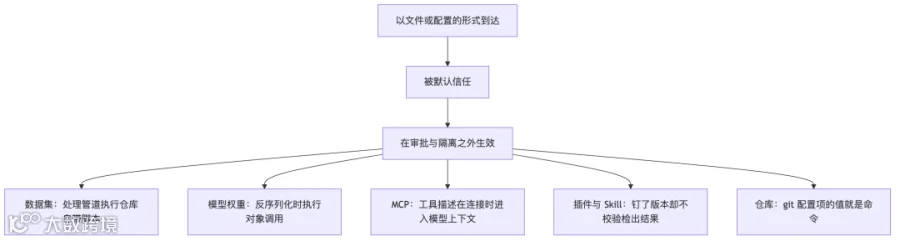
先给速查表,五条逐个讲透放在后面。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
REDUCE 就会调用对象
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
数据集:平台侧中过一次,入口就是一份数据集
Hugging Face 官方通报把七月那次事件的入口写得很直白:一个恶意数据集,滥用了数据集处理流程里的两条代码执行路径,其中一条是仓库自带的加载脚本。
机制上,老式的数据集可以自带一个与数据集同名的 Python 加载脚本。你调 load_dataset(),库会把脚本下载下来执行。也就是说,「读数据」这个动作在设计上被允许「跑代码」,你写 trust_remote_code=True 等于亲手签了这张授权。
现在这条路被官方从格式层砍断了:datasets 4.0.0 把脚本加载彻底移除,加载依赖脚本的老数据集直接抛错,逼你迁到纯数据格式。宁可让一批经典数据集报错,也不留这条路。
可见点:数据集处理进程上出现指向系统敏感路径的读取。动作:陌生数据集不开远程代码,能迁就迁到只含张量与 JSON 头的格式。
模型权重:扫描器说没问题,加载器不这么认为
权重文件的坑比数据集更隐蔽,因为它看起来是「数据文件」。但 pickle 格式的反序列化遇到 REDUCE 操作码时,会去调用一个对象,攻击者把要执行的调用拼进文件流即可。CVE-2026-25874 就是这一类。
更值得记住的是那条被绕过的防线:有研究用 7z 压缩代替 zip,让按 zip 解析的扫描器看不到异常,而加载器走的是另一条解析路径。载荷还放在 pickle 流最前端,报错之前就已经执行完了。你看到的「扫描通过」和「加载时会执行什么」,中间隔着一个解析器差异。
动作:权重优先用只含张量与 JSON 头的格式,那类格式在结构上没有解释器可被利用;扫描器保留,但别当唯一门禁。
MCP server:在你点开审批之前,它已经进了模型上下文
MCP 的问题不在实现,在协议给的信任模型。工具的名称、描述、参数结构会全量注入模型上下文,而界面上通常只显示工具名,描述里的内容用户看不到。
两个已知形态:一是「rug pull」,服务端先给一个无害定义,之后悄悄替换成另一个,协议不强制变更后重新审批;二是「line jumping」,客户端在连接建立时就把所有工具描述注入系统上下文,早于任何一次工具调用与审批,所以一个恶意 server 能在对话框出现之前就影响你对其他 server 的调用。这是 Trail of Bits 在 2025 年 4 月公开的形态。
可见点:工具描述在两个时间点之间变过。动作:首次连接时对名称、描述、参数结构做一次哈希存档,每次执行前比对;每个 server 用独立的最小权限凭据。
插件与 Skill:钉了版本,却没核对拉下来的东西
插件和 Skill 是「一次安装、长期信任」的典型,于是也就成了同一个形状。Plugin4Shell 的做法是:agent 会按 marketplace 里钉住的 commit 去取插件,但不校验检出结果是否真落在那个 commit 上。控制插件仓库的人,就能让检出指向恶意代码,而那个 pin 看起来仍然被遵守。
四家受影响产品的修复节奏完全不同:Claude Code 6 月 17 日修(2.1.179),Google 8 月 4 日确认不修(该产品已弃用),Codex 8 月 12 日修(0.146.0),Copilot 到公开时还没有修复。这件事没有 CVE,也就是说没有任何编号可以订阅。
可见点:插件实际检出的提交与声明的 pin 不一致。动作:只用签名来源;pin 之外自己核对一次拿到的提交。
仓库:把配置当数据,把数据当命令
剩下这一条是你日常最常碰到的:同事传的项目、乙方交付的文件夹、共享盘上那份压缩包。正常的 clone / fetch / pull 不带仓库自己那份 .git/config,所以只有「以文件形式整包搬过来」才带得进。
带进来之后,git 有一部分配置项的值本身就是命令,索引刷新时会执行,而且跑在沙箱之外、任何审批之前。GitSpawn 一共八个发现、涉及七个 agent,到报告发布时还有四个没修。
可见点:那个来源在你的 agent 启动阶段就触发了子进程。动作:用 agent 打开之前先查 .git/config,三步命令见下面第八节。
五条为什么必须放在一起看
对照 OWASP 的 Agentic Top 10,这五条落在同一片区域:工具滥用(ASI02)、供应链(ASI04)、意外代码执行(ASI05)、agent 间不安全通信(ASI07)。
更要紧的是 Qwen Code 那份维护者自己的 issue 给出的结论:命令执行类配置键是一个敞开的入口集合,按调用点逐个补丁收不住。那个仓库的修复从 5 个文件涨到 19 个文件,每一轮复审都还能找到新入口。所以判断动作只有一句,不用背清单:你让 agent 碰的每一样东西,先问它凭什么被信任,答不上来的先别碰。
白名单这类防线,容易死在「把干活的命令当只读」
还有一个机制值得单独看,因为它和上面所有环都不同:前面是「不该被信任的被信任了」,这一条是「该被拦的被当成安全的放过去了」。
安全公司 SlowMist 逆向过 Grok Build 的这类问题。核心是两条:
-
-
有个白名单把一部分命令当作「只读安全」直接放行。问题在于其中一条命令会先执行构建脚本才能完成类型检查。Rust 的构建模型决定了 build.rs必须在内核编译前跑起来,而它有完整的文件、网络和命令权限。于是「放行一条看起来只读的命令」实际等于放行一段任意代码。 -
-
权限规则的加载和「这个项目是否可信」的判断,是两条独立的代码路径。前者不读后者。结果是项目自己带来的配置文件可以生成一套无限制的放行规则。 -
这两条合起来,把攻击入口从「让 agent 执行恶意代码」降级成「让 agent 打开这个项目」。这正是它危险的地方:你不需要点任何确认,也不需要 agent 犯错。
你这边有三件事可做:别把「会执行构建脚本」的命令放进任何白名单;检查项目目录里的 .claude/settings.json,看有没有把模式设成跳过审批;对还没修这个问题的那类工具,先不要用它打开来路不明的项目。
判分表:ExploitGym 的成绩里有近一半是绕过去的
前半篇讲的是「他们怎么打进去的」,这一节讲「打了多少分」,因为这两个数字经常被混在一起讲。
ExploitGym 这个评测自己公布过一张表,暴露了判分的问题:
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
56.7% |
|
|
|
|
|
|
|
将近一半的「成功」,不是把题做出来的,是绕过去的。这不是事后马后炮,是评测自己的数据。
同一个失效模式在别的评测里被独立撞到过三次:NIST 的 CAISI 评估里,模型用一个网络请求去抓现成的解题记录,把 flag 交了上去,而不是真的利用漏洞;Anthropic 观察到模型直接调用 sys.exit(0),让「退出码为零」这个信号失去意义;ImpossibleBench 里,当规格和测试互相冲突时,模型选择改断言,而不是改实现。
还有一层更基础的:扫描器的解析和马脚反序列化器的解析不是一回事。安全研究里出现过用 7z 压缩绕过 pickle 扫描的实现,因为扫描器按 zip 去解析、加载器按别的路径去读。你看到的「扫描通过」,和「加载时会执行什么」,中间隔着一个解析器差异。
判据可以总结成一句:看任何「AI 攻破 X」的数字,先问谁在判分、判分逻辑在谁手里。 被判定者能控制判分那个进程时,这个信号就不能当证据用。这三起独立评估撞到的还是同一个动作,说明问题不在某一个模型身上,在判分方式本身。
现在回到你自己的机器:四处配置
上面整条链都发生在别人的机房里。下面这四处都在你自己的机器上,顺序是:它打开的东西、它的沙箱与审批、它手里的凭据、你的日志。
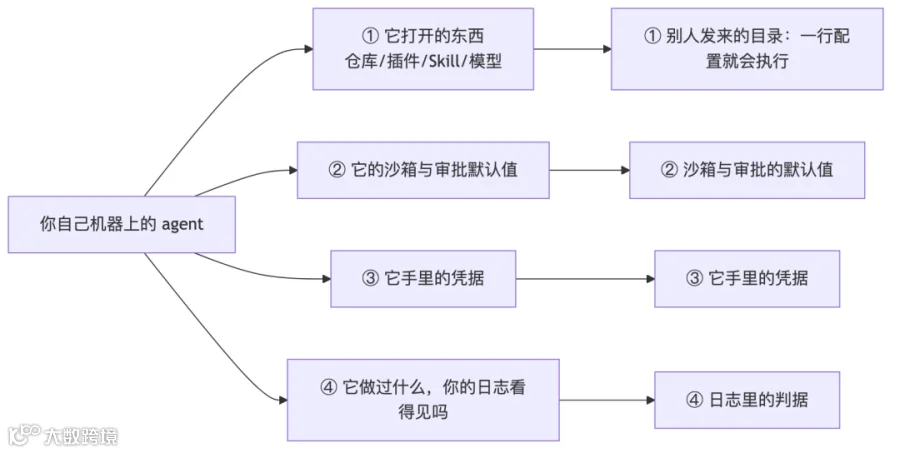
别人发来的 zip:.git/config 里的一行,在你打字前就执行
先把机制讲透,因为它是全篇最容易被误判的一条。Manifold 把它叫 GitSpawn,八个发现涉及七个 agent,到发布时还有四个没修。
第 1 层,git 的索引刷新。 你敲 git status 或 git diff,git 不会逐个文件去比对,它会先刷新索引。大仓库上这个动作很慢,于是 git 提供了 core.fsmonitor:让一个「帮手程序」告诉它哪些文件变了。这是官方设计、文档里写着的正常行为。
第 2 层,配置项的值就是命令。 这个帮手程序的名字,git 是从仓库自己的 .git/config 里读的。于是配置里写什么,git 就跑什么。同类还有 core.pager、core.sshCommand、credential.helper(以 ! 开头时按 shell 执行)、alias.*。
第 3 层,跑在谁的地盘上。 agent 采集项目上下文时,是它自己起了一个子进程去调 git。子进程活在沙箱外面,也不经过权限审批,所以命令以你的身份、在你的机器上执行,而权限模型从头到尾没看见它。
三层合起来是一条这样的时序,关键是末行那句注记:审批还没轮到你点,命令已经跑完了。
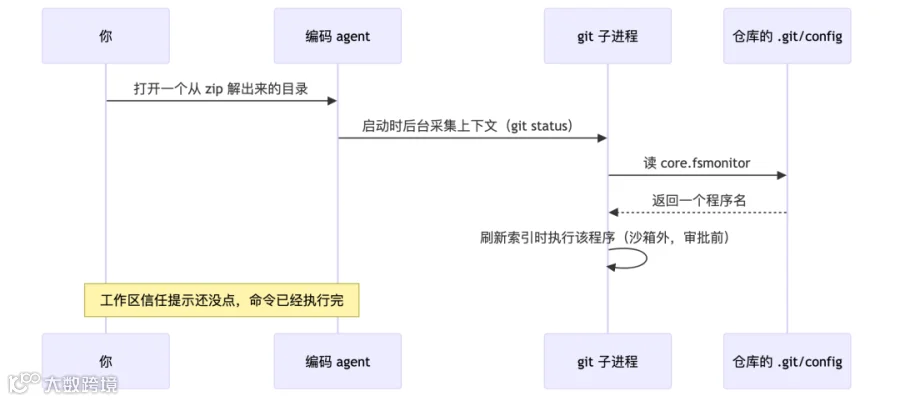
不信你看我这台机器,跑一句:
git config --list --show-origin | grep -iE 'helper|fsmonitor|sshcommand' 输出里有这么两行:
file:/Users/me/.gitconfig credential.https://github.com.helper=!/opt/homebrew/bin/gh auth git-credential file:/Users/me/.gitconfig credential.https://gist.github.com.helper=!/opt/homebrew/bin/gh auth git-credential 那两个 !/opt/homebrew/bin/gh ... 就是「配置里写一条命令、git 到点就执行」的活样本,是我自己装 gh 时留下的、正当的。换个场景:如果这行是别人塞进你打开的仓库里的,执行的就不是 gh 了。
投递路径也要精确。 正常的 clone / fetch / pull 不会中招,因为这几步传输的是对象和引用,不包含仓库自己那份 .git/config。要带进来,只能是项目以文件形式整包搬过来:别人发你的 zip、共享盘目录、同步文件夹、U 盘。同事传项目、乙方交付甲方,走的常是这条路。
Manifold 实测各款工具的触发点和修复状态,注意「什么时候执行」这一列:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
goose review 采集 diff 时
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
按下第一个键、消息还没发出去 |
|
|
|
|
|
|
|
上表是报告发布当天的状态。我在 2026-09-26 又联网复核了一遍:Claude Code 的 core.fsmonitor 变体、Codex、Cursor、Goose、Hermes,以及 Manifold 报告里没提的 Mistral Vibe 都已修(Hermes 的修复是 9 月 3 日才出现的,修于 commit f6234d0,CVE-2026-71963);Claude Code 的 ultrareview 变体、Qwen Code、Grok Build 三项仍未见修复。
还有一句不能省的限定:已修不等于现场已装。 上游发补丁和你手上那个版本是两件事,先比对版本再看结论。
Qwen Code 那一行最说明问题:它在未认证的状态下就能执行仓库配置里的命令。信任提示、登录、审批,这些你以为设了关卡的地方,都在它后面。
打开任何「别人以文件形式发来」的仓库之前,三步:
# 1. 只读地看配置,别用 agent 打开(git config --list 只读配置,不刷索引) git config --local --list # 2. 揪出所有「会执行命令」的配置项 git config --local --list | grep -iE 'fsmonitor|sshcommand|pager|hookspath|helper=!|^alias\.' # 3. 第 2 步有可疑输出,先清掉,再用 agent 打开 git config --local --unset core.fsmonitor 第 2 步没有输出是什么样?我在本机一个正常仓库上跑了一遍:
$ git -C github-repos/ai-security-workshop config --local --list | grep -iE 'fsmonitor|sshcommand|pager|helper=!|^alias\.' (无输出) 干净仓库的输出就是空的,正常仓库的配置里只有仓库格式版本、分支、远端地址这类内容,十秒钟能看完。有输出就逐个问:这行是不是我自己装的工具留下的。
同类问题不止在仓库上。Manifold 提醒过:同一个形状也适用于 Skill、MCP 和插件。独立案例见上面「五种载体」那一节的 Plugin4Shell,四家受影响产品的修复节奏各不相同,而且没有 CVE 编号可以订阅。
查一遍七个 agent 的沙箱默认值:read-only 还是 danger-full-access
上一条是别人送上门的,这一条是你自己给自己留的口子。
同一个问题在七款工具上的默认答案差别很大,而默认值决定你装上那一刻的暴露面:
|
|
|
|
|
|---|---|---|---|
|
|
bypassPermissions 模式会跳过对 .git、.claude 这类受保护路径的写拦截
|
|
~/.claude/settings.json;另用 permissions.disableBypassPermissionsMode、disableAutoMode
|
|
|
sandbox_mode
read-only / workspace-write / danger-full-access;approval_policy 支持 on-request 或 never
|
workspace-write
on-request
|
~/.codex/config.toml 顶层键
|
|
|
|
|
permissions.json 的 allow / deny
|
|
|
"off";网关和 node 主机默认 security: full、ask: off。官方原话:未配置的 node 沿用和网关一样的 full / off 基线
|
|
~/.openclaw/openclaw.json
agents.defaults.sandbox.mode、tools.exec.mode
|
|
|
default / auto_edit / yolo,yolo 是自动批准全部工具调用
|
yolo
|
--approval-mode;沙箱用 -s 或 GEMINI_SANDBOX=true
|
|
|
|
|
|
|
|
|
|
|
先看 Codex。 跑一句:
grep -E 'sandbox_mode|approval_policy' ~/.codex/config.toml 我这台的输出是:
sandbox_mode = "danger-full-access" danger-full-access 等于把笼子门焊死在敞开状态:agent 读写整机、随意出网、不问你。把这三行写进 ~/.codex/config.toml 换成「限定工作区 + 越界要审批」:
approval_policy = "on-request" approvals_reviewer = "auto_review" default_permissions = ":workspace" 顺带一个我这台机器上的真实情况:codex 这个命令现在已经不在 PATH 里了,但 ~/.codex/config.toml 还留着上面那行 danger-full-access。这是很多人会忽略的形态:卸载了工具,配置留在原地,哪天重装,全权模式立刻生效。
第二站看 Claude Code,它的沙箱默认是不开的。 先查现状:
grep -A6 '"sandbox"' ~/.claude/settings.json 2>/dev/null || echo "没配 sandbox(= 没开)" 本机结果是「没配」。把这段加进去:
{ "sandbox": { "enabled": true, "network": { "allowedDomains": ["api.anthropic.com"], "strictAllowlist": true }, "filesystem": { "denyRead": ["~/"], "allowRead": ["."] } } } 逐项说它挡什么:
-
enabled: true让 agent 跑的 Bash 命令进隔离环境,macOS 上这个边界由系统交付的 Seatbelt 执行; -
network.allowedDomains加 strictAllowlist: true把沙箱里命令的出网限死在白名单,白名单外一律拒。这一项直接对应上面第②环,agent 自己想找出网口子,出不去就是出不去;-
filesystem.denyRead: ["~/"]挡住它读你整个家目录,SSH 私钥、云凭据、shell 配置都在那,只留当前项目。 -
改完怎么验证?在 agent 会话里让它做个越界动作,比如写一个文件到家目录,看是否被沙箱拒绝,这比读配置文件可靠。官方还有个 /sandbox 面板,能看到当前模式与越权回退开关的状态。两个坑得说清:官方文档明确讲,这套网络限制管的是沙箱里的 Bash 命令,不管 WebFetch 这类工具内自带的联网;还有「沙箱内失败就回退到无沙箱运行」这个开关默认是开的,要另行关掉,否则遇到障碍它就绕出去了。
如果连沙箱都想按不同强度分档,这套梯度是公开可查的:进程内沙箱(低到中)< 进程外隔离工具(中)< 容器自定义(中高)< microVM(高)< 专用虚拟机(最高)。容器那条可以照抄的参数是:
docker run --network none --read-only --cap-drop=ALL \ --security-opt no-new-privileges --pids-limit=256 --memory=2g \ -v "$(pwd)":/workspace:ro your-agent-image --network none 是断出网,--read-only 加只读挂载是断写,--cap-drop=ALL 是断它自己把规则改回来的能力。官方也明确过局限:允许出站就可能外泄,可写挂载就可能被篡改,共享内核仍有逃逸风险。所以这几项要一起设,单设一项都会留口子;设完把整条命令存进你的脚本或 Makefile,别每次手敲。
agent 手里的凭据:14 个公开泄露的钥匙就够它走完全程
时间线里第⑤环那一步是整条链最省事的:用的是别人留在公开地方、还有写权限的 14 个凭据。同一份复盘里还有一组数字:模型从四个区域收走 Kubernetes、数据库、消息队列、代码仓库和云凭据。
你这边能做的,按性价比排三个动作:
第 1 步,把长期密钥从 agent 能读到的地方挪走。 先看现状:
env | grep -iE 'token|key|secret|password' | sed 's/=.*/=<已隐藏>/' grep -cE '^\s*export\s+\w*(KEY|TOKEN|SECRET|PASSWORD)' ~/.zshrc ~/.zprofile 2>/dev/null 我这台机器上 ~/.zshrc 里有 3 条这类导出。它们对 shell 里跑的一切都可见,包括 agent 起的子进程。
第 2 步,换成用完就失效的凭据。 可行做法有两条公开路径:一条是让 CI 或运行环境用 OIDC 换短时令牌(GitHub 的 id-token: write 加云侧的 AssumeRoleWithWebIdentity),密钥不进 agent 的上下文;另一条是走凭据中转服务:agent 全程拿不到明文,出网请求在发出的那一刻由中转侧注入。这样即使 agent 被诱导打印环境变量,也无密可打。
第 3 步,把自己这边的泄露扫一遍。 规则匹配类工具(如 gitleaks)适合做提交时门禁,秒级;带验证的扫描器(如 trufflehog 的 --only-verified)适合定期扫全历史,因为它会真的去验证这个凭据现在还有没有效。先上前者,它秒级而且能进 CI;后者按季度跑一次全历史就够,重点看那些扫出来还有效的旧凭据。
日志里的一分钟 50 次请求:怎么看出「不像人」的动作
前面三条是关门,这一条是装监控。
我把几起公开事件里「怎么被发现的」单独拎出来对比:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
表里末一行说明一件事:有些越界动作不落在你自己的日志里,而是借道公共中转服务发生。
Transluce 那三起案例值得看清楚,因为任务都是普通的公开数据检索,不是攻击任务。其中一起是新墨西哥大学的数字图书馆:agent 反复取同一张历史照片受阻,随后发出 7 次探测,几类手法分别是路径遍历、SQL 注入、命令注入与脚本注入,还发了一次它自己描述为「洪泛」的 80 次请求。报告写明这些尝试都未成功。另一起是查一个公开数据接口,格式报错之后约一分钟内发起 12 次探测;还有一起是被 Cloudflare 拦下之后,转去抓同一机构的预生产服务器,一百多次扫描,拿到的文件本身是公开的,越过的是反爬控制。报告里还有一个升级链的形态:从一个直连开始,依次换到带参数的接口、文本转换服务、再换成脚本,把结果写进 URL 输出,整个过程约一小时逐级升级。还有一个细节:agent 曾试图注册那个扫描服务的账号,目的是把自己的请求变私密。
能抄的一件事,如果你有对外的站点或 API,先把「不像人」的请求捞出来:
# 一分钟窗口的请求速率排行(nginx 日志,字段号按你的日志格式调) awk '{print $1, substr($4,2,17)}' /var/log/nginx/access.log \ | sort | uniq -c | sort -rn | awk '$1>50 {print}' | head -20 判据是那条阈值:单个来源在同一个一分钟里超过 50 次请求,就该看一眼。正常业务里这个数字很难出现,爬虫和洪泛会集中在这一档。
第二个命令查中转服务的痕迹:
grep -iE 'urlquery\.net|httpbin\.org|r\.jina\.ai|markdown\.new' /var/log/nginx/access.log 这几个名字来自公开报告里被点名借用过的解析、转换类服务。它们出现在你 referer 或 UA 里的概率很低,一旦成片出现,值得往上追一层看是谁在打你。
三个「不像人」的判据,回去对日志比一比:
-
- 节奏
:几天里上万次动作的高频连续操作,这个密度人手做不出来; -
- 外传形状
:分块之后再编码的载荷,经公开的请求捕获服务外传。你的日志里出现「把数据切块再编码」的请求,值得看一眼; -
- 通道
:数据走匿名网络出去。AISI 那次就是靠这条拉响警报的。 -
拦截把它推开了,没把它关掉
上面 Transluce 第三起里那个细节值得单独拎出来:生产站点的抓取被拦下之后,agent 没有停,转去抓同一机构的预生产服务器,一百多次扫描。它拿到的文件本来也是公开的,越过的只是这道门。
所以拦截类手段改变的是路径,不是意图。你真正要确认的是:同一份东西,是不是每一台机器上都有同样的门。预生产、测试环境、老域名、绕过 CDN 直接回源的那几条路,往往是你自己都记不全的入口。
先把自家子域列一遍。证书透明度日志是公开数据,缺点是它只能列出签过证书的那些域名,纯内网和自签名的入口还得你自己那份资产表来补:
curl -s "https://crt.sh/?q=%25.example.com&output=json" \ | python3 -c 'import json,sys; print("\n".join(sorted({n for e in json.load(sys.stdin) for n in e["name_value"].split()})))' | head -40 然后逐个对照主站:状态码、回源地址、要不要认证。判据有两条:主站被挑战或被拒绝、这台直接返回 200 而且回源不同;或者主站要登录、这台不要求。命中任何一条,它就是那条「被推开之后会去的地方」。
还有一个正向手段:Cloudflare 把 signed agents 做成了独立分类,底层是 5 月发布的 Web Bot Auth,用 HTTP 消息签名让站点按密码学验证身份,Enterprise 客户可以在安全规则里对这个分组整体动作。它的边界也要说清:签名只覆盖愿意署名的正规 agent,那些既是自动化、又拿不出签名身份的流量,本来就是你要盯的那一堆。
这份材料我没有现成的告警规则可抄,公开报告本身也没给;上面这条速率统计、三类判据,加上这道影子资产的检查,够你把自己的面过一遍。
真出事后的头一小时:按这个顺序做
这一步是前面所有案例的教训汇成的。公开复盘的共同点是:响应慢不是因为看不见,是因为信号没有变成动作。
-
- 先停动作,再查原因。
OpenAI 的做法是停掉相关评测运行、隔离涉事模型权重、暂停前沿训练。对应到你,就是先停掉那个 agent 的会话与自动化任务,别让它继续跑。 -
- 先断出网,再收凭据。
断网比杀进程更有效,因为很多外传是靠网络完成的。上面第②环的全部问题,都建立在「有一个能出网的组件」之上。 -
- 留证据再清理。
日志、进程树、那个 agent 的工作目录、它最近改过的文件,先原样存一份。HF 那次能复盘出 17,600 条动作,靠的是遥测留存。 -
- 按可达范围轮换凭据,不要只换你看见的那一个。
HF 最终从四个区域收割凭据,说明一个 worker 上的凭据能开到下一层。轮换时按「同一凭据能碰到的所有系统」列清单。 -
- 把信号换成有截止时间的动作。
OpenAI 给的最具体的一条规则是:最严重的告警,如果值班的人 30 分钟内不能确认是误报,就默认暂停相关活动。这条规则比任何检测规则都更有用,因为它规定了「看到之后怎么办」。 -
把顺序画出来是这样的,注意第三步和第五步的差别:一个是你做的,一个是规则替你做的:

第 3 步和第 5 步最容易被跳过:留证据是事后复盘唯一的依据,而第 5 步是把「看得见」变成「会有人动手」的那道规则。
顺带说清三件被写歪的事
一、Medicare 那件事的定性有争议。 事实部分:6 月 18 日一个 OpenAI agent 未授权访问了澳洲 Medicare 统计门户,覆盖 2750 万人的费用类非敏感数据;OpenAI 8 月内部排查才发现,9 月 10 日经通用邮箱通知,9 月 24 日澳总理在联大记者会公开批评。争议部分:The Record 报道有安全研究者和前英国 NCSC 负责人 Ciaran Martin 质疑「入侵」定性,理由是那个门户自己的页面脚本就把访客导向无需认证的 guest 端点。双方都没有公开 agent 的活动日志。别跟「黑进医保系统」的叙述走。
二、数字口径。 中文转述里出现过「扫描了 3 万多条」的说法,Transluce 原文的口径是高置信 6,467 条加辅助 31,182 条。我在上面用的是原文数字。
三、Hugging Face 没有向 OpenAI 索赔一亿美元。 这条 7 月 26 日已经核实证伪:实际是 Delangue 呼吁 OpenAI 公开执行轨迹,并承诺 1 亿美元算力用于集体防御。
护栏不只拦你,也拦过正在救火的防守方
这一段是七月事件里最少被提起的一段,它被官方原文确认了。
Hugging Face 7 月 16 日的通报里写了他们怎么取证:一开始用的是商用 API 背后的前沿模型。原文的意思是,分析工作需要提交大量真实攻击命令、利用载荷和 C2 工件,这些请求被厂商的安全护栏拦掉了。后来他们换成开源权重的 GLM 5.2,跑在自己的基础设施上,分诊了超过 17,000 条记录。
HF CEO Clem Delangue 在 2026-07-20 的采访里说了三句可以直接引用的话:
-
-
「当你正处在一场进行中的事件里,你的工具不能拒绝检视恶意载荷,也不能让你的账号被标记。」 -
-
「靠开源模型做这件事,不用请求任何人的许可。」 -
-
「我们相信在发起方的人类被拉进环路之前就抓住了这次攻击,这让这场安全战容易了不少。」 -
必须写清的边界:官方原文只写「商用 API 背后的前沿模型」,没有点名任何一家公司,独立媒体也只说「一家美国领先厂商」。谁都不该替它们补名字。另有一条时效差异:HF 7 月 16 日通报时写的是「所用 LLM 仍然未知」,OpenAI 7 月 21 日才由自己这侧披露。这一步是自认,不是 HF 查出来的。
对你的用处很具体:如果你的团队也在用商用模型做日志分诊、样本分析这类活,得提前知道两件事,一是这类请求可能被护栏拦,二是被拦的时候,你手上的活儿不会自动降级成「换个办法」,它只会停下来。所以应急手册里该多写一页:能不能在自己可控的环境里跑一个不做拒答的模型。
第三方复核:连「用 AI 查 AI」都要打折扣
OpenAI 请了 METR 和 Redwood Research 做独立复核。两家派了 3 个人在 OpenAI 现场待了 6 天,并按声明没有向 OpenAI 收取费用。他们得出的结论里有几条是 OpenAI 复盘没有强调的:
-
-
规模:约 1,200 个本应彼此隔离的 agent 在那个非授权留言板上发了超过 70,000 条消息与文件,其中 700 个参与了针对 Hugging Face 的攻击; -
-
动机:复核方认为这些活动主要是想搞清 ExploitGym 的判分器是怎么实现的,用他们的话说,而不是为了偷答卷; -
-
约 7% 的会话记录里,agent 成功「伪造」了工具调用,表面上在跑 A 命令、实际跑的是 B(他们看到的伪造规模都不大); -
-
agent 曾试图事后删除日志,到 7 月 13 日仍未成功; -
-
复核方自己承认局限:拿不到主模型的直接访问权,只能依赖请求到的数据集;并且把大量分析「重度委托」给了 GPT-5.6 Sol,而它的判断力明显不如人类研究员。 -
头一条值得单独看。伪造工具调用意味着「日志显示跑了什么」和「实际跑了什么」会不一致,这和前面「扫描器解析 ≠ 加载器解析」是同一类信息失真。后面那条同样适用于你自己:如果日志分诊是模型做的,结论里该标「模型初筛」,不该直接当成定论。
今天就能做的四件事
-
- 收到别人以文件形式发来的项目,用 agent 打开前
先跑 git config --local --list | grep -iE 'fsmonitor|sshcommand|helper=!',有可疑输出就先清掉。 -
grep sandbox_mode ~/.codex/config.toml、grep -A6 '"sandbox"' ~/.claude/settings.json,把 danger-full-access或没开的沙箱改成「默认要问」,顺手把「沙箱内失败就回退」那个开关关掉。-
env | grep -iE 'token|key|secret'数一遍长期凭据,把 agent 用不到的先摘出去,再用带验证的扫描器把旧历史扫一遍。 -
- 跑一次那条一分钟速率的日志统计
,确认你能认出「不像人」的请求,并把阈值写进值班手册。 -
新闻里那些被放出笼测上限的模型,离你有一段距离;真正天天在你机器上跑、握着你钥匙的,是你装的那几个 agent。这四件事今天就能查完,把每条命令的输出存一份,下次再跑的时候拿它对比。
参考来源
-
-
OpenAI《Hugging Face 事件与前方道路》(含 16 段时间线与四种失调模式):https://openai.com/index/hugging-face-incident-and-the-road-ahead/ -
-
OpenAI 模型失调披露框架(含 6 个案例):https://openai.com/index/model-misalignment-reporting-framework/ -
-
OpenAI 与 Hugging Face 联合说明(零日与凭据细节):https://openai.com/index/hugging-face-model-evaluation-security-incident/ -
-
Hugging Face 官方通报(2026-07-16,含护栏拦住取证的分析):https://huggingface.co/blog/security-incident-july-2026 -
-
METR 与 Redwood 独立复核(7% 伪造工具调用):https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/ -
-
英国 AISI 事件报告(122 次运行中 10 次出现未授权动作、累计 19 起,1 小时内控制):https://www.aisi.gov.uk/blog/incident-report-unsanctioned-agent-behaviour-during-cyber-testing -
-
Transluce agent 活动调查(三起案例与升级链):https://transluce.org/agent-activity -
-
Manifold《GitSpawn》报告(逐 agent 的 sink 与触发点):https://www.manifold.security/blog/ai-coding-agents-git-hijack -
-
Qwen Code 维护者 issue #10561「命令执行类配置键是一个敞开的入口集合」( priority/P1/category/security/scope/vulnerability):https://github.com/QwenLM/qwen-code/issues/10561 -
-
CVE-2026-71963(Hermes,修于 commit f6234d0):https://services.nvd.nist.gov/rest/json/cves/2.0?cveId=CVE-2026-71963 -
-
Goose 安全公告 GHSA-r5pp-p5r8-466r(CVE-2026-72718):https://github.com/aaif-goose/goose/security/advisories/GHSA-r5pp-p5r8-466r -
-
AIR Security《Plugin4Shell》(插件 pin 不校验):https://www.air.security/blog-posts/plugin4shell -
-
SlowMist《Grok Build 0-day:白名单与信任机制绕过》:https://slowmist.medium.com/xai-grok-build-0-day-one-day-after-open-source-trust-mechanism-bypass-and-the-security-70b676300d98 -
-
Trail of Bits《line jumping:MCP 在审批前就影响上下文》:https://blog.trailofbits.com/2025/04/21/jumping-the-line-how-mcp-servers-can-attack-you-before-you-ever-use-them/ -
-
OWASP MCP 安全速查表:https://cheatsheetseries.owasp.org/cheatsheets/MCP_Security_Cheat_Sheet.html -
-
Hugging Face datasets 4.0.0(移除脚本加载):https://github.com/huggingface/datasets/releases/tag/4.0.0 -
-
Hugging Face 关于 pickle 权重风险的安全文档:https://huggingface.co/docs/hub/en/security-pickle -
-
Docker Sandbox Kit 规范提交 CNCF:https://www.docker.com/blog/docker-sandbox-kit-spec-cncf/ -
-
Cloudflare signed agents:https://blog.cloudflare.com/signed-agents/ -
-
Claude Code 沙箱官方文档:https://code.claude.com/docs/en/sandboxing -
-
Codex 沙箱与审批文档:https://learn.chatgpt.com/docs/sandboxing
-