

哈喽,大家好~
咱们今儿把最近很多同学问到的K近邻回归,做一个完整的解释~
清晰的解释+完整的代码,大家可以收藏起来,慢慢学习~
在机器学习里,K-近邻,即:K-Nearest Neighbors, KNN 是最直观、最容易理解的算法之一。
因为,它没有复杂的模型参数,只靠“谁离我最近”来做预测。
KNN 回归核心点
比如你在一个小区,要预测某一栋楼的房价,但你没有这栋楼的成交记录。
你可以去看“相似”的楼,比如位置、楼层、面积都相近的几套,再把这些相似楼的房价平均一下,作为你要预测的那栋楼的价格。
KNN 回归就是这么做的:
-
给定一个新的样本点 x,要预测它的目标值 y; -
在训练集中找到与 x 最近的 K 个点(按距离,比如欧氏距离); -
把这 K 个近邻的目标值做平均(或加权平均),作为 x 的预测值。
公式化地,若 N_k(x) 表示 x 的 K 个最近邻索引,那么“均匀权重”下的预测为:
你也可以用距离来加权,距离越近权重越大,例如常见的逆距离权重:
其中距离可以是欧氏距离:
优点:简单、直观、无模型训练(“懒学习”)。缺点:预测时要算距离,计算量大;维度高时效果差(“维数诅咒”);对特征尺度敏感(需做标准化)。
完整案例
案例中,我们的目标,用 PyTorch 从头实现 KNN 回归,基于一个二元(2D)数据集做实验~
数据集,二维输入 (x1, x2),目标 y 为非线性函数 + 噪声;
实现方式,KNN 回归(均匀权重与逆距离权重),用 PyTorch 张量计算距离(支持 GPU);
import torch
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import cm
import random

seed = 42
np.random.seed(seed)
torch.manual_seed(seed)
random.seed(seed)

# 1) 数据集:二维输入,标量输出
# 我们设计一个非线性函数,带有交互项,以便 KNN 的局部平滑特性能被观察到:
# y = sin(x1) * cos(x2) + 0.3 * x1 * x2 + noise
n_samples = 600
X = np.random.rand(n_samples, 2) * 6.0# 范围 [0,6)
x1 = X[:,0]
x2 = X[:,1]
y = np.sin(x1) * np.cos(x2) + 0.3 * x1 * x2 + 0.5 * np.random.randn(n_samples)  # 加噪声

# 转为 PyTorch 张量(float32)
X_t = torch.tensor(X, dtype=torch.float32)
y_t = torch.tensor(y, dtype=torch.float32).unsqueeze(1)  # (n,1)

# 2) 划分训练/验证/测试集
n_train = 360
n_val = 120
n_test = n_samples - n_train - n_val

perm = np.random.permutation(n_samples)
train_idx = perm[:n_train]
val_idx = perm[n_train:n_train+n_val]
test_idx = perm[n_train+n_val:]

X_train = X_t[train_idx]
y_train = y_t[train_idx]
X_val = X_t[val_idx]
y_val = y_t[val_idx]
X_test = X_t[test_idx]
y_test = y_t[test_idx]

# 标准化(KNN 对尺度敏感,常需做标准化)
mean = X_train.mean(dim=0, keepdim=True)
std = X_train.std(dim=0, keepdim=True) + 1e-8
X_train_s = (X_train - mean) / std
X_val_s = (X_val - mean) / std
X_test_s = (X_test - mean) / std

# 3) 实现 KNN 回归器
class KNNRegressor:
    def __init__(self, X_train, y_train, device='cpu'):
        self.X = X_train.to(device)
        self.y = y_train.to(device)
        self.device = device

    def predict(self, X_query, k=5, weight='uniform', eps=1e-6):
        """
        X_query: (m, d)
        return: (m, 1)
        weight: 'uniform' or 'distance' (inverse distance)
        """
        X_query = X_query.to(self.device)
        # 使用 torch.cdist 直接得到 (m, n_train) 的距离矩阵(p=2 欧氏距离)
        # 记得 cdist 在 CPU/GPU 上都可用
        dists = torch.cdist(X_query, self.X, p=2)  # (m, n_train)
        m = dists.shape[0]
        # 找到前 k 最近的索引
        knn_dists, knn_idxs = torch.topk(dists, k=k, largest=False)
        # knn_dists: (m, k) 最近的距离
        # knn_idxs: (m, k) 索引
        # 取对应的 y 值
        knn_ys = self.y[knn_idxs]  # (m, k, 1)
        if weight == 'uniform':
            preds = knn_ys.mean(dim=1)  # (m,1)
        elif weight == 'distance':
            # 权重 = 1/(dist+eps)
            w = 1.0 / (knn_dists + eps)  # (m,k)
            w = w.unsqueeze(-1)  # (m,k,1)
            num = (w * knn_ys).sum(dim=1)
            den = w.sum(dim=1)
            preds = num / den
        else:
            raise ValueError("weight must be 'uniform' or 'distance'")
        return preds  # (m,1)

# 初始化回归器(支持 GPU,如有)
device = 'cpu'
knn = KNNRegressor(X_train_s, y_train, device=device)

# 4) 验证不同 K 值(交叉验证:在验证集上找最优 K)
def mse(a, b):
    return ((a - b) ** 2).mean().item()

K_list = [1, 3, 5, 9, 15, 25, 40, 60]
val_mse = []
for k in K_list:
    preds_val = knn.predict(X_val_s, k=k, weight='distance')
    val_mse.append(mse(preds_val, y_val))

best_k = K_list[int(np.argmin(val_mse))]
print("验证集最佳 K:", best_k)

# 5) 在测试集上评估最佳 K
preds_test = knn.predict(X_test_s, k=best_k, weight='distance')
test_mse = mse(preds_test, y_test)
print(f"Test MSE (k={best_k}): {test_mse:.4f}")

# 6) 准备绘图:我们将绘制网格预测(热力图)来展示模型的局部平滑行为
# 在原始坐标系上做图(非标准化),所以需要将网格点标准化再传入 predict
grid_n = 120
x1g = np.linspace(0, 6, grid_n)
x2g = np.linspace(0, 6, grid_n)
X1g, X2g = np.meshgrid(x1g, x2g)
grid_points = np.stack([X1g.ravel(), X2g.ravel()], axis=1)
grid_t = torch.tensor(grid_points, dtype=torch.float32)
grid_t_s = (grid_t - mean) / std

# 7) 生成几个不同 K 的预测表面用于对比
Ks_to_plot = [1, 5, 15, 40]
preds_grids = {}
for k in Ks_to_plot:
    preds = knn.predict(grid_t_s, k=k, weight='distance')  # (grid_n^2,1)
    preds_grids[k] = preds.detach().cpu().numpy().reshape(grid_n, grid_n)

# 8) 可视化分析
fig = plt.figure(figsize=(14, 10))

# 图1:训练数据散点(颜色表示 y)
ax1 = fig.add_subplot(2, 3, 1)
sc = ax1.scatter(X_train[:,0].numpy(), X_train[:,1].numpy(), c=y_train.squeeze().numpy(),
                 cmap='plasma', s=40, edgecolors='k', alpha=0.9)
ax1.set_title("训练数据散点(颜色表示 y)")
ax1.set_xlabel("x1")
ax1.set_ylabel("x2")
plt.colorbar(sc, ax=ax1, fraction=0.046, pad=0.04)

# 图2:网格上的预测热力图(k=best_k)并叠加训练点
ax2 = fig.add_subplot(2, 3, 2)
pred_best = knn.predict(grid_t_s, k=best_k, weight='distance').detach().cpu().numpy().reshape(grid_n, grid_n)
pcm = ax2.contourf(X1g, X2g, pred_best, levels=50, cmap='viridis')
ax2.scatter(X_train[:,0].numpy(), X_train[:,1].numpy(), c='white', s=18, edgecolors='k')
ax2.set_title(f"预测表面热力图(k={best_k})")
ax2.set_xlabel("x1")
ax2.set_ylabel("x2")
plt.colorbar(pcm, ax=ax2, fraction=0.046, pad=0.04)

# 图3:不同 K 的预测表面对比(子图)
ax3 = fig.add_subplot(2, 3, 3)
# 我们在同一子图里画轮廓线,并标注局部细节
for k, cmap in zip(Ks_to_plot, ['coolwarm', 'plasma', 'inferno', 'cividis']):
    cs = ax3.contour(X1g, X2g, preds_grids[k], levels=8, cmap=cmap, alpha=0.8)
ax3.set_title("不同 K 的预测轮廓(对比平滑程度)")
ax3.set_xlabel("x1")
ax3.set_ylabel("x2")

# 图4:验证集 MSE 与 K 的关系
ax4 = fig.add_subplot(2, 1, 2)  # 跨行放大
ax4.plot(K_list, val_mse, marker='o', color='magenta')
ax4.set_xlabel("K")
ax4.set_ylabel("Validation MSE")
ax4.set_title("验证集 MSE 随 K 的变化(选择最佳 K)")
ax4.axvline(best_k, color='green', linestyle='--', label=f'best K={best_k}')
ax4.legend()
ax4.grid(True)

plt.tight_layout()
plt.show()

# 额外图:真实值 vs 预测值 (测试集) 以及残差分布
plt.figure(figsize=(12,5))
plt.subplot(1,2,1)
plt.scatter(y_test.numpy(), preds_test.detach().cpu().numpy(), c='tab:blue', alpha=0.7, edgecolors='k')
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r--')
plt.xlabel("真实 y")
plt.ylabel("预测 y")
plt.title("真实 vs 预测(测试集)")

plt.subplot(1,2,2)
residuals = (preds_test - y_test).detach().cpu().numpy().squeeze()
plt.hist(residuals, bins=30, color='cyan', edgecolor='k')
plt.title("残差分布(测试集)")
plt.xlabel("预测 - 真实")
plt.tight_layout()
plt.show()
核心步骤
数据生成:我们生成了二维输入 (x1, x2) 在 [0,6) 区间均匀采样,目标 y 由一个非线性函数生成: ,再加上高斯噪声。这样的设计可以让目标函数有非线性和交互项,便于观察 KNN 的局部近邻平滑效果。
划分数据集:划分为训练/验证/测试三部分,验证集用于调参(选择 K),测试集用于最终评估。这是常规流程,避免信息泄露。
特征标准化:
-
KNN 用距离度量样本相似性,若每个特征尺度差别大,则大尺度特征会主导距离。因此需要用
KNN 实现要点:
-
我们使用 torch.cdist(X_query, X_train, p=2) 高效计算查询点与所有训练点的欧氏距离,返回一个 (m, n_train) 矩阵。 -
使用 torch.topk 找到每行最小的 k 个距离及对应索引,取出这些近邻的 y 值。 -
对于均匀权重直接求平均;对于逆距离权重,计算权重并作加权平均。注意在除以距离时要加上一个很小的 eps 以避免除零。
交叉验证选择 K:
-
我们在验证集上测试多个 K 值,选择使验证 MSE 最小的 K。通常较小的 K 会导致过拟合(预测非常局部、噪声较大),较大的 K 会过度平滑(欠拟合)。验证曲线能直观看到这个权衡。
网格预测与可视化:
-
为了把模型在二维输入空间的行为可视化,我们在输入域上生成一个规则网格(120x120),对每个网格点进行预测,然后用等高/热力图可视化预测值。 -
通过对比不同 K 的预测表面或轮廓线,能清楚观察到 K 值变化对平滑性的影响。
评估指标:
-
这里用均方误差(MSE)来评估回归性能:
可视化分析
训练数据散点图:

直观了解 y 在输入空间的分布(哪里高,哪里低,有无明显模式或噪声)。
大家可以看到某些区域颜色相近,表明局部平滑结构,KNN 会利用这些局部信息来预测。
网格预测热力图(k=best_k)并叠加训练点:
展示在整个输入域上的预测表面(连续),以及训练点位置。
热力图的颜色表示预测值大小。训练点的白色小点帮助你理解局部预测受哪些训练点支配。若训练点稀疏区域预测更平滑,密集区域预测更细致。
不同 K 的预测轮廓对比:
比较 K 的影响(局部性 vs 平滑性),K 小(如 k=1,3)时预测表面会更多捕捉数据细节和噪声(更“波动”);K 大时(如 k=40)预测平滑、细节丢失。通过轮廓线的密集/稀疏可以看到细节多少。
验证集 MSE 与 K 的关系曲线:
帮助选取合适的 K,通常会看到 U 型或近似 U 型曲线:K 很小时误差高(高方差),K 很大时误差也可能上升(高偏差)。曲线的最低点对应最优平衡点(最合适的 K)。
真实 vs 预测(测试集)与残差分布:
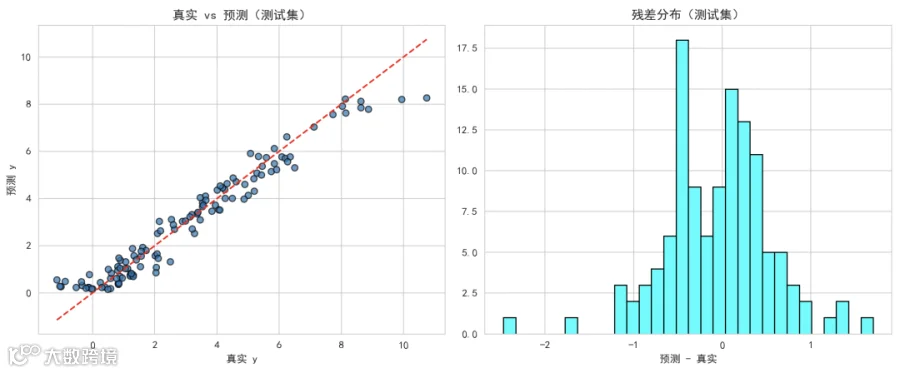
评估模型在未见数据上的表现,检查偏差/异常点,理想情况下点应沿 y=x 直线分布。残差直方图可以显示是否有偏差(均值偏离 0)或长尾异常值。
总结
总的来说,KNN 回归是一种非常直观且易于实现的非参数方法。
它的核心思想是“近邻的平均”,用最相似的数据点来预测目标。尽管计算复杂度较高且对高维敏感,但在低维、数据量中等、且关系局部性的任务上,KNN 可以是一种非常有效的基线方法~