


摘要:本文系统介绍 Verilator 的核心原理、编译命令、C++ 连接方式、Verilog 到 C++ 的映射细节、波形调试、仿真陷阱、性能对比与常见问题。重点通过 Verilog 片段与生成 C++ 代码的逐项对照,讲清每一处映射背后的原因。全文以列表、表格、代码块和 Mermaid 图为主,便于快速查阅。
目录:
-
• 🤔 Verilator 是什么? -
• ⚡ Verilator 的工作原理 -
• 🛠️ 快速上手:编译命令 -
• 🔗 用 C++ 连接 Verilog 信号 -
• 🔬 深入内部:Verilog 片段与生成 C++ 代码对照 -
• 🧩 总览:Verilog → Verilator C++ 映射表 -
• 1️⃣ 组合逻辑:assign -
• 2️⃣ 时序逻辑:always_ff -
• 3️⃣ 模块例化 -
• 4️⃣ always_comb + case -
• 5️⃣ 存储器 / 数组 -
• 6️⃣ DPI-C:Verilog 调用 C 函数 -
• 7️⃣ Verilog Testbench vs C++ App Testbench -
• 8️⃣ 常见坑对照表 -
• 🎯 一句话总结映射关系 -
• 📊 波形调试:让信号"动"起来 -
• 🚨 仿真中的陷阱 -
• 📈 性能对比 -
• ❓ 常见问题(FAQ) -
• 🎯 总结
🤔 Verilator 是什么?
-
• 定义:开源的 Verilog/SystemVerilog 仿真器和 Lint 工具。 -
• 开发者:Wilson Snyder 自 2001 年起开发,现由 CHIPS Alliance 和 Linux Foundation 指导。 -
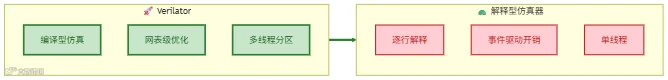
• 核心理念:将 Verilog 代码转化为高度优化的 C++ 或 SystemC 模型,再编译成可执行文件进行仿真。 -
• 与解释型仿真器的区别: -
• 不是逐行解释 Verilog。 -
• 将整个设计“翻译”成 C++,再用 GCC/Clang 优化编译。 -
• 性能优势: -
• 单线程速度约为解释型仿真器的 100 倍。 -
• 多线程下可再获得 2-10 倍加速。 -
• 典型用户:ARM、NVIDIA、Intel 以及众多顶尖高校。

⚡ Verilator 的工作原理
-
• 三阶段仿真模型: -
1. Verilation(翻译):读取 Verilog,执行 Lint 检查,可选插入断言/覆盖率,输出 .cpp/.h。 -
2. 编译:生成的 C++ 代码通过 GCC/Clang 编译,链接 C++ testbench,生成可执行文件。 -
3. 执行:运行可执行文件,时钟信号由 testbench 手动控制。 -
• 关键创新: -
• 不直接将 Verilog 翻译成 C++,而是编译成高度优化的、可选线程分区的模型。 -
• 可重新排序逻辑块,进行网表级别优化——速度优势的主要来源。

🛠️ 快速上手:编译命令
-
• 典型命令: verilator --cc --exe --build --trace \
--top-module top \
top.v sim_main.cpp -
• 常用选项:
-
• 编译产物: -
• Verilator 生成 Makefile(通常名为 V.mk)指导编译。 -
• 使用 --build时自动调用 make 完成编译。 -
• 自定义编译规则:不使用 --build,自己编写 Makefile 并通过include包含 Verilator 生成的 Makefile。
🔗 用 C++ 连接 Verilog 信号
方式一:直接访问顶层信号
-
• Verilator 将顶层模块转化为 C++ 类(通常命名为 Vtop)。 -
• 输入/输出信号定义为公有成员变量。 -
• 代码示例:
   #include "Vtop.h"
#include "verilated.h"

int main(int argc, char** argv) {
    VerilatedContext* contextp = new VerilatedContext;
    contextp->commandArgs(argc, argv);

    Vtop* top = new Vtop{contextp};

    // 驱动时钟
    while (!contextp->gotFinish()) {
        top->clk = !top->clk;  // 翻转时钟
        top->eval();           // ⚠️ 必须调用!重新计算电路状态
        contextp->timeInc(1);
    }

    top->final();
    delete top;
    return 0;
}
-
• 核心方法 eval(): -
• 调用它会让程序重新计算电路状态。 -
• 否则电路状态保持不变。 -
• 每次对输入信号赋值后,都必须调用 eval()。
方式二:DPI-C 机制
-
• DPI-C(Direct Programming Interface):允许 Verilog 调用 C/C++ 函数。 -
• 典型用途:存储器访问、寄存器值比较等与外部 C 代码交互。 -
• 使用步骤: -
1. Verilog 声明: import "DPI-C" function void pmem_read(
input bit re, input int addr,
input int mask, output int rword
); -
2. Verilog 调用: pmem_read(re, addr, mask, rword); -
3. C/C++ 实现: extern "C" void pmem_read(int re, int addr, int mask, int* rword) {
// 实现存储器读取逻辑
*rword = memory[addr];
} -
• 注意:DPI-C 要求使用 C 语言函数,而非 C++ 函数。C++ 函数和 C 函数的链接符号不同,混用会导致链接错误。
🔬 深入内部:Verilog 片段与生成 C++ 代码对照
⚠️ 说明:Verilator 实际生成的代码高度优化、命名复杂,下面是为了讲清映射关系而做的*简化示意,不是逐字生成结果。*
🧩 总览:Verilog → Verilator C++ 映射表
-
• 宏观翻译原则: -
• Verilog 中的“信号” → C++ 中的“变量”。 -
• Verilog 中的“过程块” → C++ 中的“函数”。 -
• 关键差异: -
• Verilog 是并行语义,C++ 是串行语义。 -
• Verilator 把所有需要求值的逻辑塞进同一个 eval()函数,通过精心安排的执行顺序模拟并行行为。 -
• eval()代表一个“仿真时刻”内所有电路的完整求值。
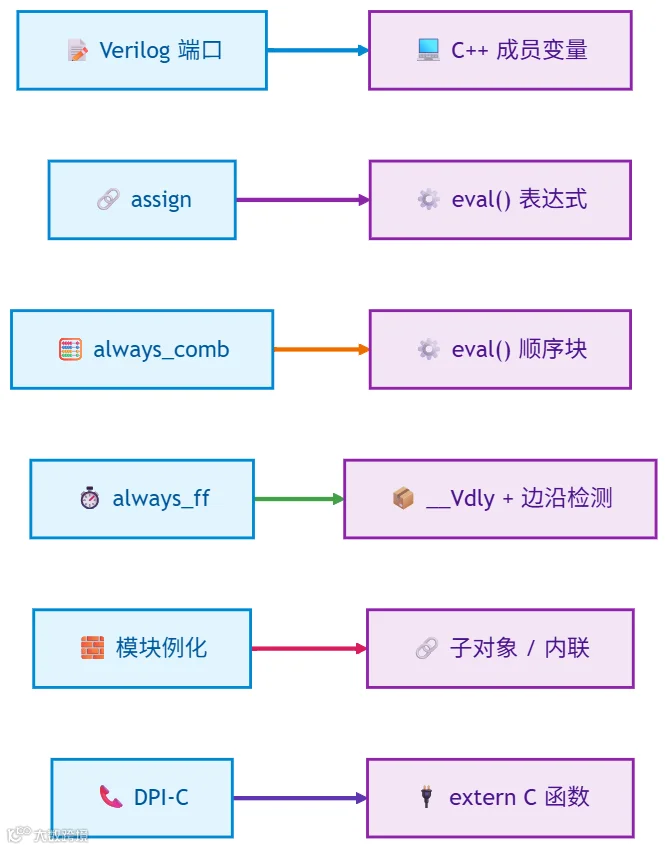
1️⃣ 组合逻辑:assign
Verilog 片段
   module top(
    input  logic a,
    input  logic b,
    output logic y
);
    assign y = a & b;
endmodule
生成的简化 C++ 模型
   struct Vtop {
    uint8_t a;   // input
    uint8_t b;   // input
    uint8_t y;   // output

    void eval() {
        y = a & b;   // assign 被放进 eval()
    }
};
对应关系
📖 详细说明
-
• 为什么端口变成成员变量? -
• C++ 类成员变量天然具备“对外可见、可读写”的属性。 -
• 与 Verilog 端口语义完全吻合。 -
• 用户写 top->a = 1等价于 Verilog testbench 中写a = 1。 -
• Verilator 默认用 uint8_t表示单比特信号,uint32_t/uint64_t表示更宽信号。 -
• 为什么 assign被放进eval()? -
• assign是连续赋值,硬件中右侧变化左侧立刻跟随。 -
• C++ 串行语言无法做到“事件触发”。 -
• 只能每次调用 eval()时重新计算所有连续赋值。 -
• 不调用 eval(),y永远是旧值——初学者最常见 bug。 -
• 为什么没有 __Vdly? -
• assign是纯组合逻辑,没有时钟沿概念。 -
• 不需要保存“下一状态”。 -
• __Vdly仅用于时序逻辑,模拟非阻塞赋值的延迟提交。
用户 App 代码
   #include "Vtop.h"
#include "verilated.h"

int main(int argc, char** argv) {
    VerilatedContext* ctx = new VerilatedContext;
    ctx->commandArgs(argc, argv);

    Vtop* top = new Vtop{ctx};

    top->a = 1;
    top->b = 0;
    top->eval();          // ⚠️ 必须调用,否则 y 不会更新
    printf("y = %d\n", top->y); // y = 0

    top->b = 1;
    top->eval();
    printf("y = %d\n", top->y); // y = 1

    top->final();
    delete top;
    return 0;
}
2️⃣ 时序逻辑:always_ff
Verilog 片段
   module counter(
    input  logic       clk,
    input  logic       rst,
    input  logic       en,
    output logic [7:0] count
);
    always_ff @(posedge clk) begin
        if (rst)
            count <= 8'h00;
        else if (en)
            count <= count + 1'b1;
    end
endmodule
生成的简化 C++ 模型
   struct Vcounter {
    uint8_t clk;
    uint8_t rst;
    uint8_t en;
    uint8_t count;

    uint8_t __Vdly__count;  // 延迟变量,保存“下一状态”
    uint8_t __Vclk;         // 用于检测时钟上升沿

    void eval() {
        // 检测 posedge clk
        if (clk && !__Vclk) {
            if (rst)
                __Vdly__count = 0;
            else if (en)
                __Vdly__count = count + 1;
        }
        __Vclk = clk;

        // 提交时序状态(实际 Verilator 会放在合适位置)
        count = __Vdly__count;
    }
};
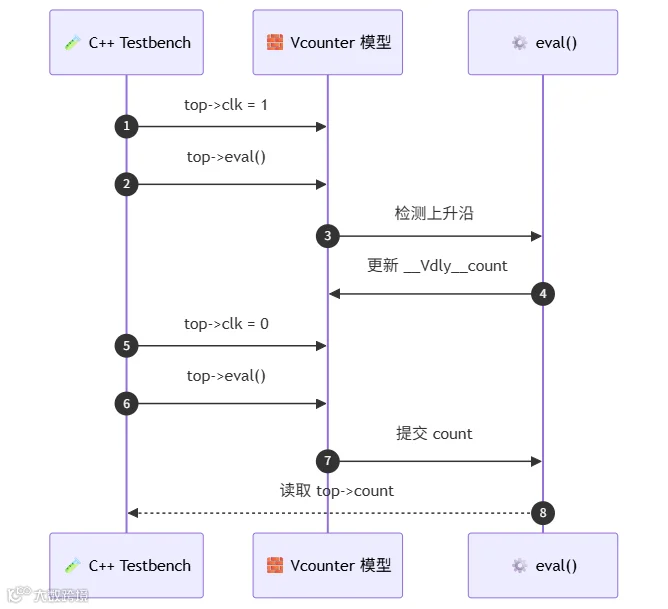
对应关系
📖 详细说明(列表版)
-
• 为什么需要边沿检测? -
• Verilog 中 @(posedge clk)是事件触发器:只有clk从 0 变 1 那一刻才执行。 -
• C++ 没有“事件”概念, eval()每次完整执行一遍。 -
• Verilator 必须自己模拟:保存上一次 clk值(__Vclk),比较当前值与上一次值。 -
• 只有当“当前为 1 且上一次为 0”时,才认为发生上升沿。 -
• 即 if (clk && !__Vclk)。 -
• 为什么需要 __Vdly__count? -
• 直接对应 Verilog 的非阻塞赋值语义。 -
• count <= count + 1含义:读取旧值,加 1,当前时间步结束时才写回。 -
• 同一 always_ff块中所有非阻塞赋值右侧都使用旧值,互不干扰。 -
• 若直接翻译成 count = count + 1;,会立刻覆盖旧值,语义错误。 -
• 因此引入 __Vdly__count作为“暂存区”: -
• 右侧读 count(旧值)。 -
• 左侧写 __Vdly__count(新值)。 -
• 最后统一提交。 -
• 这就是**“延迟提交”(delayed assignment)**。 -
• 为什么 count = __Vdly__count;出现在最后? -
• 模拟真实硬件中“时钟沿到来 → 所有寄存器同时更新”的行为。 -
• 必须等所有 __Vdly计算完毕,才能统一提交给正式变量。 -
• 否则会出现“前半段用旧值、后半段用新值”的不一致。
用户 App 代码
   #include "Vcounter.h"
#include "verilated.h"

int main(int argc, char** argv) {
    VerilatedContext* ctx = new VerilatedContext;
    ctx->commandArgs(argc, argv);

    Vcounter* top = new Vcounter{ctx};

    top->rst = 1;
    top->en  = 0;
    top->clk = 0;
    top->eval();

    top->clk = 1;
    top->eval();   // 上升沿,count 被清零
    printf("after reset: count = %d\n", top->count);

    top->rst = 0;
    top->en  = 1;

    for (int i = 0; i < 5; i++) {
        top->clk = 0; top->eval();
        top->clk = 1; top->eval();
    }
    printf("after 5 cycles: count = %d\n", top->count);

    top->final();
    delete top;
    return 0;
}
3️⃣ 模块例化
Verilog 片段
   module sub(
    input  logic a,
    output logic b
);
    assign b = ~a;
endmodule

module top(
    input  logic x,
    output logic y
);
    sub u_sub(
        .a(x),
        .b(y)
    );
endmodule
生成的简化 C++ 模型
   struct Vsub {
    uint8_t a;
    uint8_t b;

    void eval() {
        b = ~a;
    }
};

struct Vtop {
    uint8_t x;
    uint8_t y;
    Vsub u_sub;   // 例化子模块 → 成员对象

    void eval() {
        u_sub.a = x;   // 端口连接
        u_sub.eval();  // 调用子模块 eval
        y = u_sub.b;   // 输出连接
    }
};
对应关系
📖 详细说明
-
• 为什么例化变成成员对象? -
• Verilog 模块例化 = 在大电路中嵌入小电路,每个例化有独立内部状态。 -
• C++ 中自然表达:在 Vtop类里放一个Vsub类型成员变量。 -
• 每个 Vsub对象有自己的a、b,互不干扰。 -
• 对应 Verilog 中每个例化实例拥有独立寄存器。 -
• 端口连接为什么变成赋值? -
• Verilog 的 .a(x)表示“把外部信号x连到子模块端口a”。 -
• C++ 没有“连线”机制,只能用赋值模拟。 -
• u_sub.a = x;把x的值传给子模块。 -
• 输出端口反过来: y = u_sub.b;把子模块输出传回父模块。 -
• 为什么要在父模块 eval()中调用子模块eval()? -
• 组合逻辑需按数据依赖顺序求值。 -
• u_sub内部b = ~a依赖u_sub.a,而u_sub.a依赖x。 -
• 顺序:先 u_sub.a = x,再u_sub.eval(),最后y = u_sub.b。 -
• 顺序错误会导致 b基于旧的a计算。 -
• Verilator 优化器通常自动分析依赖并重新排序,但理解顺序对调试很重要。 -
• 补充: -
• Verilator 实际优化中可能把小型子模块**内联(inline)**到父模块 eval()中,避免函数调用开销。 -
• 调试模式( --debug)下层级通常保留,方便定位问题。
4️⃣ always_comb + case
Verilog 片段
   module mux4(
    input  logic [1:0] sel,
    input  logic       a,
    input  logic       b,
    input  logic       c,
    input  logic       d,
    output logic       y
);
    always_comb begin
        case (sel)
            2'b00: y = a;
            2'b01: y = b;
            2'b10: y = c;
            default: y = d;
        endcase
    end
endmodule
生成的简化 C++ 模型
   struct Vmux4 {
    uint8_t sel;
    uint8_t a, b, c, d;
    uint8_t y;

    void eval() {
        switch (sel) {
            case 0: y = a; break;
            case 1: y = b; break;
            case 2: y = c; break;
            default: y = d; break;
        }
    }
};
对应关系
📖 详细说明
-
• always_comb和eval()的关系: -
• always_comb是 SystemVerilog 组合逻辑专用块。 -
• 语义:只要块内任意输入变化,就重新执行整个块。 -
• Verilator 中,“重新执行” = 每次 eval()执行一遍。 -
• always_comb内部代码直接翻译到eval()函数体。 -
• 效果与 assign几乎一样,只是允许更复杂的if/case。 -
• case→switch的直接映射: -
• Verilog case和 C++switch语义高度相似。 -
• 两者都是优先匹配(配合 break)。 -
• Verilog casez/casex允许通配符匹配,Verilator 会翻译成更复杂的if-else链。 -
• 常量映射: -
• 2'b00等 Verilog 二进制字面量直接转成 C++ 整数字面量0。 -
• 多比特信号(如 4'b1010)转成十进制10或其他等价形式。 -
• default分支语义相同。 -
• 为什么没有 __Vdly? -
• always_comb是纯组合逻辑,没有时钟沿,没有“下一状态”。 -
• 所有赋值立即生效。 -
• 凡是带 posedge的块都需要__Vdly,不带时钟的都不需要。
5️⃣ 存储器 / 数组
Verilog 片段
   module ram(
    input  logic        clk,
    input  logic        we,
    input  logic [3:0]  addr,
    input  logic [31:0] wdata,
    output logic [31:0] rdata
);
    logic [31:0] mem [0:15];

    always_ff @(posedge clk)
        if (we)
            mem[addr] <= wdata;

    assign rdata = mem[addr];
endmodule
生成的简化 C++ 模型
   struct Vram {
    uint8_t  clk;
    uint8_t  we;
    uint8_t  addr;
    uint32_t wdata;
    uint32_t rdata;

    uint32_t mem[16];
    uint32_t __Vdly__mem[16];
    uint8_t  __Vclk;

    void eval() {
        rdata = mem[addr];   // assign

        if (clk && !__Vclk) {
            if (we)
                __Vdly__mem[addr] = wdata;
        }
        __Vclk = clk;

        // 提交写操作
        if (we)
            mem[addr] = __Vdly__mem[addr];
    }
};
对应关系
📖 详细说明
-
• 为什么数组直接变成 C 数组? -
• Verilog logic [31:0] mem [0:15]= 16 个 32 位元素。 -
• C++ uint32_t mem[16]语义完全一致。 -
• 存储器在硬件上就是连续存储单元,C 数组映射最自然。 -
• 索引范围对应:Verilog [0:15]→ C++[16],索引0..15。 -
• 若 Verilog 用 [1:16],Verilator 自动偏移,保证 C++ 侧从 0 开始。 -
• 为什么写操作需要 __Vdly__mem? -
• mem[addr] <= wdata是非阻塞赋值。 -
• 语义:时钟沿到来时读取 addr 和 wdata 旧值,当前时间步结束时才写入 mem。 -
• 直接翻译成 mem[addr] = wdata;在多个写操作并发时可能错误交互。 -
• 用 __Vdly__mem暂存,最后统一提交,准确模拟非阻塞行为。 -
• 组合读为什么不需要延迟? -
• assign rdata = mem[addr]是连续赋值,没有时钟。 -
• 直接 rdata = mem[addr];即可。 -
• 真实硬件中,这种“组合读”通常意味着存储器组合输出(读延迟为 0)。 -
• 同步读(一个时钟周期后输出)则需把读操作也放在 always_ff里。 -
• 性能含义: -
• 存储器在 Verilator 生成的 C++ 中就是普通数组,访问速度极快,没有“事件调度”开销。 -
• 这是 Verilator 在 CPU 仿真中特别受欢迎的原因——指令存储器、数据存储器都变成 C++ 数组,访问几乎零成本。
6️⃣ DPI-C:Verilog 调用 C 函数
Verilog 片段
   import "DPI-C" function int pmem_read(input int addr);

module top(
    input  int addr,
    output int data
);
    assign data = pmem_read(addr);
endmodule
C 函数实现
   extern "C" int pmem_read(int addr) {
    static int mem[256] = {0};
    return mem[addr];
}
对应关系
📖 详细说明
-
• DPI-C 的本质: -
• 跨语言调用协议,允许 Verilog 代码在仿真过程中“跳出”到外部 C/C++ 函数执行。 -
• Verilator 遇到 import "DPI-C"声明时,不翻译函数体,而是生成外部函数声明。 -
• 链接阶段由 C++ 链接器找到对应 C 函数实现。 -
• 为什么必须用 extern "C"? -
• C++ 支持函数重载,编译器会对函数名进行名称修饰(name mangling)。 -
• 例如 pmem_read(int)可能被编译成_Z9pmem_readi。 -
• Verilator 生成的外部声明默认期望 C 风格符号名(不做修饰)。 -
• 用 C++ 编译器编译 C 函数实现,链接器找不到符号。 -
• extern "C"告诉编译器“不要做名称修饰,用 C 风格链接”。 -
• 参数传递方向: -
• Verilog input参数 → C 函数传值参数。 -
• Verilog output参数 → C 函数指针参数(C 语言只能通过指针返回多个值)。 -
• Verilog return值 → C 函数返回值。 -
• 注意位宽匹配:Verilog int是 32 位,Cint通常也是 32 位;longint(64 位)或shortint(16 位)需选对应 C 类型。 -
• 典型应用场景: -
• CPU 仿真中,连接“Verilog 实现的 CPU”和“C 实现的存储器模型”。 -
• RTL 代码无需改动,存储器直接用 C 数组甚至 malloc大块内存,方便高效。 -
• 指令比较:乱序执行 CPU 中,用 DPI-C 让 Verilog 在提交指令时调用 C 函数,与软件模拟器参考结果对比。
⚠️ DPI-C 必须用
extern "C",否则 C++ 名称修饰会导致链接失败。
7️⃣ Verilog Testbench vs C++ App Testbench
Verilog 传统 Testbench
   initial begin
    rst = 1;
    en  = 0;
    clk = 0;
    #1 clk = 1;
    #1 clk = 0;
    #1 clk = 1;
    #1 $finish;
end
Verilator 用户 App 代码
   int main(int argc, char** argv) {
    VerilatedContext* ctx = new VerilatedContext;
    ctx->commandArgs(argc, argv);

    Vcounter* top = new Vcounter{ctx};

    top->rst = 1;
    top->en  = 0;

    top->clk = 0; top->eval(); ctx->timeInc(1);
    top->clk = 1; top->eval(); ctx->timeInc(1);
    top->clk = 0; top->eval(); ctx->timeInc(1);
    top->clk = 1; top->eval(); ctx->timeInc(1);

    top->final();
    delete top;
    return 0;
}
对应关系
📖 详细说明
-
• 为什么 initial变成main()? -
• Verilog initial块在仿真开始时执行一次。 -
• C++ main()也是程序入口执行一次,语义完全对应。 -
• 但 Verilog 允许多个 initial块同时执行,C++ 只有一个main()。 -
• 需要多个并行“初始块”时,在 main()中显式串行安排。 -
• #1延迟为什么消失? -
• Verilog #1是“延迟 1 个时间单位”,C++ 中没有直接对应,代码立即执行。 -
• Verilator 做法:由用户在 testbench 中显式控制“仿真时间”。 -
• 通过 ctx->timeInc(1)手动推进时间戳。 -
• timeInc(1)只是给VerilatedContext时间戳加 1,不会真的等待。 -
• 它只是逻辑时间,用于波形文件中的时间轴。 -
• 时钟为什么需要手动翻转? -
• Verilog 中时钟通常由 testbench 的 always #5 clk = ~clk;自动产生。 -
• Verilator 中没有“后台线程”自动翻时钟。 -
• 必须由用户在 main()中手动写: -
• top->clk = 0; top->eval(); -
• top->clk = 1; top->eval(); -
• 这是 Verilator 与解释型仿真器最大的使用差异之一。 -
• eval()和timeInc()的配合: -
• 一次完整“时钟周期”通常需要两次 eval():一次clk=0,一次clk=1。 -
• 每次 eval()重新计算整个电路状态。 -
• timeInc()只是标记时间轴。 -
• 只调用 eval()不调用timeInc(),仿真逻辑仍正确,只是波形时间轴上所有事件在同一时刻,不直观。
8️⃣ 常见坑对照表
📖 详细说明
-
• <=和=的区别为什么如此重要? -
• Verilog 中最容易混淆、也最影响仿真正确性的地方。 -
• <=(非阻塞)用于时序逻辑,右侧读旧值,左侧延迟写入。 -
• =(阻塞)用于组合逻辑,立即生效。 -
• Verilator 严格按语义翻译: <=生成__Vdly写入,=直接赋值。 -
• 在 always_ff中误用=,Verilator 按阻塞语义翻译,可能导致与硬件行为不一致——非常隐蔽。 -
• X/Z的缺失是 Verilator 的“原罪”: -
• 真实硬件中信号可能处于“未知”(X)或“高阻”(Z)状态。 -
• Verilator 为性能只支持二值逻辑,所有信号只有 0 或 1。 -
• 未初始化信号默认是 0,三态总线无法正确模拟。 -
• 调试这类问题建议先用 Icarus Verilog 等四值仿真器定位,再回到 Verilator 做高速仿真。 -
• initial块的有限支持: -
• Verilator 对 initial块的支持是“部分”的。 -
• 可执行一些简单初始化,但不支持复杂时序控制(如 #10延迟)。 -
• 推荐把所有 testbench 逻辑写在 C++ 中。 -
• 让 Verilog 代码只保留可综合的 RTL。 -
• 核心理念:RTL 是 RTL,testbench 是 testbench,两者分离。
🎯 一句话总结映射关系
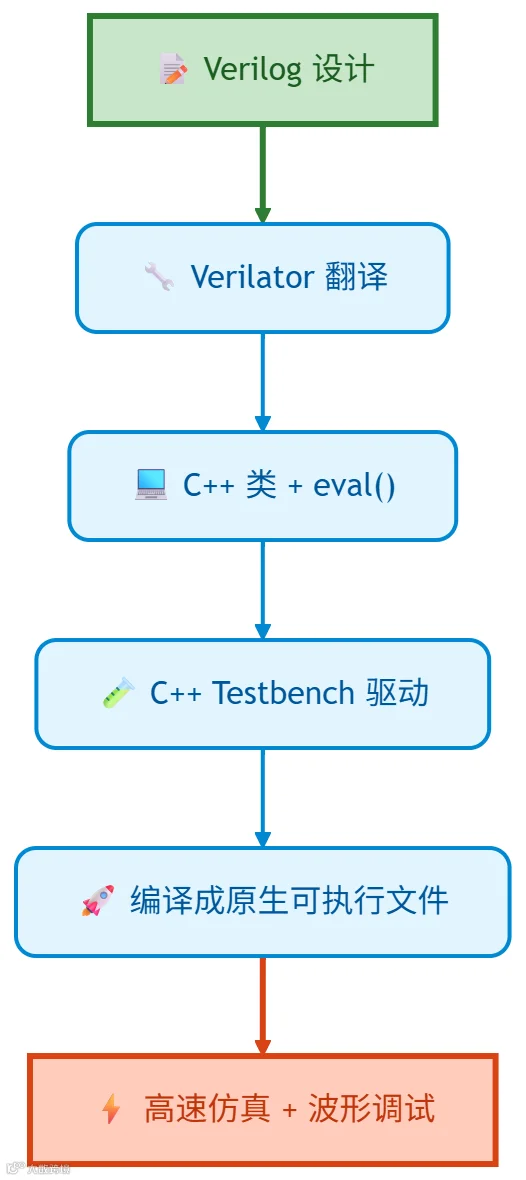
-
• 端口 → C++ 成员变量(可读可写,直接对应) -
• 组合逻辑 → eval()中的表达式 / 顺序代码(每次 eval 重新求值) -
• 时序逻辑 → 边沿检测 + __Vdly延迟变量(模拟非阻塞赋值) -
• 模块例化 → 子对象 / 内联(层级展平以优化性能) -
• DPI-C → extern "C"函数(跨语言调用,必须 C 链接) -
• Testbench → 用户 C++ main()手动驱动时钟和eval()
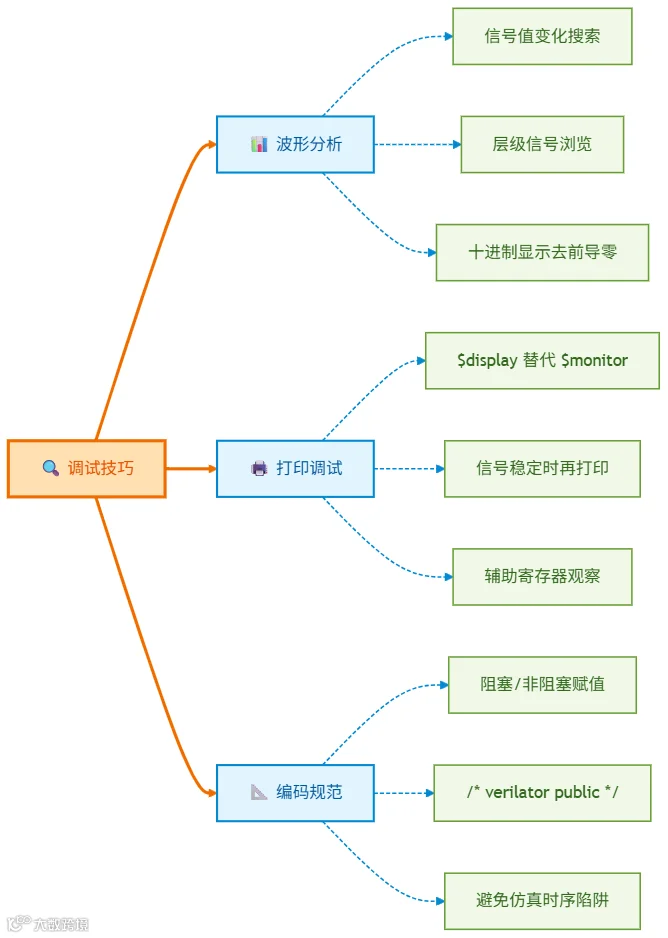
📊 波形调试:让信号“动”起来
-
• Verilator 支持生成 VCD(Value Change Dump)和 FST 格式波形文件。 -
• 可用 GTKWave 或 Surfer 查看。 -
• 生成步骤: -
1. 编译时添加 --trace选项:verilator --cc --exe --build --trace top.v sim_main.cpp -
2. 在 C++ testbench 中添加波形追踪代码: #include "verilated_vcd_c.h"
VerilatedVcdC* tfp = new VerilatedVcdC;
contextp->traceEverOn(true);
top->trace(tfp, 99); // 追踪深度
tfp->open("waveform.vcd");
// 在仿真循环中
while (!contextp->gotFinish()) {
top->eval();
tfp->dump(contextp->time()); // 每个时间步 dump 一次
contextp->timeInc(1);
}
tfp->close(); -
3. 仿真结束后,用 GTKWave 打开波形文件: gtkwave waveform.vcd -
• 关键点: -
• tfp->dump()必须在eval()之后调用,否则 dump 的是旧值。 -
• top->trace(tfp, 99)中99是追踪深度,表示追踪 99 层子模块。 -
• 设得越大,波形文件越大,但层级越完整。
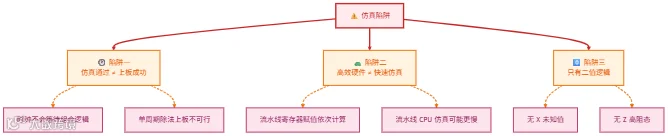
🚨 仿真中的陷阱
-
• 陷阱一:仿真通过 ≠ 上板成功。 -
• Verilator 仿真将时钟更新插入到所有组合逻辑计算完成后。 -
• 真实硬件中时钟不会等待组合逻辑完成。 -
• 仿真无法检测出时序问题。 -
• 例:单周期内完成 32 位除法的 CPU 在仿真中可正确运行,但上板几乎不可能实现。 -
• 陷阱二:更高效的硬件 ≠ 更快的仿真。 -
• 流水线技术通过段间寄存器将指令分为多个阶段并行执行,硬件效率极高。 -
• 仿真中每个寄存器赋值需要依次计算,导致“时钟周期”大大延长。 -
• 仿真环境中,流水线 CPU 处理速度可能比单周期 CPU 还要慢。 -
• 陷阱三:Verilator 只支持二值逻辑。 -
• 与 Icarus Verilog 不同,Verilator 信号只有 “0” 和 “1”。 -
• 不表示未知值 “X”。 -
• 调试未初始化信号或三态总线时需注意。
📈 性能对比
-
• Verilator 与商业仿真器相比,通常在类似或更优的性能水平上运行。 -
• 真正优势在于开源免费——预算可花在计算资源上,而不是软件许可证上,获得最佳“仿真周期/美元”比。

📝 注:以上为示意性数据。实际性能取决于设计规模、复杂度和优化程度。
❓ 常见问题(FAQ)
-
• Q:Verilator 能在 Windows 上运行吗? -
• A:可以,推荐使用 WSL2 运行 Ubuntu 环境,性能最佳。Cygwin 也可以但速度较慢。 -
• Q:Verilator 的编译为什么这么慢? -
• A:Verilator 内部会创建完整的生成仿真器状态以进行优化,可能需要较多内存。 -
• 大型设计的常驻内存集可达 64 GB 以上。 -
• 如果编译超过几分钟,检查是否在换页,考虑使用更多内存的机器或分层 Verilation。 -
• Q:如何生成波形? -
• A:添加 --trace或--trace-vcd选项。 -
• 然后在 C++ testbench 中使用 $dumpfile和$dumpvars启用追踪。 -
• Q:Verilator 支持 UVM 吗? -
• A:Verilator 对 UVM 2017 的支持仍在开发中。 -
• 需要 Verilator 5.036+ 版本配合相关配置。 -
• 基本 UVM testbench 可以编译,但运行时可能存在兼容性问题。 -
• Q:为什么 Verilator 比商业仿真器快? -
• A:大多数仿真器必须兼容完整的 IEEE 1364/1800 标准,必须是事件驱动,无法重新排序逻辑块。 -
• Verilator 更接近综合工具的视角,可以自由进行网表级别的优化。
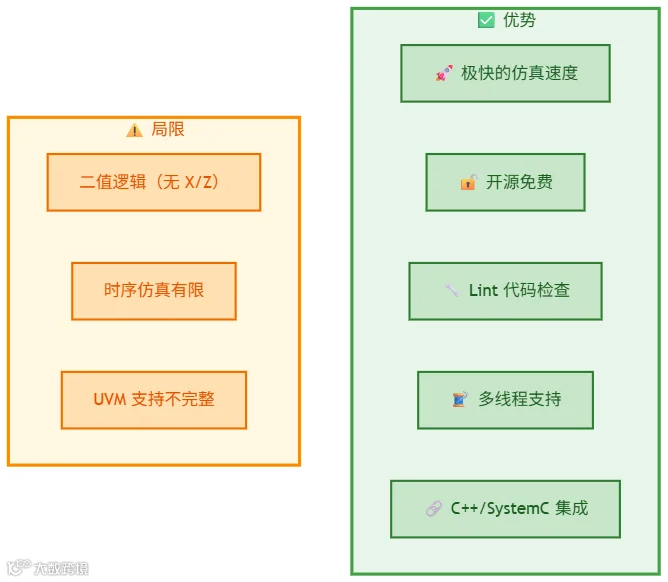
🎯 总结
-
• Verilator 是数字电路和处理器设计领域不可或缺的工具。 -
• 通过将 Verilog 编译为优化的 C++ 代码,实现远超传统仿真器的性能。 -
• 在四值逻辑、时序仿真和 UVM 支持方面有所取舍。 -
• 对于追求高速仿真和大规模设计的场景,Verilator 几乎是最佳选择。
核心要点回顾:
-
1. Verilator 将 Verilog 编译为 C++,而非解释执行,速度可提升 100 倍以上。 -
2. 工作流程分三阶段:Verilation → 编译 → 执行。 -
3. 通过 eval()方法驱动仿真,每次输入变化后必须调用。 -
4. 使用 --trace生成 VCD 波形,配合 GTKWave 调试。 -
5. DPI-C 机制实现 Verilog 与 C 函数的双向调用。 -
6. 仿真中注意时序陷阱:仿真通过 ≠ 上板成功。
📚 参考资源
• Verilator 官方文档:https://verilator.org/guide/latest/ • GitHub 仓库:https://github.com/verilator/verilator • 中科大 Verilator 使用指南:https://soc.ustc.edu.cn/CECS/lab2/verilator/ • GTKWave 波形查看器:https://gtkwave.sourceforge.net