

带有 context 的普通模型,胜过世界上最好的模型
你是否曾经围绕单个主题与 LLM 进行过一场漫长而深入的对话?从简单的 ChatGPT 到偏技术宅风格的 agentic Claude Fable,我们会发现,随着对话越来越长,回复质量会变得越来越差。
在这种情况下,我们通常会从头开始一个新对话,甚至尝试切换模型,看看另一个模型是否会更好。如果你曾经停下来想过到底哪里出了问题,那么这篇文章就是为你准备的。
无论是切换模型,还是开始一个新对话,我们这些快速解决方案本质上都只是清空了 context,然后从一张白纸重新开始!
令人惊讶的是,问题并不在模型本身,解决方案也不在于开始一个新对话。解决方案在于:每一次与模型交互时,都要工程化地设计输入给模型的内容。这门新兴学科被称为 context engineering。
预备知识
当我与 AI 社区的人交流时,我发现大家在使用一些基础术语时存在很多混淆。因此,在我们深入讨论之前,先澄清一些预备概念。
我们有 context、session、scratchpad、memory 和 context window。
Context 是模型(LLM)在一次交互中可以看到的全部信息集合。一次交互就是对模型的一次调用。它是作为输入传递给模型、用于从模型获得一次输出或响应的全部内容。你可以把它理解为发送给一次 API 调用的 “payload”。
Session。另一方面,Session 是在模型与用户之间一次完整端到端交互过程中保存的对话历史和用户特定数据。它从用户打开聊天窗口开始,一直持续到用户关闭它为止。
Scratchpad。Agent Scratchpad 允许 AI Agent 在单个 session 中记录关于当前任务和用户交互的相关信息。AI agent 是模型加上其周围所有 harness 之后的整体。
Memory。Memory 是这里的持久化层。它使 agents 能够跨 多个 session 存储和检索相关信息。它包括 Vector DB、SQL DB、文档、类似 agent.md 文件这样的指令等。
Context window/length。 它是可用于 context 的有限空间。它相当于计算机的 RAM。这就是为什么每当一个新模型发布时,我们都会看到 context length 作为规格之一。下面是 Gemma 4 模型的规格。

这个固定数字清楚地表明,context length 是有限的。
Context Engineering
现在我们已经理解了 context 及相关术语,接下来正式定义 context engineering。
Context engineering 是在 agent 执行任务的过程中,对模型的 context 进行动态构建、选择、转换和维护。
Context engineering 是一门决定哪些内容进入 context window、以什么顺序进入,以及当空间不足时要删减哪些内容的学科。Context window 几乎总是有限的。从 2024 年约 128k tokens 的 LLM context window,到 2026 年的 1M tokens,我们已经取得了很大进展。但更大的 context window 并不总是更好。稍后我们会看几个单纯增大 context window 所带来的问题。但现在,先看看为什么 context 很重要。
等等,为什么 context 很重要?
在短短 2–3 年里,我们已经走了很远。我们不再只是做 prompt engineering、问一些简单问题。我们已经从简单的 LLM 发展到了 AI agents。Agents 基于任务和目标工作。作为程序员,我以前会问 LLM:“帮我写一个函数,用来对字符串数组排序”。到了 2026 年,我会问 agent:“修复 GitHub issue #124 中的 bug”。这完全是另一种玩法。

为了响应这样的需求,agents 可以访问多个信息源和工具,如上图所示。Agents 首先设定目标,然后使用浏览器、读取文件、访问数据库,甚至管理我们的日历等工具来完成这些目标。所有这些操作都会悄悄地增加 context。
下面是一些会被添加到 context 中的内容:

Instructions - system prompts、规则、约束
User input - 当前请求、偏好、目标
Conversation history - 之前的消息和决策
Knowledge - 文档、RAG 结果、Web 内容
Memory - 用户偏好、过去经验、已学习事实
Tools - 可用工具及其描述/schemas
Tool outputs - API 或 MCP 响应、搜索结果、数据库结果
Task state - 当前进度、变量、状态
Examples - few-shot examples 和 demonstrations
Agent plans - 目标、步骤、子任务
Files & artifacts - 代码、电子表格、图片、生成的文档
Environment state - 应用状态、系统状态、实时信息
Feedback - 错误、评估、修正、之前的结果
因此,context 对 agent 来说就是一切。没有 context,agent 甚至不知道如何回答一个简单的用户特定查询。无法访问 context,就相当于绑架一个人,把他丢到沙漠中央,然后让他自己搞清楚一切。
显然,上面的列表很长,仅仅几轮消息交换就很容易导致大量信息被倾倒进 context。但把这么多信息塞进 context 会带来什么结果?正如我在前一节所说,主要会有两个问题。
1. Context rot。
我们可能会天真地认为,拥有一个巨大的 context window 是最简单的解决方案,会让 context engineering 变得微不足道。事实上,这也曾是研究社区给出的答案之一。

然而,Chroma 的一份技术报告揭示,context 是一种__具有收益递减_特性的有限资源。_ 这意味着,随着我们向 context window 中填入越来越多的信息,最终会出现所谓的 context rot。Context rot 指的是随着 context 增加,模型性能出现的不幸退化。从上图可以看出,关键并不是把 context window 填满,而是明智地选择或管理进入 context window 的有限信息。
2. Lost in the middle 问题。
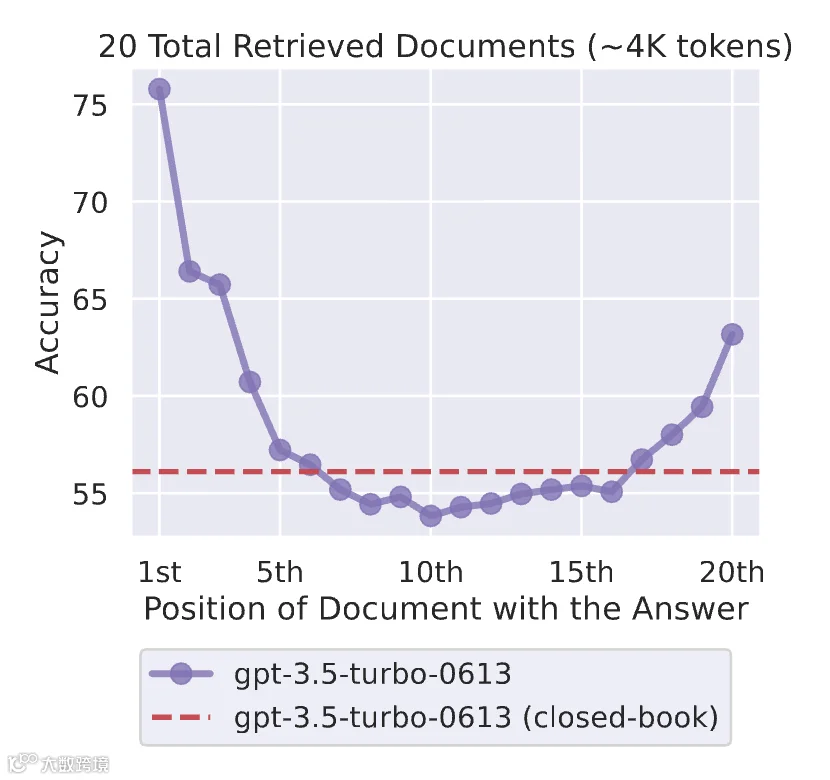
单纯用信息填满 context window 的第二个问题是 Lost in the Middle 问题。Stanford University 的一项研究发现,当相关且关键的信息被埋在长 context 的中间时,与放在 context 开头或结尾附近相比,模型表现可能会显著变差。
目标不是最大化 context。目标是最大化有用 context!
管理 Context - 4 种操作
用于管理 context 的基本操作可以分为四类。如果你是软件工程师,它们在某种程度上类似于处理 DB 时的 CRUD 操作。它们是:

Write - 创建并存储有用 context
Writing 指的是创建可供 agent 之后使用的信息,而不是把所有东西都保留在即时的 context window 中。这可能包括笔记、任务状态、计划、摘要、用户偏好或中间结果。
示例: 一个处理大型项目的 coding agent 可能会写下一条笔记,例如 “认证模块使用 JWT tokens,并且所有 API routes 都由 middleware 保护。” 这些信息可以被存储并在之后检索,而不是反复重新发现。(这类内容会被存储在 Scratchpad 中)
Select - 选择正确的 context
Selecting context 指的是判断哪些信息与当前任务真正相关,并且只把这些信息放入模型的 context。这可能涉及 retrieval systems、memory、database queries、tool selection,或对 conversation history 进行过滤。
示例: 如果用户要求 agent 修复 payment service 中的一个 bug,就没有必要提供整个 codebase。Agent 可以选择相关的 payment 文件、文档、近期错误日志,以及相关的先前决策。
Compress - 在不丢失含义的情况下减少 context
Compressing context 指的是减少模型需要处理的信息量,同时保留重要细节。常见方法包括 summarization、提取结构化信息、裁剪旧消息,以及压缩大型 tool outputs。
示例: 与其把之前的 50 条消息全部传回模型,agent 可以创建一个摘要:“用户想要一个 Python 实现,拒绝了方案 A,并决定使用 PostgreSQL。” 重要信息得以保留,而不必要的对话被移除。
Isolate - 保持 context 分离且聚焦
Isolating context 指的是为不同任务、agents 或 model calls 提供各自聚焦的 context,而不是把所有内容暴露给所有人。这可以减少干扰,防止无关信息造成影响,并让复杂工作流更容易管理。
示例: 在一个具有独立 planning、coding 和 writing sub-agents 的 coding agent 中,coding agent 并不需要完整计划。它只需要接收与其任务或前一个任务相关的技术发现和文件。
每当我们进行 context engineering 时,你所做的事情都必须归入上述 4 类之一。现在,看一个实际的 Context Engineering 工作流就很有意义了。
一个实际的 coding agent 示例
任务:“修复 app 中的 login bug #124。”
让我们看看 agent 如何解决用户分配的上述任务。Agent 首先通过 write 操作将任务状态和目标写入 context。现在 agent 需要读取 codebase,阅读代码中导入的任何 packages 的文档,甚至查看错误日志。这里会使用 select 操作。被选中的项目会进入 context。LLM 根据 context 中可用的信息进行推理。LLM 决定通过执行文件编辑来采取行动。编辑结果和测试运行结果随后会通过 compress 操作进行压缩,并写入 context,从而节省 context 中宝贵的空间。

接下来的步骤取决于我们的 agent architecture。如果架构中还有另一个 sub-agent,压缩后的 context 将通过 isolate 操作符传递给 sub-agent。这就是为什么在上图中它用虚线标记。如果 agent architecture 不支持这一点,agent 就会回到 select 操作,以继续执行后续步骤。
以上是幕后实际发生事情的极度简化版本。但它至少能让你对 context management 有一个概念。
这里的关键思想是,context management 并不是一开始就一成不变地刻在石头上的。Agent harness 会在整个任务过程中动态管理它,并一直推动任务完成。如果你不熟悉 agent harness,可以看看我之前关于 agent harness 的文章:
Agent Harness 完整指南:AI Agent 的基础设施层如何工作
Context Compression
Context compression 本身也有相当多我们还没有深入探讨的细节。但我先简单概述一下 compression 中可能发生的一些事情。
Summarization。 顾名思义,context 可以被总结并用少量 tokens 存储,而不是用几千个 tokens 存储。
Structured extraction。 与其存储一段很长的对话,仅仅存储结构化信息就可以节省大量 tokens。
Compaction。这是对持续进行中的 agent trajectory 进行周期性压缩,将其转化为更小的表示,同时保留未来工作所需的信息。
Tool result pruning。一次 tool call(例如 browser)的结果可能非常庞大。在写入 context 之前先简单提取相关信息,在这里会很有帮助。
可能会出什么问题?
最后但同样重要的是:如果某件事可能出错,它就会出错。因此,了解可能出什么问题是值得的。它们大致可以分为以下几类:
Context Poisoning - 不正确或恶意的信息进入 context,并影响 agent 未来的决策。示例:检索到的文档包含虚假指令,而 agent 将其视为可信。
Context Distraction - 过多无关信息淹没了 context 中有用的信息。示例:一个 coding agent 只需要三个文件,却给了它整个 codebase。
Context Confusion - Context 包含的信息让 agent 不清楚应该关注什么,或应该如何解释任务。示例:相互冲突的指令,或多个相似任务出现在同一个 context 中。
Context Clash - 两个或多个 context 片段直接相互矛盾。示例:一条旧 memory 说“使用 PostgreSQL”,而一个更新的项目文档说应用已经迁移到 MySQL。
结语
Context engineering 归根结底是在回答一个简单问题:为了把当前工作做好,模型现在需要知道什么?
随着 AI 系统变得更强大,agents 承担越来越长、越来越复杂的任务,单纯向 context window 中添加更多信息并不是答案。真正的挑战在于选择正确的信息,保留重要内容,移除不重要内容,并让不同任务保持聚焦。从这个意义上说,context engineering 正在变得不再只是打造完美 prompt,而是更多地关乎设计 AI 系统运行所处的信息环境。
最好的 agent 不一定是拥有最多 context 的那个。它是能够在正确的时间,以正确的形式,获得正确 context 的那个。
如果你希望看到更多动手编码类文章,请在评论中留下你的意见,我会着手准备。