

九月开学,又到了研一新生开题、研二研三推进课题的关键时期。在后台收到最多的问题之一就是:"文献越读越多,笔记越记越乱,到写论文时却找不到想要的内容,怎么办?"
今天这篇文章,我们就来系统讲讲如何用Zotero、Codex和Obsidian这三个工具,搭建一套完整的文献管理工作流——从文献抓取、摘要提取、到笔记关联、再到论文写作,全流程打通。
文末准备了《Codex+Obsidian+Zotero文献管理+精读工作流》可以跟着案例进行搭建。
为什么是这三件套?
在正式开始之前,先说说为什么选择这三个工具的组合:
Zotero是目前最主流的文献管理软件之一,完全免费开源,支持从各大学术数据库一键抓取文献元数据和PDF,自动生成引用格式。它是整个工作流的"入口"。
Codex(即Claude的代码执行环境)可以批量处理PDF文献,自动提取摘要、关键方法、实验结果等核心信息,大幅降低文献阅读的时间成本。它是工作流的"加速器"。
Obsidian则是一个强大的笔记软件,支持双向链接和知识图谱,可以将零散的文献笔记串联成网络,帮你发现文献之间的隐藏联系。它是工作流的"大脑"。
这三个工具各司其职,串联起来就形成了一套高效的文献管理闭环。
第一步:Zotero文献抓取与管理
1.1 安装与基础配置
Zotero官网(zotero.org)下载客户端,安装完成后需要做三件事:
第一,注册Zotero账号并登录,这样文献库可以在多设备间同步(免费账号提供300MB存储空间)。
第二,安装Zotero Connector浏览器插件。安装后,当你在Google Scholar、Web of Science、知网等数据库浏览文献时,浏览器地址栏会出现一个文件夹图标,点击即可一键保存文献信息和PDF到Zotero。
第三,在Zotero的"编辑-首选项-高级"中,设置数据存储位置。建议将"数据存储位置"设置在同步盘(如OneDrive、坚果云)中,这样即使Zotero免费空间用完,PDF文件也能通过网盘同步。
1.2 文献分类与标签系统
随着文献数量增加,分类管理变得至关重要。建议采用"分类+标签"的双重体系:
分类(Collections):按研究主题建立文件夹。例如时序预测方向可以分为"时序基础模型"、"异常检测"、"时空预测"、"因果推断"等几个大类。
标签(Tags):为文献打上更细粒度的标签,如"已精读"、"待复现"、"方法创新"、"数据集"、"NeurIPS 2026"等。标签可以跨分类使用,方便后续检索。
一个实用技巧是为不同重要程度的文献设置颜色标签:红色代表必读经典,黄色代表与课题强相关,蓝色代表泛读了解即可。
1.3 必装插件推荐
Zotero的强大之处在于其插件生态。以下是几个提升效率的核心插件:
Better BibTeX:自动生成并实时更新BibTeX格式的引用文件,对LaTeX用户极其友好。安装后可以为每篇文献自动生成固定的Citation Key(如Zhang2024TimeFM),在LaTeX中引用时直接用这个Key即可。
ZotFile:自动重命名和整理PDF文件。可以按照自定义规则(如"作者_年份_标题")重命名PDF,并将其移动到指定文件夹,保持文献库整洁。
Zotero PDF Translate:PDF阅读时划词翻译,对阅读英文文献帮助很大。支持多种翻译引擎,可设置快捷键。
第二步:Codex批量提取文献摘要
手动阅读几十篇文献并提取核心信息是一件耗时耗力的工作。这时候Codex就能发挥作用了。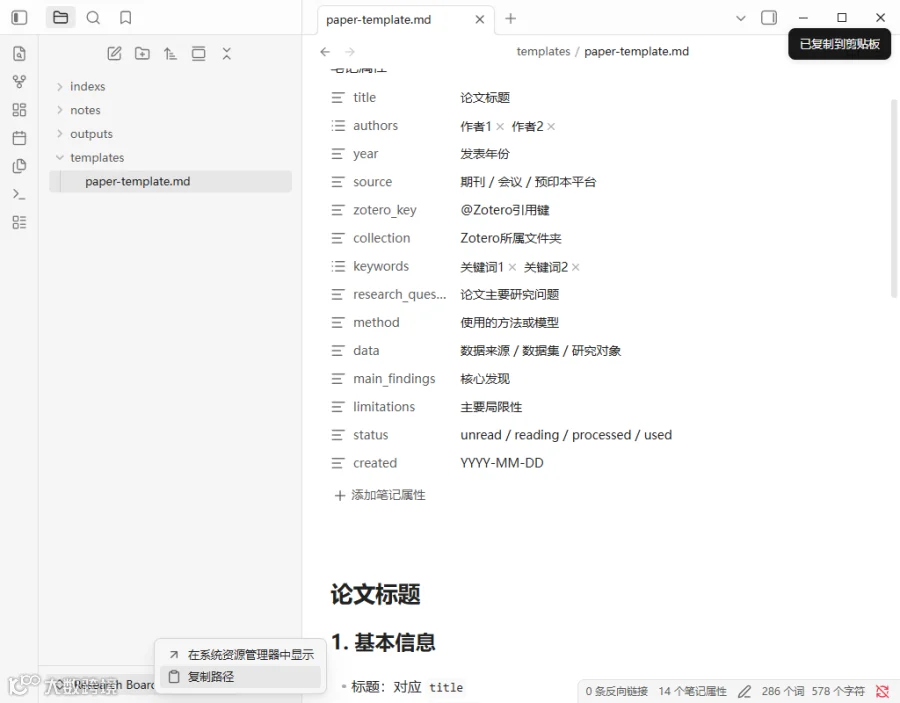
2.1 批量提取文献信息的基本流程
假设你从Zotero中导出了一个包含30篇时序预测文献的文件夹,可以用Codex编写一个简单的Python脚本来批量处理:
第一步,读取所有PDF文件并提取文本(使用PyMuPDF或pdfplumber库)。
第二步,使用Claude API或Codex的文本分析功能,对每篇文献提取以下信息:
-
研究问题与动机 -
核心方法(用1-2句话概括) -
主要实验与数据集 -
创新点 -
局限性
第三步,将提取结果整理成结构化的Markdown或CSV格式,方便后续导入Obsidian。
2.2 一个实用的Codex Skill配置
在Codex中可以配置一个"Literature Summary"的Skill,专门用于文献摘要提取。这个Skill的提示词模板大致如下:
你是一个时序分析领域的研究助手。请阅读以下论文的PDF文本,提取并总结:
1. 研究问题(1句话)
2. 核心方法(2-3句话,突出技术细节)
3. 主要贡献(3个要点)
4. 使用的数据集
5. 局限性或未来工作方向

输出格式为Markdown,便于复制到笔记软件。
配置好这个Skill后,每次只需把PDF文本或论文链接输入,就能快速得到结构化的摘要。
2.3 提取结果的质量控制
AI提取的信息不一定100%准确,建议做两个动作:
一是保留原文定位。在提取摘要时,让Codex标注关键信息来源于论文的第几页或第几节,方便回溯核心内容验证准确性。
二是人工复核关键论文。对于你课题的核心相关文献(比如打了红色标签的那些),AI摘要只能作为辅助,最终还是要自己精读并补充笔记。
第三步:Obsidian笔记关联与知识网络
文献摘要提取完成后,下一步就是在Obsidian中建立笔记网络,让这些零散的信息串联起来。
3.1 从Zotero导入Obsidian的两种方式
方式一:手动导出导入。在Zotero中选中文献,右键选择"导出条目",格式选择"Markdown"或"CSV",然后将导出文件放入Obsidian的笔记库文件夹。
方式二:使用Obsidian的Zotero Integration插件(推荐)。安装这个插件后,可以直接在Obsidian中搜索Zotero里的文献,一键生成笔记模板,模板自动包含文献的标题、作者、年份、摘要、Zotero链接等信息。
3.2 文献笔记的结构化模板
为了保持笔记的一致性,建议为文献笔记设计一个固定模板,包含以下几个部分:
# 论文标题

**作者**:
**发表于**:
**Zotero链接**:[点击跳转](zotero://...)

## 核心问题
(这篇文章要解决什么问题?)

## 方法概述
(核心技术方案,2-3句话)

## 主要贡献
1.
2.
3.

## 实验与数据集


## 个人思考
(这篇文章对我的课题有什么启发?可以借鉴什么?)

## 相关文献
- [[另一篇论文标题]]
- [[又一篇论文标题]]
最后的"相关文献"部分使用双向链接(即[[]]语法),Obsidian会自动在这些笔记之间建立连接,形成知识图谱。
3.3 利用双向链接构建文献网络
Obsidian的杀手锏功能是双向链接和图谱视图。
当你在笔记中写下[[时序基础模型]]这样的链接时,Obsidian会自动创建一个名为"时序基础模型"的笔记(如果不存在的话),并在图谱视图中显示这两篇笔记的关联关系。
随着文献笔记越来越多,你会发现某些概念(如"Transformer在时序中的应用"、"零样本预测")被多篇论文提及,这些高频节点就是你研究方向的核心概念。点击图谱中的节点,可以快速定位到所有提及该概念的文献,帮你梳理研究脉络。
一个进阶技巧是建立MOC(Map of Content)笔记,即"内容地图"。例如创建一个"时序预测方法分类"的笔记,手动整理出传统统计方法、深度学习方法、基础模型方法三大类,每类下面链接相关的文献笔记。这样就形成了一个结构化的索引,方便后续查阅。
3.4 从文献笔记到论文写作
当你需要写论文的Related Work或Introduction时,Obsidian的搜索功能就能派上用场。
假设你要写"时序异常检测"这部分内容,直接在Obsidian中搜索相关关键词,就能快速找到所有相关文献的笔记,然后按时间线或方法分类整理,形成论文的段落框架。
由于每篇笔记都包含Zotero链接,点击即可跳转到原文献,方便核对引用信息和补充细节。
总结
文献管理不应该成为科研的负担,而应该是科研的助力。Zotero、Codex、Obsidian这三件套的组合,覆盖了文献管理的完整链路:
-
Zotero负责"收集" :一键抓取文献,自动整理元数据 -
Codex负责"筛选" :批量提取摘要,快速定位核心内容 -
Obsidian负责"关联" :构建知识网络,串联零散信息
更重要的是,这三个工具都是免费或低成本的,学习曲线也不陡峭,花一两个下午就能基本掌握。
九月是开题季,也是建立科研习惯的最佳时机。与其在Word和文件夹里翻来翻去找文献,不如花点时间搭建这套工作流,让工具为你服务,把精力专注在真正重要的思考上。
《Codex+Obsidian+Zotero文献管理+精读工作流》已准备好,可直接跟着实例进行实操搭建,后台私信【B878】,和小助理免费领取吧!

B685:创新点设计与可证伪性检验Skill安装包:paper-novelty-design
B754:drawio绘图软件、skill、插件安装包和使用
B795:可编辑 PPT 生成系统安装包和使用手册
B814:ChatGPT 5.6 安装包、使用教程视频
科研小白需安装的 11 个 SKills
往期文章推荐:
GPT-6 + Zotero + Skill ,全自动完成搜索文献和分类管理
GPT-6 + Zotero + Skill,全自动生成文献综述和文章精读报告