

📝 英文题目:How does GenAI support self-regulated learning? Evidence from learners‘ questioning behavior analysis
📚 来源期刊:Humanities and Social Sciences Communications
🗓 发表时间:2026-08-07
✍ 作者:Jie Chen, Xiaonan Tian, Yu Fu, Pengfei Liu
🏆 期刊等级:JCR Q1 · 中科院 社会学2区 · SSCI Q1 · Scopus
📌 本文看点
01
生成式 AI(GenAI)
02
自主学习(SRL)
03
提问行为分析
BACKGROUND
研究背景
问题提出
生成式 AI 进课堂,一开始大家兴奋的点是「它能给每个学生配一个一对一的老师」。ChatGPT 这类 LLM 聊天机器人不是目标导向的工具,它能对话、能追问、能实时反馈,看起来天然适合支持自主学习(SRL)——学生自己定目标、自己监控进度、自己调整策略。 但「能支持」和「真的在支持」是两件事。SRL 的核心不是「拿到答案」,而是学生主动参与、判断、反思这个过程。而 GenAI 恰好有能力让学生绕过这个过程:不问过程,只要答案;不判断反馈,只接收反馈。作者把这个张力写得很清楚:GenAI 有可能让学生「engage(真正投入)」,也有可能让学生「disengage(实质退出)」——同一个工具,两种结局。 更麻烦的是研究缺口:过去研究 SRL 干预,主要靠问卷。而 SRL 本身就是「高度情境依赖」的——学生的学习动机和策略在学习过程中一直在波动,问卷是静态的,抓不到这种波动,而且还容易因为社会赞许性偏差被高估。真正的行为证据(学生到底问了什么、怎么问的)几乎没人系统做过。 所以这篇文章的问题不是「GenAI 好不好」,而是更具体的一层:在真实的 GenAI 学习场景里,学生的提问行为呈现出什么类型?这些类型随时间怎么演化?不同水平的学生用 GenAI 的方式有没有差别?
难点剖析
难点有四个,每一个都决定了「不做这一步,结论就不成立」。
(1)「SRL 到底涨没涨」不能只信问卷。本文确实做了前后测,也确实显著(p = 0.033)。但作者自己立刻补了一刀:自评测量依赖学生的回溯性回忆和主观解释,抓不到 SRL 的目标依赖性、情境依赖性特征,而且结构化题目本身就是一种暗示,学生会按「学术理想中的自己」而不是「实际的自己」来作答。所以必须再找一层不经过学生自我陈述的证据。
(2)要把「提问」和「SRL 策略」连起来,得先有一套站得住的分类。这是全文最费工的部分:作者用了混合式归纳-演绎路线——演绎端用 Bloom 认知分类学(记忆、理解、应用、分析、评价、创造六层)确定认知层级,归纳端用 Strauss & Corbin 三级编码(开放编码 → 主轴编码 → 选择编码)去捞出框架没覆盖到的本土类型。最终从 31 个开放编码 → 12 个主轴编码 → 收敛成 6 种提问类型,每一步都要在作者之间对齐。
(3)编码信度不能自说自话。两位研究者独立编码 20% 的对话日志(17 份),用 NVivo 12 的 Code Comparison Query 算一致性,得到 Kappa = 0.81;所有分歧由全体作者讨论到共识。因为「这句话算 Analysis 还是 Apply」这种判断,没有信度系数就只是一家之言。
(4)「不同水平的学生」这个说法很容易做成循环论证。本文的处理是:用课程成绩作为 SRL 熟练度的代理指标(项目作业占 60% + 期末考占 40%),按均值与标准差切三组——高分组 90.4–93.4 分(11 人)、中分组 85–89.5 分(10 人)、低分组 74.4–84.6 分(7 人)。代价是:这个切分本身依赖成绩,所以「高分组提问更高级」这件事,只能读成关联,不能读成因果。
理论脉络
三条线被拼在一起,各自负责一块:① SRL 的三阶段循环框架(Zimmerman 2000/2002;Pintrich 2002)——负责「看什么」。Zimmerman & Moylan (2009) 的社会认知模型把 SRL 描述为 forethought(事前筹划)→ performance(执行)→ self-reflection(自我反思)三个迭代阶段,并把动机变量和元认知过程接进来;Pintrich (2002) 则按认知、元认知、资源管理、动机信念四类策略展开。本文在 Table 1 里把两者合起来,整理出三阶段 × 三域的 12 个典型 SRL 策略:例如事前筹划阶段的「复述(认知)/目标设定与计划(元认知)/任务价值激活(动机)」、执行阶段的「精加工、组织、批判性思维(认知)/监控、策略调整(元认知)/动机调节(动机)」、反思阶段的「复习(认知)/自我评价(元认知)/自我满意度(动机)」。
② Bloom 认知分类学(Bloom 等 1964)——负责「怎么给问题分层」。六个层级(记忆、理解、应用、分析、评价、创造)作为演绎端框架,用来判断一个提问处于哪个认知深度,从而看出学生的提问会不会从「Remember」往「Apply / Analysis」走。
③ 过程性测量传统(trace data / 日志数据)——负责「证据从哪来」。过去的 SRL 测量分两支:离线自评(MSLQ、OSLQ 等问卷)好处是便宜、可规模化,坏处是静态、有偏差;在线过程性测量(出声思维、系统观察、计算机日志追踪)能抓到动态过程,且追踪数据反映的是真实行为,而不是学生可能有偏的感知和记忆,在数据真实性上有明显优势,已有研究发现追踪数据比自评更能解释 SRL 行为及其对成绩的影响。但它有个长期难点:怎么把日志里的一串行为映射到具体的 SRL 过程,得有一套站得住的理论模型来翻译。
④ GenAI 恰好补上了最后这块缺口。GenAI 的交互是自然语言的,会生成并不断精炼内容,因此对话过程本身就是极丰富的追踪数据——提问的上下文、来回追问的轮次、每轮问法的变化都被完整留下来了。「学生问了什么」是一个可以直接观察、可以用分类框架翻译成 SRL 策略的行为指标。这就把「SRL 怎么测」从「问学生」推进到了「看学生做了什么」,也构成了本文核心的方法论主张。
METHOD
研究方法
理论模型
这是一篇混合方法研究,没有路径模型,但有一张三阶段 × 三域的 SRL 框架表(Table 1)和一套六类型提问分类框架(Table 3)。后者是全文真正的分析模型。 一、理论骨架:SRL 的阶段 × 域(Table 1,源自 Zimmerman 2000 与 Pintrich 2002) | 阶段 | 认知域 | 元认知域 | 动机域 | | --- | --- | --- | --- | | Forethought 事前筹划 | 复述(重复激活已有知识) | 目标设定与规划 | 任务价值激活 | | Performance 执行 | 精加工、组织、批判性思维 | 监控、策略调整 | 动机调节 | | Reflection 反思| 复习 | 自我评价 | 自我满意感 |这三个域,被本文落成了三个可观察的行为入口: -认知域→ 提问类型的认知层级演化(Remember → Apply / Analysis); -元认知域→反思型提问的内容(学生会不会去质疑 GenAI 给的东西); -动机域→提问的数量与类型丰富度(坚持追问还是掉头走开)。二、核心分析框架:六类提问(Table 3),按认知深度从低到高排列| 类型 | 定义 | 典型例子 | 对应 SRL 域 | | --- | --- | --- | --- | |Remember 记忆| 问基本概念、术语定义、需要回忆的操作步骤 | 「Console 窗口在哪?」「怎么加背景音乐?」 | 认知 | |Prompt 索取| 直接要可执行代码片段、代码修正、功能实现方案 | 「销毁游戏预制体的代码」「给角色加键盘移动控制」 | 认知 | |Analysis 分析| 追问技术现象背后的原因、机制、根因(why / how 型) | 「角色撞到之后为什么会掉下去?」「相机渲染为什么会糊?」 | 认知 | |Apply 应用| 在具体场景里实现功能或解决操作问题(「怎么实现」型) | 「Unity 里怎么实现画中画?」「进房间自动触发动画的步骤」 | 认知 | |Reflective 反思| 持续追问、批判性思考 GenAI 给出的答案 | 「我用 AI 生成的代码让物体动起来了,但我其实不懂这段代码是什么意思?」 |元认知| |Irrelevant 无关| 与课程目标或学习任务无关(技术杂问、闲聊、别的科目) | 「推荐几个好玩的 VR 游戏」「怎么装 Python?」 |动机|三、这张框架的「模型意味」在哪-它是一个翻译器:把「学生问了一句话」这种表层行为,翻译成「他在用哪一层的 SRL 策略」。这是本文最实的方法论贡献——因为它把 SRL 从「学生自己报告的抽象状态」变成了「可从日志直接观察的行为证据」。 -它自带一个可检验的演进假设:认知型提问(Remember / Prompt / Apply / Analysis)按 Bloom 层级排序,因此如果 GenAI 真的在促进认知策略发展,就应该看到提问分布从低阶往高阶漂移。这就是 RQ2 的时间演化分析要验的东西。 -它给出两个「缺口探测器」:Reflective 提问的频率 = 元认知是否被激活;Irrelevant 提问的频率 = 动机调节是否失效。全文最有冲击力的两个数字(0.5% 和 19.3%)就是这两个探测器报出来的。 - 注意它不宣称因果:作者反复强调这是关联性证据(“This correlational finding suggests that…”),并明确说「需要更大样本和对照实验才能建立因果」。这也是本文最重要的自我设限。
研究问题与分析框架
本文是 RQ 驱动、无任何 H 编号假设,三个研究问题逐条对应三层分析。 RQ1:在 GenAI 辅助的计算机课程任务中,会出现哪些类型的学生提问?这些提问如何反映认知、元认知、动机三个域的 SRL 策略? - 对应分析:混合式归纳-演绎编码,产出六类型框架(Table 3)+ 类型分布统计(Table 4)。 RQ2:在 GenAI 辅助学习过程中,学生提问行为的演化如何体现 SRL 的发展? - 对应分析:① 前后测 SRL 问卷配对样本 t 检验;
② 8 次课程日志的提问类型时间演化(Table 6–7、Fig. 3)。 RQ3:不同 SRL 熟练度分组的学习者,与 GenAI 的互动行为有何差异? - 对应分析:以课程成绩为 SRL 熟练度代理,分高 / 中 / 低三组做提问类型的矩阵编码对比(Table 8)。 贯穿全文的三条预期方向(作者的初始推理) - ① 认知域应该会涨:GenAI 的即时反馈和迭代追问,理论上支持从「直接要答案」走向「组合式问题解决」。 - ② 元认知域可能不会自动涨:作者引用了 Fan 等 (2025) 的「元认知惰性(metacognitive laziness)」概念来预判这一点——外部脚手架如果不专门设计来激活深层 SRL 过程,就激活不了(Winne 2018)。 - ③ 动机域会出现波动:GenAI 的聊天属性本身就可能把学生从学习目标上带偏(比如「推荐好玩的 VR 游戏」)。 一个必须指出的判断:上述三条不是形式化假设,而是研究问题背后的预期方向。因此本文的分析逻辑不是「提出假设 → 检验假设」,而是先建分类框架、再看行为分布与演化、最后做分组对照——三步逐层推出结论,没有 H 编号。
分析策略
分析路线五步:混合编码建框架 → 分布统计 → 前后测配对检验 → 时间序列演化 → 分组矩阵编码。 ① 提问编码:混合式归纳-演绎 + 三级编码-路线:Clarke & Braun (2017) 主题分析框架的六步(熟悉数据 → 编码 → 主题分析 → 数据缩减 → 解释 → 验证),但作者明确声明目标是系统分类而非建构新理论,因此不同于扎根理论。 -演绎端:Bloom 认知分类学(Bloom 等 1964)作为先验框架,判断提问的认知层级。 -归纳端:Strauss & Corbin (1990) 三级编码捞出框架未覆盖的本土类型。 -开放编码:逐词比较对话,提取核心特征。例如「How do I create a new animator controller in Unity?」被标为「新操作」特征;「Can GenAI write a course paper for me?」被标为「生成式任务请求」。 -主轴编码:把特征与问题性质连起来。「新操作」→「基础技能调用」;「生成式任务请求」→「潜在的任务回避」。 -选择编码:收敛成正式类型。前者归为Remember(需要事实回忆),后者归为Irrelevant(偏离学习目标)。 -收敛路径:31 个开放编码 → 12 个主轴编码 → 6 个核心提问类型(Remember、Prompt、Analyze、Reflect、Apply、Irrelevant)。工具:NVivo 12。② 编码信度的做法(值得单独记)- 两位研究者独立开放编码 20% 的对话日志(17 份); - 用NVivo 12 的 Code Comparison Query算一致性,Kappa = 0.81; -所有分歧由全体作者讨论至共识; - 全体研究者通读84 份对话日志(每人 3 份),并进行了5 轮协调讨论直到达成共识; - 最后一轮做成员核查(member checks)+ 迭代讨论 + 共识建构,以保证可信度(Glesne 2016)。③ 前后测:配对样本 t 检验 - 用 SRL 量表在课程前后各测一次,配对比较(N = 30)。 - 作者的处理很关键:先报结果,再自己指出这条证据的局限(自评、回溯性回忆、社会赞许性),然后用日志分析做三角验证。 ④ 时间演化分析(把日志按 8 次课切段) - 数据采集日:11.16、11.21、11.23、11.28、11.30、12.5、12.12、12.14(2024 年 11–12 月)。 - 按每次课统计三个量:参与提问人数、提问总数、提问类型的数量(Table 6);再按六类型逐次统计(Table 7);并画成六面板散点图(Fig. 3,横轴时间、纵轴学生编号、点表示该学生该周提问次数)。 - 三个阶段划分:早期(第 1–2 周,以回忆为主)→ 过渡期(第 3–5 周,Apply / Analysis 型复杂提问出现)→ 成熟期(第 6–8 周,提问数量与复杂度趋于稳定)。 ⑤ 分组矩阵编码(Table 8) - 分组依据:课程成绩(项目作业 60% + 期末考 40%)。 - 切组方式:按均值与标准差,高分组 90.4–93.4 分(11 人)、中分组 85–89.5 分(10 人)、低分组 74.4–84.6 分(7 人)——合计 28 人(另有 2 人未进入分组分析,这也是「84 份日志 = 28 人 × 3 次」的来源)。 - 做法:用 NVivo 12 对三组学生的提问行为分别编码,得到「提问类型 × 学习表现」的矩阵。 ⑥ 一处必须说明的数据口径 - 全文出现两个对话量数字:摘要与讨论写「786 段学习者-GenAI 对话」,而 Table 4 的编码总量是 393 个提问。二者不矛盾但口径不同:393 是被编码为「提问类型」的问题条数,786 是对话(问答)轮次量级。本文所有百分比(如 Prompt 45.3%、Reflective 0.5%、Irrelevant 19.3%)的分母都是 393。
DESIGN
实验设计
数据收集
8 周纵向嵌入式混合方法设计,单组准实验(无对照组),数据来源是「问卷 + 平台日志 + 半结构化访谈」三合一。 一、课程与情境-课程:《虚拟现实技术》,教育技术学专业本科的素质教育选修课; -课时:8 周共32 学时,项目式学习; -教学路径:每个项目都是「教师先讲解示范 Unity 开发基础 → 学生基于理解、用 ChatGPT 辅助独立完成项目」; -学生任务:每人独立完成3 个 VR 应用,并把应用 + 与 ChatGPT 的对话日志一并提交到课程平台; -三个项目:「My Cabin」、「Cabin Treasure Hunt」、「AR Happy Word Memory」; -课程评分标准:界面美观、交互设计流畅、创意性、功能完整性。二、研究流程三阶段(Fig. 1)-阶段 1|第 1 周:前测——课程开始前测学生的技术背景与 SRL 量表基线与 SRL 量表; -阶段 2|第 2–7 周:教学 + 三个项目——教师示范 GenAI 工具的用法,学生在每个项目完成后导出对话日志; -阶段 3|第 8 周:后测——SRL 量表重测 +随机抽取 15 名学生做半结构化面对面访谈,了解他们对使用 GenAI 工具的感受。三、GenAI 使用环境(控制变量的做法很干净)-平台:作者自部署的开源项目 AIchatOS——基于 OpenAI 提供的开放 API 开发,做成一个功能独立的网站; -模型:GPT-3.5 架构; -关键控制:所有学生使用同一平台、同一模型版本,并在受监督条件下使用——目的是排除「不同工具/不同版本」带来的混淆; -使用设计:教师先示范基础提问技巧(写清 prompt、追问细化),随后鼓励学生自主探索,不设强制任务、不预设 prompt,以模拟真实问题解决场景。作者明确说明了这个权衡:半结构化是为了在不人为限制互动行为的前提下,保证学生具备使用 ChatGPT 的基础能力。四、日志采集与清洗- 平台保留学习者与 GenAI 的完整对话内容; - 每完成一个项目,研究者指导学生从平台导出 CSV(个人问题与对话); - 研究者再用Python 代码把 CSV 转成 Word 文件,顺序为「日期 → 时间 → 用户提问 → ChatGPT 反馈」; -采集节奏:每完成一个 VR 综合项目采集一次,2024 年 11 月与 12 月共采集三次,覆盖 30 名学习者; -实际分析样本:786 段学习者-GenAI 对话,其中393 个提问被编码归类;编码核对时通读84 份对话日志(每人 3 份,对应 28 名有成绩分组的学生)。五、声明与信息公开度(本文只有两段,需如实说明)-数据可得性声明:匿名化数据集未存入公共仓库,理由是保护参与者-GenAI 对话的机密性(隐私与伦理限制);可依合理请求向通讯作者索取,用于验证与学术合作。 -利益冲突声明:作者声明无利益冲突。 -⚠️ 一处信息缺口:本文(Article in Press 版本)没有单列的伦理审批声明,也没有知情同意说明,同时未见基金资助与致谢段落——而本文使用了真实学生的对话日志与成绩数据,这两项声明的缺席是正式发表版应当补齐的部分(撰写者按:这一点值得留意,尤其考虑到数据涉及师生关系下的学生行为记录)。
研究样本
样本很小,但画像非常清楚——这也是本文作者自己反复强调的边界。 一、参与者(N = 30)-30 名大四本科生,来自中国某大学,同一班级(同质性学术背景); -性别:16 男 / 14 女; -年龄:19–22 岁,M = 21.04,SD = 0.57; -专业:教育技术学——数字素养高、计算机熟练,作者认为这使他们能快速适应使用 GenAI 辅助解题的课堂; -样本量来源:作者说得很坦率——样本量由《虚拟现实技术》这门课的选课容量决定,不是事先的功效计算; -GenAI 经验:干预前做过技术背景问卷,确认全部参与者都是 GenAI 新手,此前没有把这类工具整合进正式学习活动的经验。二、分组分析子样本(N = 28)- 依据课程成绩(项目作业 60% + 期末考 40%),按均值与标准差切三组: -高分组:11 人(成绩 90.4–93.4 分,占 39.3%) -中分组:10 人(成绩 85–89.5 分) -低分组:7 人(成绩 74.4–84.6 分) -成绩分布近似正态(作者说明),这是能按均值±标准差切组的前提。 -⚠️ 口径提醒:11 + 10 + 7 =28,而非 30。有 2 名学生未进入分组分析(这也是「84 份日志 = 28 人 × 3 次」而非 90 份的原因)。论文正文没有单独解释这 2 人的去向,是这篇(Article in Press 版本)在报告完整度上的一个小缺口。三、访谈样本-随机抽取 15 人做半结构化面对面访谈(占样本一半),用于了解使用 GenAI 工具的学习感受。四、样本的三层限制(作者自己列了前两条)-情境特殊:VR 开发教学场景,技术性任务本身就会放大某些提问类型(如 Apply),同时压制另一些(如 Reflective)——这一点直接影响结论能否推广; -文化与专业单一:中国一所大学、教育技术学单一专业,限制了在更广文化教育情境下的推广性; -规模小:作者在结果部分直接写「这些发现鉴于样本量(N = 30)是初步的」,并在讨论里反复用 tentative(初步的)、preliminary(前期的)来限定措辞。
测量工具
三件工具:一份 SRL 量表、一套编码框架、一个自部署的对话平台。 一、SRL 量表(前后测)-来源:Pang (2003) 量表的改编版——作者选它是因为该量表在中国青少年样本中同质性高、内部一致性高,原始 Cronbach‘s α = 0.929; -结构:共20 个题项,反映学生对 SRL 的态度,含4 个维度: -元认知(7 题)——样题:「在使用 ChatGPT 学习时,我会通过问自己问题来加深对所学内容的理解」(这句样题最能体现量表已被改写进 GenAI 情境); -认知投入(4 题); -动机信念(6 题); -资源管理(3 题)。 -计分:5 点量表,1 = 非常不同意 → 5 = 非常同意,得分越高代表 SRL 能力越强; -本研究信度:Cronbach’s α = 0.887(作者写「量表在本研究中的信度得到确认」)。二、编码与质控工具-NVivo 12:全部编码工作的载体; -Code Comparison Query(NVivo 12 内置):用于计算两位编码者的一致性,产出 Kappa = 0.81; -先验框架:Bloom 认知分类学(用于演绎端分层); -归纳规程:Strauss & Corbin 三级编码(开放 / 主轴 / 选择); -主题分析规程:Clarke & Braun (2017) 六步法; -三角验证:自评问卷 × 日志行为数据两种方法互补(作者引用 Rovers 等 2019 与 Du 等 2023 来论证这种组合的合理性)。三、GenAI 平台-AIchatOS:作者自部署的开源项目,基于 OpenAI 开放 API 开发,封装成一个功能独立的网站; -底层模型:GPT-3.5 架构; -关键能力(为研究服务):平台会保留学习者与 GenAI 的完整对话内容,且支持按学生导出——这是「用日志研究 SRL」的技术前提; -采集后的处理链:平台导出CSV → Python 转 Word,字段顺序固定为日期 / 时间 / 用户提问 / ChatGPT 反馈。 -📌 一个值得学的设计思路:作者没有用现成的 ChatGPT 网页版,而是自部署一个把日志留存做进去的平台。这样「行为数据」就不是副产品,而是从设计之初就被保证拿得到的。做类似研究的人都该抄这一手。四、成绩数据(分组依据)-项目作业成绩(60%)+ 期末考试成绩(40%),构成本文用于划分 SRL 熟练度分组的课程总评。
RESULTS
结果与分析
编码信度与量表信效度
先给判断:本文的「可信度」不靠样本量(N=30、无对照组),而靠两件事——编码信度做扎实了,以及作者把每条证据的边界都自己标出来了。 (1)编码信度:Kappa = 0.81- 两位研究者独立开放编码 20% 的对话日志(17 份); - 用 NVivo 12 的Code Comparison Query计算一致性,Cohen‘s Kappa = 0.81(属「substantial 实质一致」区间); -全部分歧由全体作者讨论到共识,不是简单多数票; - 全体研究者通读 84 份对话日志(每人 3 份),进行5 轮协调讨论; - 最后一轮做member checks + 迭代讨论 + 共识建构(Glesne 2016)。(2)量表信度:Cronbach’s α = 0.887- 量表原始版本(Pang 2003)α = 0.929,本研究改编并置入 GenAI 情境后α = 0.887,仍在可接受区间。(3)编码收敛路径(可追溯性)-31 个开放编码(Labels A1–A31)→ 12 个主轴编码(Nodes B1–B12)→ 6 个核心提问类型(Nodes C1–C10 汇总)——完整过程在Table 2逐条列出。 -这是本文最扎实的一张表:每个类型都能回溯到具体的原始提问例子。例如 Remember 来自「How to control / Where to find / How to create / How to import」;Irrelevant 来自「Can you use AI technology in the classroom」这类偏离学习目标的提问。(4)三角验证(本文方法上的核心主张)-自评问卷 × 日志行为两条证据线互相校验: -问卷说:SRL 显著提升(p = 0.033); -日志说:认知策略确实在涨(提问复杂度上升、类型丰富度 1.2 → 3.7),但元认知几乎没动(Reflective 0.5%)、动机在漏(Irrelevant 19.3%)。 - 作者的处理值得记:没有让问卷的「显著」盖过日志的「缺口」,而是并排放、明确说问卷有回溯偏差、用日志补上。(5)须一并说明的稳健性边界(作者自陈)-无对照组:单组准实验,作者明写「缺乏对照组使因果推断需要谨慎」,未来需要 GenAI 支持组 vs 传统学习组的对照比较,以「把技术效应与成熟效应或教学效应分开」; -样本量小:N = 30,作者在结果部分即写「这些发现是初步的(preliminary)」; -8 周时长偏短:可能未捕捉到解题能力的完整发展轨迹; -情境单一:VR 开发教学 + 教育技术学单一专业 + 中国一所大学;且技术性任务本身可能放大 Apply、压制 Reflective; -分组变量的内生性:用成绩作 SRL 熟练度代理,因此分组差异只能读成关联,不能读成因果。(6)一处数据口径问题(我核出来的,供参考)- 讨论 5.2 节写「低阶认知提问(Remember/Prompt)占比从 38% 降到 11%、高阶(Apply+Analysis)从 7% 升到 26%」;但用Table 7 的逐次数据反算(如首次 11.16:Remember+Prompt = 15/24 =62.5%,Apply+Analysis = 6/24 =25.0%;末次 12.14:Remember+Prompt = 44/66 =66.7%,Apply+Analysis = 13/66 =19.7%),与该组数字对不上,且末次的高阶占比反而下降。另「Analysis 总体 6.8%」与 Table 4 反算的23/393 = 5.9%也不一致。方向性结论(认知策略在演化、元认知未跟进)不受影响——因为它是靠三阶段定性划分 + 类型数量 9→36→21 的倒 U 型趋势支撑的——但这两组百分比不宜直接引用。
核心发现:提问类型、时间演化与分组差异
RQ1:六类提问的分布 —— 认知被喂养得很好,元认知几乎空白
提问类型分布(N = 393 个提问 / 30 名学习者,Table 4) — Prompt 178 个(45.3%,28 人问过);Apply 92 个(23.4%,20 人);Irrelevant 76 个(19.3%,12 人);Analysis 23 个(5.9%,11 人);Remember 22 个(5.6%,12 人);Reflective 仅 2 个(0.5%,仅 2 人) → 元认知几乎未被激活
最刺眼的两端 — Irrelevant 占 19.3%(例如「推荐好玩的 VR 游戏」)说明聊天属性会把学生带离学习目标;Reflective 占 0.5% 说明学生极少去质疑 AI 给的方案 → 与 Fan 等 (2025) 的「元认知惰性」现象一致
RQ2:时间演化 —— 前后测显著,但缺口没被补上
前后测配对样本 t 检验(N = 30,Table 5) — 前测 M = 3.550, SD = 0.358;后测 M = 3.668, SD = 0.342;t = −2.303, p = 0.033 → 显著提升(但来自自评)
参与度呈「慢启动」非线性增长(Table 6) — 提问人数 5 → 3 → 7 → 18(第 4 次,占 64%)→ 10 → 17 → 16 → 13;提问总数 24 → 29 → 32 → 67 → 21 → 89 → 65 → 66 → 学生需要 2–3 周才把 GenAI 真正整合进学习流程
提问丰富度呈倒 U 型(Table 7) — 单次课出现的提问类型数 9 → 9 → 13 → 30 → 15 → 36 → 26 → 21(峰值 36 落在 12.5);人均提问类型数从 1.2 升到 3.7 → 部分学生在掌握基础后出现「平台期」
认知层级在演化(三阶段) — 早期(W1–2)低阶提问占 62.5%;过渡期(W3–5)Apply 峰 32.6%、Analysis 峰 9.0%(均在 12.5);成熟期(W6–8)数量与复杂度趋稳 → 提问从 「How to make character move?」 演进到 「In Unity 2022, how to implement third-person character controller with Cinemachine camera follow and NavMesh obstacle avoidance?」
两个持续存在的缺口 — Reflective 提问全程仅 2 次,且出现很晚(12.5 之后);Irrelevant 在 11.21 异常飙到 58.6%(17/29),12.5 再冲到 27.0%(24/89) → 前者是元认知未启动,后者是初期工具误用 + 任务压力下的分心
Prompt 始终主导 — 均值 54.6%,在 11.28 达到峰值 59.7%(40/67)→ 学生主要把 GenAI 当作「直接要解决方案」的机器
RQ3:分组差异 —— 没有脚手架时,差距在被拉大
高分组(n = 11,39.3% 的人)问了 57.3% 的问题 — 提问总数 225,人均 20.5 个;Analysis 17 次、Apply 56 次(低分组分别只有 6 次和 13 次);Remember 仅 6 次(不太需要基础检索);Irrelevant 只占自身提问的 14.2% → 自发地把 GenAI 当作知识整合与问题解决的伙伴
中分组(n = 10)呈现过渡特征 — 提问总数 102;Prompt 占自身 44.1%、Remember 占 8.8%;Analysis 提问为 0;全样本唯一 1 个 Reflective 提问出自这一组 → 元认知意识出现但不稳定
低分组(n = 7)出现动机失守信号 — 提问总数 66,人均仅 9.4 个(高分组 20.5 个的一半不到);Irrelevant 占自身 30.3%(全组最高);Remember 占 10.6%、Apply 仅 19.7% → 技术门槛 + 动机调节失败双重挤压
一句话总结三组差异 — 高分组用 GenAI 做「知识整合」,中分组停在「要答案」,低分组则在「掉队」——GenAI 没有自动拉平差距,反而放大了它
CONCLUSION
总体结论
研究结论
① 主结论一:GenAI 在「认知策略」上是有效的,而且这个有效性有行为证据支撑。 从 393 个提问的分布看,学生确实在做从「检索信息」到「组合式解题」的迁移——Apply 型提问 92 个(23.4%)、Analysis 型 23 个(5.9%),并且提问的技术具体度和情境意识在持续上升(从「怎么做角色移动」到「Unity 2022 里怎么用 Cinemachine 加 NavMesh 实现第三人称控制器」);人均提问类型数从 1.2 升到 3.7。这条与问卷结果方向一致(SRL 前后测 M = 3.550 → 3.668,p = 0.033),但行为数据的分量更重——因为它不经过学生的自我陈述。
② 主结论二:元认知和动机这两块,GenAI 基本没帮上忙,而且很可能帮倒忙。 393 个提问里只有 2 个反思型提问(0.5%),且出现在课程很晚的阶段——说明学生极少去质疑「AI 给的这段代码为什么对」。相反,无关提问有 76 个(19.3%),最高一次占到当次课的 58.6%。作者对此给了一条很有解释力的机制假设:「GenAI 的即时解题导向,可能打断了元认知加工天然需要的那段延迟(disrupt the natural delay required for metacognitive processing)」——反思需要时间和停顿,而 GenAI 的强项恰恰是消灭停顿。这句话值得每个用 AI 学习的人记住。
③ 主结论三(最有政策意味):没有针对性脚手架,GenAI 会拉大差距而不是缩小差距。 三组对比的差距非常具体:高分组 11 人(39.3%)问了 57.3% 的问题,人均 20.5 个;低分组 7 人只问了 66 个,人均 9.4 个。 更关键的是结构差异:高分组 Analysis 17 次、Apply 56 次;中分组 Analysis 为 0;低分组 无关提问占自身 30.3%。作者的措辞很直接——「GenAI 虽然能支持自主学习者的认知策略发展,但对缺乏针对性脚手架的其他学习者,可能会加剧既有的技能差距(may exacerbate existing skill gaps)」。
④ 方法论贡献:把 SRL 从「学生说的」变成「学生做的」。 本文最实的贡献不是结论,而是测量路径:用对话日志这种天然的追踪数据,把「提问行为」翻译成可观察的 SRL 指标。具体地说,它给出了一个可复用的三层映射:认知域 → 提问类型的时间演化(Remember → Apply/Analysis);元认知域 → 反思型提问的内容与频率;动机域 → 提问总量、类型丰富度与无关提问比例。作者同时提醒:「虽然学生的认知和元认知状态不能直接观察,但提问行为提供了可以对这些内部过程做有效推断的指标」。
⑤ 实践建议一:认知脚手架要分阶段,不能一上来就放开。 - 早期(第 1–2 周):示范式提问精炼——教学生把「怎么修这个代码」改写成「怎么解决 Unity 2022 里的 NullReferenceException」; - 中期(第 3–5 周):用任务分解推动 Apply 型提问——把「实现 AR 导航」拆成「标记检测 → 路径计算 → 3D 渲染」; - 后期(第 6–8 周):加入反思性延伸——评估替代方案,但作者补了一句:「这些效果还需进一步研究确认」。
⑥ 实践建议二:元认知必须显性设计,它不会自己长出来。 两条具体做法:引导式提问规程(如「解释一下 AI 的方案为什么有效」)和带注释的反馈练习(识别知识缺口)。关键提醒:反思型提问出现得很晚(中分组在第 5 周之后),说明这类干预需要仔细安排时机与脚手架,塞太早可能无效。
⑦ 实践建议三:动机支持要打「关键期」,而且可以实时监控。 数据指出了两个高危窗口:第 2 周(无关提问 58.6%) 和 第 6 周(27%)——分别对应初期工具误用和任务压力下的分心。作者建议尝试的手段都很轻量:同伴示范式鼓励(「有 3 位同学是这样问解决的……」)、微目标(「下一个里程碑前先完成 2 个 Apply 型提问」),并配合实时监控去主动识别需要支持的学生。
⑧ 一句话概括这篇的性格:它没有给 GenAI 下「好」或「坏」的判决,而是给出了一个可操作的分工判断——认知交给 AI 没问题,元认知和动机必须由教学设计补上;而如果什么都不补,AI 会安静地把班里的差距放大。
研究局限
作者把局限写得很直白,且专门分了一段「局限与未来研究」。 1. 8 周时间偏短:虽然 8 周提供了 GenAI 支持学习过程的初步洞见,但这个时长可能没有捕捉到学生解题能力的完整发展轨迹,也无法反映 GenAI 干预的长期持续影响。未来研究应当延长实验周期。 2. 情境高度专门化,限制推广性:研究发生在 VR 开发教育情境,样本来自中国一所大学、且全部是教育技术学专业学生,这限制了结论在更广泛或全球的教育与文化情境中的推广。作者特别指出一个机制性风险:课程的技术属性本身可能放大某些提问类型(如 Apply),同时压制另一些(如 Reflective)——这意味着「反思型提问只有 0.5%」这个发现,可能部分是任务性质造成的,而不完全是 GenAI 造成的。 3. 没有对照组,因果关系需谨慎:本文用两种方法(SRL 问卷 + 互动分析)互补,但缺乏对照组要求我们在因果推断上保持谨慎。未来研究应当纳入 GenAI 支持组 vs 传统学习组的对照比较,并使用更稳健的测量,把技术效应与成熟效应或教学效应分离开。 4. 样本量小:N = 30(分组分析为 28 人),作者在结果部分就承认发现是「preliminary(初步的)」。这个规模不足以支撑任何统计上的分组差异检验——三组差异全部是描述性对比,未做显著性检验。 5. 分组依据的内生性:用课程成绩作 SRL 熟练度的代理指标。成绩与 SRL 之间的关系本身是文献里的既有命题,用它来分组会使「高分组提问更高级」这个发现带有循环色彩——作者也未做替代指标(如直接用前后测 SRL 分数)的稳健性检验。 6. 一处报告缺口(我核出来的):分组子样本 11 + 10 + 7 = 28 人,与总样本 30 人差 2 人,论文没有单独说明这 2 人的去向;同时摘要/讨论的「786 段对话」与 Table 4 编码的「393 个提问」两个口径并列出现但未做显式说明。 7. 两组百分比与原始表反算不一致(我核出来的):讨论 5.2 的「低阶占比 38% → 11%、高阶 7% → 26%」与 Table 7 逐次数据反算不符(末次高阶反而下降);「Analysis 总体 6.8%」与 Table 4 反算的 5.9% 不一致。方向性结论不受影响,但这两组数字不宜直接引用。 8. 版本状态:本文 PDF 是 Nature Portfolio 的 Article in Press(未校样稿),正文每页带 `ARTICLE IN PRESS` 水印,Fig. 2 与 Fig. 3 均被水印覆盖而无法直接使用,正式版页码、图表编号与少量数据表述可能微调。
未来展望
作者给出的方向集中在「补上缺的那一半」——补对照、补时长、补人群、补元认知干预。
① 延长实验周期:8 周不足以看清解题能力的完整发展轨迹,需要更长期的设计来理解 GenAI 干预的持续影响,以及「平台期」之后会不会再次上升(本文已观察到一个倒 U 型的类型丰富度曲线:9 → 36 → 21)。
② 跨文化与跨学科取样:纳入不同文化背景与不同学科领域(尤其是非技术性课程)的参与者——因为本文提示任务的技术性本身可能压制反思型提问,只有换到人文社科类任务里才能判断「元认知缺席」是 GenAI 的属性,还是 VR 开发这个任务的属性。
③ 加入对照组,把效应拆开:需要 GenAI 支持组 vs 传统学习组的对照比较,并采用更稳健的测量,把技术效应从成熟效应(maturation)和教学效应中分离出来。这是全文最关键的一条——它是本文所有因果类措辞之所以用「tentative / may / suggest」的原因。
④ 探索自适应支持机制:结论部分明确写「未来研究应探索自适应支持机制(adaptive support mechanisms)以优化 GenAI 环境下的 SRL 发展」——即让工具本身能识别学生当前缺的是认知、元认知还是动机支持,并动态补上。
⑤ 把提问类型做成形成性评价指标(作者提出的延伸用法):作者设想提问类型的演化可以作为形成性评价指标,但强调还需要更多研究来确定它作为「深度学习」测量工具的可靠性。这一条如果成立,价值很高——教师就不必等考试,看提问日志就知道谁掉队了。
⑥ (我基于本文缺口补的建议): - 用前后测 SRL 分数代替成绩做分组,或至少做一次替代指标的稳健性检验,以剥离循环论证; - 把「反思型提问」单独做一次针对性干预实验——本文给出了机制假设(即时的解题导向打断了元认知所需的延迟),但没有检验过「人为制造延迟」是否真能提升反思型提问,这是最直接可做的一步; - 报告完整度上补两处:说明 2 名未进入分组分析学生的去向、统一「786 段对话」与「393 个提问」两个口径的口径说明。
金句
原文:“GenAI tends to favor cognitive strategies over metacognitive strategies unless targeted instructional scaffolding is provided.”(Chen et al., 2026) 解读:这是全文的主结论,也是它跟一大堆「AI 提升学习效果」研究拉开距离的地方。 注意它的措辞很有分寸——不是「GenAI 没用」,而是「GenAI 有偏心」:它对认知策略(拿信息、要代码、解题、查原因)几乎是自动生效的,学生不用被教就会用;但对元认知策略(我到底懂没懂?这段代码为什么对?我该不该信这个答案?)基本是失灵的,除非有人专门设计教学去激活它。它的实证依据非常具体:393 个提问里,反思型提问只有 2 个,占 0.5%。作者还借了 Winne (2018) 的说法来解释——外部脚手架如果不专门设计来激活深层 SRL 过程,它就激活不了。翻译成一句人话:AI 会替你查、替你想、替你写,但它不会替你想「我是不是真的会了」——因为那件事从头到尾都得你自己问。原文:“Drawing on Zimmerman (2002) reflection phase model, we argue that GenAI‘s immediate problem-solving focus may disrupt the natural delay required for metacognitive processing.”(Chen et al., 2026) 解读:这句是全文最有解释力的一句,也是我认为最该被记住的一句。它给出的机制不是「学生懒」这种道德判断,而是一个时间结构上的冲突:元认知加工天然需要一段延迟——你得停下来,回头看一眼自己刚做的东西,才有机会产生反思;而GenAI 的强项恰恰是消灭延迟——你一问它就答,你一答就能用,整个过程顺畅到没有任何一个「停顿点」。于是反思不是被拒绝的,而是被「优化掉」的。这个机制的漂亮之处在于它可检验:如果真是「延迟被消灭」导致的,那么人为设计停顿(比如强制要求「先解释 AI 的方案为什么可行,再动手用」)就应该能提高反思型提问的比例——而本文将这条留成了假设,没做实验。这是留给下一个研究者的一个非常明确的切口。原文:“although GenAI can support the cognitive strategy development of self-regulated learners, it may exacerbate existing skill gaps for other learners who lack targeted scaffolding support.”(Chen et al., 2026) 解读:这句话是全文最有分量的警告,而且它有一个非常具体的证据骨架。「支持自主学习者的认知策略发展」和「加剧其他人的技能差距」不是同一件事的两面,而是两个同时发生的过程:高分组 11 人(占 39.3%)问了 57.3% 的问题,人均 20.5 个;低分组 7 人只问了 66 个,人均 9.4 个——不到高分组的一半。更关键的是结构差异而不是数量差异:高分组Analysis 17 次、Apply 56 次;中分组Analysis 是 0;低分组无关提问占自身 30.3%。也就是说,AI 把「会不会用」这件事放大成了一层新的门槛:本来会自学的人拿它当思考伙伴,本来不会的人拿它当答案贩子、甚至当消遣工具。这跟「AI 促进教育公平」的乐观叙事直接冲突。而作者给的对策并不复杂:脚手架、关键期干预、实时监控——都是教学设计动作,不是技术升级。翻译成一句给老师的话:AI 不会自动拉平差距;你不管,它就替你拉大。原文:“Although learners’ cognitive and metacognitive states are not directly observable, their questioning behavior offers indicators that enable valid inferences about these internal processes.”(Chen et al., 2026) 解读:这句是本文方法论价值的浓缩,也是它最值得被抄走的一句话。它承认了心理状态没法直接看(这是所有学习研究的原罪),但紧接着给出了一个出路:提问是可以直接观察的,而且提问能有效推断内部过程。这就把研究方法从「问学生你觉得你怎么样」推进到了「看你实际做了什么」。作者选提问而不是别的东西,是因为GenAI 场景下提问有天然优势:你必须把需求写清楚它才能答对,所以提问本身就是一次思维的显影——写「怎么让角色动」和写「Unity 2022 里怎么用 Cinemachine 加 NavMesh 实现第三人称控制器」,暴露的是两个完全不同的认知加工水平。对做研究的人来说,这条路径几乎可以直接迁移到任何 AI 交互场景(写作、编程、科研、客服);对普通用户来说,它反过来给了一个自查方法——翻翻自己的 AI 对话记录,看看你问的是「要答案」还是「问为什么」,基本就知道自己在哪个水平。原文(实践落点):“Early-stage learners (Weeks 1-2) might benefit from modeled prompt refinements… During the mid-stage (Weeks 3-5), instructors could consider emphasizing Apply questions through task decomposition… By the late-stage (Weeks 6-8), encouraging reflective extensions.”(Chen et al., 2026) 解读:这段把整套理论收成了一张开给老师的、按周排的课表——这在 AI 教育研究里并不常见。它的时间线直接来自数据里那个「慢启动」曲线:前两周只有 3–7 人用 GenAI 提问,第 4 次课才飙到 18 人(64%),说明学生需要 2–3 周才能把 AI 真正接进自己的学习流程——所以第一二周不该放任,而该教「怎么问」;中期(第 3–5 周)Apply 型提问在12.5 冲到峰值 32.6%,正对应复杂项目阶段,所以此时该做任务分解;后期(第 6–8 周)才轮到反思。另外两个高危窗口也被点出来了:第 2 周无关提问飙到 58.6%、第 6 周再冲到 27.0%——分别是「初期工具误用」和「任务压力下的分心」,这两个时间点该给的不是新工具,是动机支持。一个容易忽略但很实用的细节:作者建议的干预都极轻——「同伴示范式鼓励」和「微目标」,比如「下一个里程碑前先完成 2 个 Apply 型提问」。这些都不需要买软件,改的是老师的课表。延伸解读(一个关于样本的诚实细节):这篇文章只有30 名学生,作者对此的处理方式是——在结果部分就直接写「这些发现鉴于样本量(N = 30)是初步的」,并且在讨论里几乎每一段都用 tentative(初步)、preliminary(前期)、may(可能)来限定措辞,还在局限部分主动交代「样本量是由这门课的选课容量决定的」,而不是事后编一个功效分析。在一篇结论指向「AI 会拉大差距」这种有冲击力的研究发现里,作者没有把这个结论说满——它给出的是一张行为数据的快照加一句「需要对照实验才能确认因果」。这种分寸感,恰恰是这篇能发在 Nature 旗下刊物的原因之一:数据小不要紧,边界要说清。
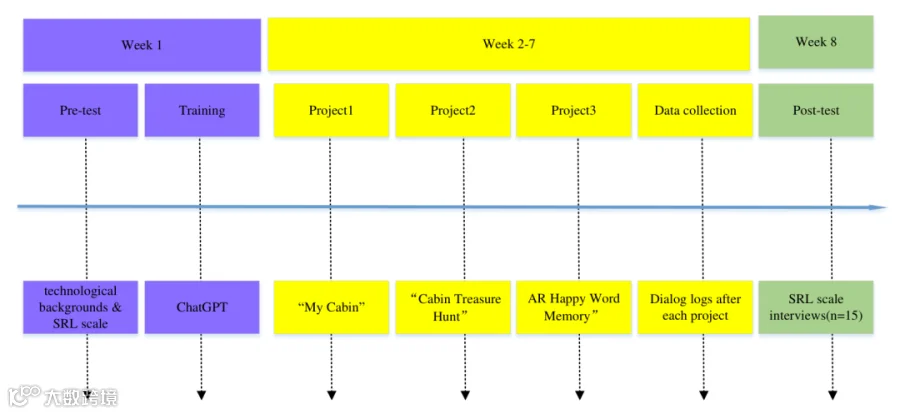
— 研究模型图
📄 摘要原文
Generative AI (GenAI), such as ChatGPT, provides an instant and individualized learning environment that has the potential to enhance students’ self-regulated learning (SRL) compared to traditional SRL interventions. However, the impact of GenAI on student SRL remains unclear, particularly regarding how educators can best support self-regulation in GenAI-enhanced learning environments. To address this question, this study conducted an 8-week longitudinal experiment with 30 Chinese university students, combining pre- and post-test SRL questionnaires with a systematic analysis of 786 learner-GenAI dialogs. Through rigorous coding, interactions were classified into six question types (Remember, Prompt, Analysis, Reflective, Apply, and Irrelevant), mapped to cognitive, metacognitive, and motivational SRL strategies, to analyze GenAI’s impact through question type distributions, temporal pattern evolution, and cross-group proficiency comparisons. The results indicated that GenAI was effective in promoting cognitive strategy development, and that learners demonstrated increasingly sophisticated questioning behavior. However, support for metacognition and motivational regulation was limited, and the distribution of question types indicated uneven development between cognitive and metacognitive strategies. Cross-group analysis further suggested that GenAI might inadvertently widen SRL skill disparities without targeted scaffolding. These findings underscore the need for balanced intervention strategies and adaptive support tools to optimize SRL development in GenAI environments.
📎 阅读原文:DOI: 10.1057/s41599-026-08610-0
END
我是扣子,高校教师/在读博士/AI顾问。关注AIGC,学术科研,博士生活;分享AI赋能和论文带读,打破AI信息差。视频号:扣子说AI。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
欢迎关注我的视频号
(❤️会不定期更新AI工具哦❤️)
三连一下,不失联!