


10 个关键 问题Q&A
- 什么是 Agent Harness 调度框架?
Harness 是运行 Agent 循环的代码层,负责执行工具调用、管控模型权限,决定智能体动作能否执行。 - Jev 模型和普通 LLM 最大区别是什么?
Jev 属于 System One 决策模型,只输出 0~1 概率值,不生成自然语言文本,成本更低、响应更快。 - Jev 在整套 Harness 里承担什么角色?
主大模型负责复杂推理、读写文件、生成回答;Jev 负责轻量快速判断:风险、任务复杂度、答案可信度。 - 三大 Jev 接入点分别在哪些时机触发?
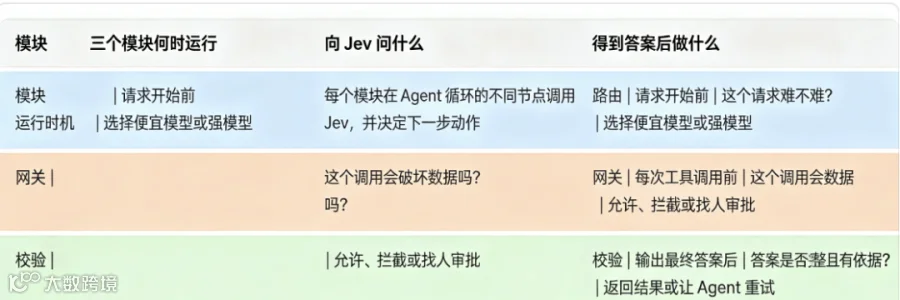
工具网关:每次工具调用前;模型路由:任务刚启动;答案校验:Agent 输出最终结果之后。 - 网关的三态策略是什么?
分数低于 askAt 直接放行;区间内人工审核;高于 blockAt 直接拦截,解决单阈值一刀切误判。 - 路由为什么只在任务开始选定模型,中途不切换?
不同模型独立缓存提示词,中途切换会丢失缓存,上下文重读成本大幅上涨。 - Fail Closed 和 Fail Open 分别怎么理解?
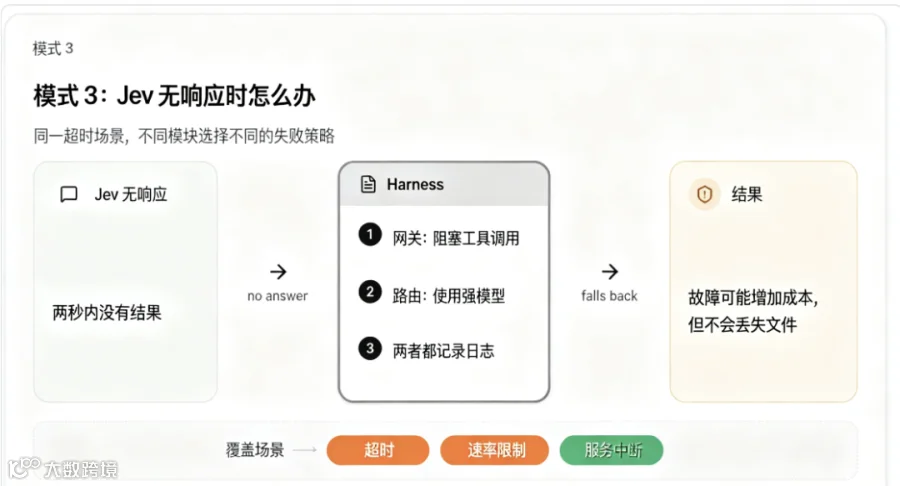
Fail Closed(网关):Jev 不可用,直接阻断高危操作,保障安全;Fail Open(路由):Jev 不可用,升级强模型保证业务继续执行。 - 安全层面,能否只依靠 Jev 做权限校验?
不能。文件路径白名单这类确定性检查必须写死在代码;Jev 仅用于主观、模糊风险判断。 - 答案校验 Verifier 解决什么 Agent 常见问题?
检测 Agent 编造无依据结论、回答缺漏,在返回用户前触发有限重试,提升结果可信度。 - 这套架构除代码智能体外,还有哪些适用场景?
代码评审、文档抽取质检、数据记录去重合并、自动化审批队列,凡是需要批量快速打分判断的场景均可使用。 




原文:Building a Custom Harness with Pi and Jev 译者注:Harness译为「运行框架 / 调度器」,是驱动智能体循环、管控工具调用的执行层;Jev 是 TypeSafe AI 推出的System One 快速决策小模型,只输出概率数值,不生成自然语言文本。
用 Pi 和 Jev 搭建自定义调度框架
AI 智能体本质上是一个在循环中工作的大语言模型:读取任务、调用工具(例如 “读取这个文件” 或 “删除那个文件”),观察工具返回结果,持续迭代直到任务完成。每当模型请求调用工具,这个请求就叫做工具调用(tool call)。
运行这个循环的代码,就被称为 Harness(调度框架)。由模型决定想要执行什么动作,调度框架负责执行动作,同时管控模型允许做哪些操作。
一个优秀的调度框架,会在执行途中做大量细碎判断:该用哪个模型处理本次请求?这个工具调用是否安全?当前结果是否足够交付给用户? 大多数调度框架的做法是调用对话大模型来回答这些判断问题,每一次判断都要消耗一次完整的模型调用。成本太高,实际场景里大部分安全校验都会被直接省略。
TypeSafe AI 推出的 Jev,是专门为这类判断场景打造的小型模型。你描述当前场景,抛出若干问题,它会用数字返回每个问题的结论,不会生成任何文本。
在搭建自定义调度框架(自研智能体循环,而非直接使用现成智能体产品)时,Jev 的价值尤为突出。自定义调度框架可以自主选择运行的模型、限定智能体可操作资源、定义任务完成标准。Jev 让这些决策校验足够廉价,每一步智能体动作都可以执行校验。
在本教程中,我们将基于 Pi(earendil-works 开源的 TypeScript 智能体开发工具包)搭建调度框架,并在三处核心环节接入 Jev。教程末尾,你可以在在线沙盒运行完整调度框架,自行修改配置参数。
交互式完整教程与沙盒地址: https://academy.dair.ai/resources/jev-decisions-in-a-pi-sdk-harness
本文灵感来自 LangChain 博客上 Sydney Runkle 的文章《Building a Harness with Jev》,文中演示了模型路由、工具准入网关作为 LangChain 中间件的现成方案。而本文将在 Pi SDK 上从零实现相同思路,额外增加故障处理、结果校验两种模式。
我们要实现什么
调度框架包含三大模块,每个模块会在智能体流程的不同节点向 Jev 发起查询,后文均沿用这三个命名。
演示案例:一个处理步道勘测笔记文件夹的智能体,每条外出记录单独存为一个文件。智能体支持读取、写入,也能真正删除这些笔记文件,这正是安全网关必不可少的原因。
Jev 是什么
TypeSafe 将 Jev 称为 System One(系统 1)模型。命名源自心理学家丹尼尔・卡尼曼提出的两套思维模式:
-
系统 1:快速、直觉式自动判断,比如本能知道铁锅很烫 -
系统 2:慢速、审慎推理,类似做复杂长除法
在这套调度框架里,常规大语言模型承担系统 2 的慢速工作:读取文件、生成答案;Jev 负责周边快速判断。Jev 足够便宜、响应足够快,能够对每一次工具调用做判断,而不是只校验预先认定的高风险调用。
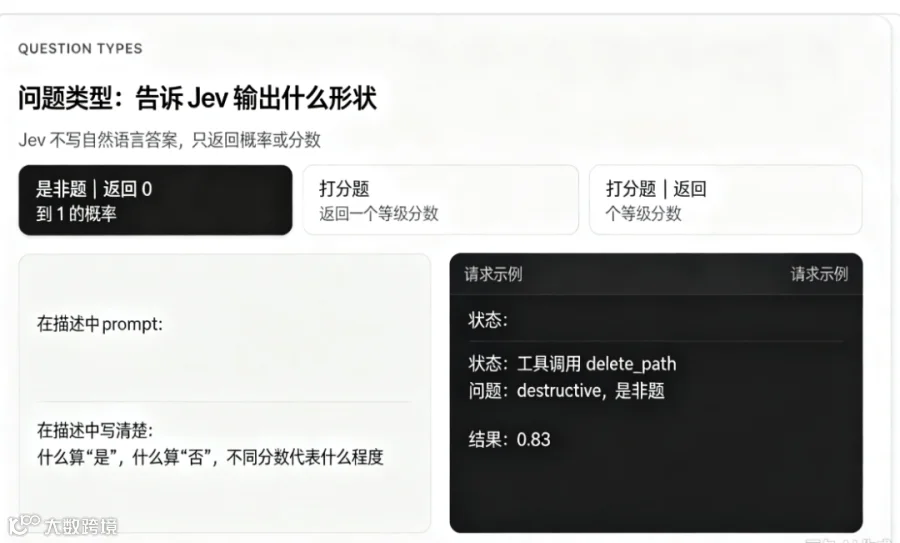
Jev 的输出是 0~1 之间的概率值: 0.83 = Jev 比较确信答案为 “是”;0.03 = 比较确信答案为 “否”。
三类问题类型
每一次调用 Jev 包含两部分:
-
状态(state):待评估场景,例如工具调用内容、用户原始请求 -
问题(questions):你想要评估的事项
一次请求可以同时提交多个问题,耗时和只问一个问题基本一致。 Jev 支持三类问题。第一种被称为 noul,即是非判断题。
Jev 只能看到你传给它的信息,你要用通俗文字描述所有选项、所有判定等级,这些描述就是提示词。
环境准备
Jev 通过 OpenRouter 接入。OpenRouter 可以用同一个 API Key 调用多款模型,这一个密钥同时支持大语言模型和 Jev。 安装两个 Pi 包并配置密钥:
npm install @earendil-works/pi-agent-core @earendil-works/pi-ai
OPENROUTER_API_KEY=...
Jev 拥有独立接口地址,和普通对话模型接口分开。调用时必须指定精确版本号,例如 typesafe/jev-1.13。完整 Jev 客户端仅为一次 fetch 请求:
const JEV = "typesafe/jev-1.13";
async function ask(state: unknown, questions: unknown) {
  const response = await fetch("https://openrouter.ai/api/alpha/decisions", {
    method: "POST",
    headers: {
      "Content-Type": "application/json",
      Authorization: `Bearer ${process.env.OPENROUTER_API_KEY}`,
    },
    body: JSON.stringify({ model: JEV, state, questions }),
    signal: AbortSignal.timeout(2_000),
  });
  if (!response.ok) throw new Error(await response.text());
  return response.json();
}
智能体等待 Jev 返回结果,接口设置 2 秒超时。正常响应耗时仅 200~400 毫秒。
Jev 的接入点位
Pi 的 Agent 类负责运行智能体循环,允许在循环的指定节点插入自定义代码。这些点位叫做 hooks(钩子)。调度框架三大模块各自使用一个钩子。
1. 基础安全网关
先实现最简可用网关:每次工具调用前,向 Jev 发起一条是非判断。如果判定风险达标,直接拦截本次调用。
import { Agent } from "@earendil-works/pi-agent-core";

const agent = new Agent({
  initialState: { systemPrompt, model, tools },
  streamFn: models.streamSimple.bind(models),
  beforeToolCall: async ({ toolCall, args }) => {
    const { answers } = await ask(
      { tool: toolCall.name, arguments: args },
      {
        destructive: {
          type: "noul",
          instructions: "本次工具调用会销毁/覆盖并非本次运行创建的数据",
          criteria: {
            true: "删除文件、截断/覆盖已有内容、丢弃数据、强制覆盖历史提交",
            false: "读取、列出文件、新建文件,或者追加写入本次运行新建的文件",
          },
        },
      },
    );

    if (answers.destructive.noul >= 0.65) {
      return { block: true, reason: "已拦截:该操作存在破坏性", terminate: true };
    }
  },
});
0.65 是阈值,即调度框架的判定分界线。Jev 输出分数 ≥ 阈值,则拦截调用。 此时,如果智能体尝试删除笔记,在删除动作执行前就会被拦截:删除操作打分约 0.83,读取文件约 0.01。 但这个基础网关比较粗糙:新建文件会打出约 0.70,同样被拦截。
调用成本极低:Jev 输入 token 单价为每百万 token $0.042,不足本调度框架所用两款模型中更便宜的 GLM 5.3 Flash 输入价格的 1/3。
从基础网关到完整调度框架
基础网关可以工作,但还有 4 个缺陷:
-
阈值硬编码在钩子内部,不方便调整、测试 -
所有请求都使用同一个模型,简单任务、复杂任务没有区分 -
Jev 服务不可用时,没有兜底处理逻辑 -
没有校验最终输出答案质量
下面 4 个章节逐个补齐缺陷。
① 将阈值统一管理
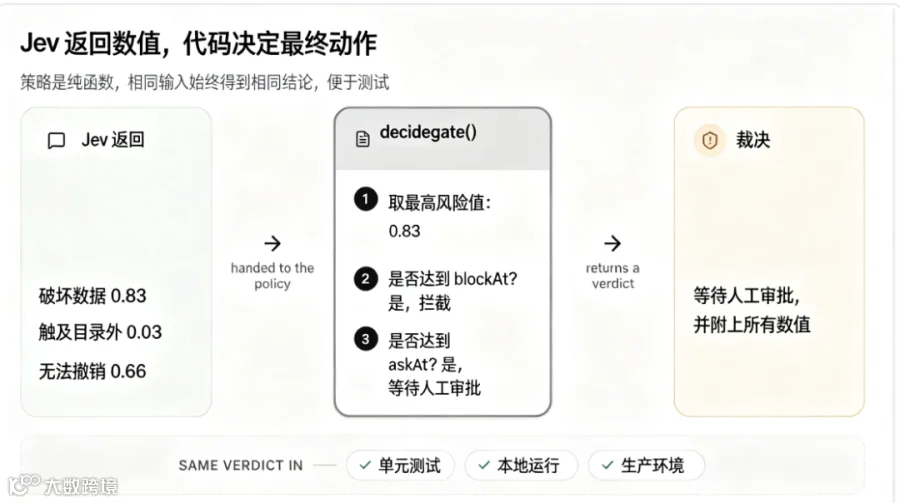
对网关做优化。阈值决定智能体可执行动作,上线后会基于真实数据反复调参。 因此把阈值从钩子中抽离,放到独立函数 decideGate()。接收 Jev 返回的各项分数,输出最终裁决。这套规则集合称为 policy(策略)。
策略增加中间状态:单阈值只能允许 / 拦截;双阈值产生三种裁决:
-
≥ blockAt:拦截调用 -
≥ askAt 且 < blockAt:等待人工审批 -
< askAt:直接放行
中间区间捕获 Jev 无法高度确信的场景,避免单阈值一刀切带来误判。
export function decideGate(signals: GateSignals, policy = DEFAULT_GATE_POLICY): GateVerdict {
  const worst = Math.max(
    signals.destructive.noul,
    signals.irreversible.noul,
    signals.outsideWorkspace.noul,
  );
  if (worst >= policy.blockAt) return { action: "block", ... };
  if (worst >= policy.askAt) return { action: "ask", ... };
  return { action: "allow", ... };
}
它只是纯普通函数,可以直接传入模拟分数单元测试,不需要调用在线模型。
② 请求路由:按需选择模型
增加路由模块。 有些任务很简单,例如读取单个文件;有些任务复杂,例如排查未知故障原因。全部使用最强模型会浪费成本;全部使用廉价模型,复杂任务输出质量很差。 路由模块为每一条请求匹配对应模型层级:快速廉价模型 / 高性能昂贵模型。
请求启动前,路由一次性向 Jev 并发查询两个问题:选择模型层级,同时评估请求复杂度。
const ROUTER_QUESTIONS = {
  tier: choice("应当用哪个模型层级处理本次请求?", {
    fast: "读取单个文件、提取文件内一条事实、单处小幅编辑",
    powerful: "跨多文件处理,或者无明确根因的故障排查",
  }),
  complexity: score("本次请求需要多少推理量?", [
    "机械级:单步操作,无需主观判断",
    "局部级:在单一范围内多步操作",
    "架构级:多个关联模块,或未知根因",
  ]),
};
路由策略的判定逻辑:
-
如果复杂度得分很高,直接选用高性能模型,哪怕 Jev 推荐 fast -
如果 Jev 对自己的选择置信度不足,为安全起见选用高性能模型 -
其余场景,使用 Jev 推荐的模型
if (complexity.score >= policy.escalateAtComplexity) return powerful;
if (tierAnswer.confidence < policy.minConfidence) return policy.fallbackTier;
return tierAnswer.choice;
这只是示例策略,你可以根据业务领域自定义权重:批量高吞吐任务倾向低成本;凡是触碰生产环境的操作一律升级到强模型。Jev 只提供打分,最终业务规则由你的代码决定。
为什么只在任务开始时选择一次模型? 核心原因是提示缓存。智能体每一步都会重读全部对话上下文,服务商对最近读取的对话做缓存,降低重读开销。但不同模型拥有独立缓存空间。中途切换模型,新模型需要全额重新读取全部上下文,成本暴涨。 Jev 创始人在文档中算了一笔账:长会话中,Claude Opus 切到 Sonnet 再切回 Opus,总成本比全程 Opus 高出约 50%。 因此建议:在对话上下文还很短的任务起点选定模型,全程不切换。
③ 处理 Jev 服务不可用的兜底逻辑
网关和路由都要增加故障预案。 一旦调度框架每一次工具调用都依赖 Jev,智能体就和 Jev 服务绑定。和所有在线服务一样,Jev 可能超时或不可用。需要预先定义服务失联时的行为,不同模块策略不同:
- 安全网关:故障关闭(fail closed)
网关无法调用 Jev 时,无法判断调用是否安全。放行有可能删除文件,因此直接拒绝执行。类似断电自动上锁的门。 - 路由模块:故障开放(fail open)
路由无法调用 Jev,无法评估任务难度。直接选用高性能模型,保证任务正常完成,代价是费用小幅上升。
④ 答案校验器(Verifier)
增加校验模块。在智能体任务标记完成前,校验它的输出结果。
智能体有可能返回缺漏信息、编造没有在文件中验证过的结论。阅读者很难分辨真假。在返回结果前校验,可以在智能体还能重试的时候捕获错误。
校验器会把最终答案、参考文件、工具执行记录一起发给 Jev。Jev 评估答案质量,判断结论是否具备事实依据(grounded,即有工具读取的原文支撑)。
const VERIFY_QUESTIONS = {
  quality: score("答案满足需求的程度?", [
    "完全没有回答需求",
    "部分回答,存在读者明显能发现的缺失",
    "完整回答需求",
  ]),
  grounded: noul("所有事实陈述,都能被 transcript 内文件/工具返回结果支撑"),
};
两条规则防止无限重试:最多重试 2 次;当 Jev 对自己打分的置信度不足时,直接接受当前答案,不再重试。
安全与日志
Jev 返回的是概率,概率判断依然可能出错。凡是代码可以确定性校验的逻辑,一定要写死在代码层。 本调度框架中,所有文件工具强制拒绝工作目录以外的路径,不受 Jev 的判断影响。Jev 只用来处理代码无法硬编码的主观判断。
网关只看工具调用本身(工具名 + 入参)。这有助于抵御提示注入:即使文件 / 网页内藏恶意文本欺骗大模型,网关看不到注入文本,但依然会拦截最终产生的危险工具调用。
记录每一次决策和背后的分数。日志记录拦截原因,并且提供真实分数用于调优阈值。调度框架会将每条决策写入 decisions.jsonl。网关会看到智能体所有尝试动作,日志会脱敏邮箱、密钥,截断超长输入。
在线体验
下方沙盒运行本教程完整调度框架,对接真实 Jev。操作对象是步道勘测笔记文件夹,delete_path工具真的可以删除文件。 体验地址:https://academy.dair.ai/resources/jev-decisions-in-a-pi-sdk-harness
为什么要自研调度框架
现成智能体产品使用内置规则完成这些判断。自定义调度框架把这些决策权交给你的代码:你选择模型、设定阈值、定义人工介入条件,并且通过日志完整追溯每一次调用的决策理由。
Jev 让这件事具备可行性。单次决策仅几百毫秒,成本极低。你可以在任意需要的位置插入校验,而不是只在能承受大模型调用成本的地方使用。 本教程三大模块只是起点。面向你的业务领域,自定义调度框架可以向 Jev 提出任意业务相关的判断问题。
其他落地场景
这套 “大模型做开放式任务 + Jev 做周边快速判断” 架构,不限于代码智能体:
-
代码评审机器人:对每一处代码变更打分,只把值得人工审阅的变更推送给人 -
记录清洗:合并两条业务记录前,判断两条记录是否描述同一实体;存疑记录交给人工处理 -
文档流水线:对每页抽取结果打分,仅低分页面重新执行抽取 -
人工审批队列:只有落在人工复核区间的请求,才流转给审核人员
本教程里的问题定义、阈值、策略仅用于学习,不是生产调优后的配置。团队正在做基准测试,评估这套调度框架改动对成本、答案质量带来的影响,后续会发布带实验数据的文章。 本文和沙盒是我用 Opus 5.5 花一晚完成。遇到问题可以私信我。你可以复制全文喂给智能体,继续基于这套思路做实验。
核心要点
主要概念
- Harness(调度框架)
驱动 Agent 循环、执行工具调用、管控权限的代码层;传统方案每一次安全 / 路由判断都要调用主大模型,成本高,很多校验直接省略。 - Jev(TypeSafe AI)
System One 轻量决策模型,只输出 0~1 概率,不生成文本;一次 API 可以并行回答多个判断问题,低成本、低延迟。 -
分工:主 LLM = 系统 2,做长文本、推理、生成;Jev = 系统 1,做快速二元 / 打分判断。
本项目三大 Jev 接入点
- 工具调用网关 beforeToolCall
拦截破坏性操作;支持三态策略:允许 / 人工复核 / 拦截;故障时 fail closed(直接阻断) - 模型路由 Router
任务启动时评估复杂度,自动选择廉价快速模型 / 高性能模型;只在任务开始选一次,避免跨模型提示缓存损失;故障时 fail open(升级到强模型) - 答案校验 Verifier
任务结束前检查答案完整性、事实是否可溯源;限制最大重试次数,防止死循环
关键工程实践
-
业务策略(阈值、判定逻辑)抽离成纯函数,方便单元测试,不和模型调用耦合 -
硬安全边界交给代码(路径白名单),Jev 只处理模糊主观判断,不能作为唯一安全防线 -
全决策日志保存分数,用于调参阈值 -
兜底故障策略区分模块:安全类故障关闭,业务流转类故障开放
适用场景
代码 Agent、文档抽取、数据清洗、审批队列、代码评审等。
成本亮点
Jev token 单价极低,支持每一步 Agent 动作都做校验,不再是选择性抽检。