



10 个关键问题问与答
Q1:什么是 τ(韬)缩放定律?
A:放弃传统晶体管几何缩小,转而压缩芯片信号传输延迟 τ 的系统级理论,从器件‑电路‑芯片‑系统多维度压缩信号时延,逻辑折叠是其落地核心技术。
Q2:什么是 LogicFolding 逻辑折叠?
A:将原本平面铺开的电路拆分多层硅片垂直堆叠,依靠高密度垂直互联,把长水平走线替换为短垂直跳转,缩短信号传输距离。
Q3:混合键合为什么选晶圆‑晶圆,不用裸片‑晶圆?
A:晶圆‑晶圆继承光刻纳米级对准精度;裸片‑晶圆拾取放置工艺精度只有微米级,达不到逻辑折叠所需亚微米键合节距。
Q4:为什么堆叠芯片晶体管变多,功耗反而下降?
A:现代芯片大部分能耗消耗在信号走线数据搬运,不是晶体管运算;折叠大幅缩短走线,降低电容损耗,同时并行架构实现降电压,电压平方效应进一步压低功耗。
Q5:麒麟 2026 关键模块实测数据如何?
A:同等性能:NPU 功耗‑66%;GPU‑58%;CPU 性能大核‑41%;Turbo 模式可释放更高算力,但功率密度会上升。
Q6:DSP 模块为什么第一代折叠功率密度不降反升?
A:折叠使 DSP 面积缩减幅度大于功耗下降幅度,单位面积功耗抬升;麒麟 2027 第二代折叠实现功耗、功率密度双双下降。
Q7:CPU 大核功耗改善幅度不如 NPU/GPU 的原因?
A:CPU 大核大量为不可并行的串行指令,无法大规模并行降频降压,仅获得走线缩短的线性收益,需要 EDA 工具、软硬件协同持续迭代。
Q8:堆叠底层芯片热量要穿过上层,如何避免结温过高?
A:①同等性能下总功耗下降,功耗分摊到多层硅片;②模块面积缩小预留横向散热空间;③层间冷热逻辑交错排布,避免热点上下堆叠,控制晶体管结温。
Q9:τ 缩放是不是天然就等于低功耗?
A:不是。τ 缩放是时间缩放定律,只提供时延余量;低功耗是工程师主动把时延余量用来降频降压换来,芯片也可以选择跑满性能,代价是功耗密度升高。
Q10:公开的技术路线图未来有什么目标?
A:键合节距向 720nm、480nm 演进,增加垂直互联数量;未来 3‑5 年进一步挖掘 CPU 潜力,目标 CPU 大核频率达到 5GHz 以上。
附录 华为 τ 芯片本该过热烧毁?
何廷波 摘要热问题是 τ 缩放定律最受关注的痛点 ——τ 缩放定律是华为折叠硅芯片背后的时间缩放原理,该技术旨在缩小信号延迟 τ(读音 Tao,中文称 “韬”)。我们对麒麟芯片的实测推翻了这一质疑。其中的道理,每个通勤上班族都能理解:在芯片内部,就如同工作日通勤,信号传输会消耗绝大部分能耗,而晶体管本身的运算工作耗能反而占比更低。
索引术语:逻辑折叠(LogicFolding)、τ 缩放定律、3D 集成、混合键合、低功耗设计、系统‑技术协同优化。
去问一百位芯片工程师,行业未来最重要的技术是什么,很多人会回答:3D 集成,也就是把芯片裸片堆叠,以此提升单颗系统芯片的硅片可用规模。但再去问资深芯片工程师,什么会葬送 3D 集成技术,得到的答案几乎永远是同一个词:散热。
这套逻辑听上去如同自然法则:把有源晶体管层层堆叠,每平方毫米塞入更多电路,再把整套器件封装在狭小的移动设备内部,结果似乎已成定局。功耗转化为热量,热量被禁锢在狭小空间就会抬升温度;温度超过阈值,芯片就会降频、可靠性衰减,最终烧毁芯片。按这套逻辑,折叠堆叠密度越高,芯片发热就越严重;堆叠程度越高,就越快撞上性能天花板。
华为不能坐等这套争议尘埃落定。受限于先进制程工具,无法像竞争对手一样继续缩小晶体管尺寸,华为必须打破这一困局,而且要比所有人都更早做到。于是华为不再做空间缩放(缩小晶体管物理尺寸),转而开启时间缩放:缩减信号在芯片关键路径上传输的特征延迟。该延迟记作 τ,读作 tau,中文名为 “韬”;τ 缩放定律就是一代一代持续压低 τ 值的技术路线 [1]。实现该目标的核心技术叫做逻辑折叠(LogicFolding):把原本平铺在平面上的电路,拆分为多层垂直堆叠的硅片,依靠微型垂直互联通道连接层与层,以此缩短信号传输距离。
从设计之初,τ 缩放就被定位为一套电子系统层面的设计理论,而非单纯器件层面的小技巧:时间延迟可以在器件、电路、芯片、系统每一个层级进行压缩。逻辑折叠只是这套框架下、应用在电路与芯片层级的一项技术。这一点十分关键,行业却常常忽略。晶体管问世之后,集成电路随之诞生,意义同样重大。但半导体行业的发展叙事依旧聚焦于晶体管性能提升,仿佛数十亿晶体管搭建而成的电路只是附加产物。τ 缩放也遭遇了同样的认知盲区:部分质疑者看到 τ 芯片内部晶体管本身没有本质变化,便断言技术没有根本性革新。下文的实测数据将说明该观点错在何处。
2026 年 5 月,在 IEEE 国际电路与系统研讨会上,逻辑折叠技术首次公开亮相,现场充斥着大量质疑,最尖锐的反对声音全部指向散热问题。
但这套推论存在一个关键漏洞:基于麒麟 2026 这款即将于本月出货的实体硅芯片的实测结果,现象恰恰相反。这款芯片每平方毫米的晶体管数量提升 55%,但实际工作温度相比前代更低;部分关键任务下功耗最高降低 66%。下文将解释背后原理,以及逻辑折叠与 τ 缩放定律,为何能够带领华为(也可能带动其他厂商)走向更远的未来。
一、什么是逻辑折叠?
摩尔定律推动计算行业乃至众多产业长足发展,但摩尔定律的核心手段始终只有一种:几何尺寸缩放[2‑3]。把晶体管做小,芯片同时变得更快、更省电。十多年前,这套手段就已经走到瓶颈。通过改良晶体管结构,行业又延续了十年发展;但如今每一代芯片厂商,都要付出更高成本,却收获越来越有限的提升 [4‑7]。
而华为遭遇的挤压来得更早、也更猛烈。想要向下突破 7nm 节点,就必须用到极紫外(EUV)光刻设备,而该设备无法获取,因此必须另辟蹊径。
历经六年探索,团队重新审视几何缩放:缩小尺寸只是手段,而非最终目的。缩小晶体管的初衷从来不是追求体积本身,而是为了实现更快的开关速度、更短响应时间、更高时钟频率。简言之:逻辑折叠,在不缩小物理尺寸的前提下,换取时间性能收益。在大致相同的硅片面积内,塞入更多晶体管,让整套系统运行速度变得更快。
实现该技术的基础工艺是3D 混合键合,它更类似焊接,而非传统封装工艺。两片晶圆(或者一片晶圆与一颗芯片)经过精密对准,压紧贴合,再缓慢退火加热。退火过程中,两片氧化层表面形成共价键,融合成为一整片介质层;两面的铜焊盘受热膨胀,互相熔接形成连续金属通路,最终在堆叠裸片之间形成海量垂直互联通道。当前商用高端逻辑芯片中,这类垂直互联的间距约 10 微米,每 100 平方毫米面积内垂直互联通道不足 100 万个。
真正的设计难题在于:单位面积内,垂直互联通道需要达到多大密度,才能真正降低 RC 损耗(电阻与电容,会拖慢信号、增加能耗)。目前没有闭合解析公式,但有一条可靠经验:常规逻辑工艺顶层金属节距为 720nm;如果键合节距匹配该数值,面对面对接的晶圆就可以直接连通顶层金属信号。如果键合节距更稀疏,信号就需要向外布线到稀疏焊盘,增加走线长度、布线拥塞,反而引入 RC 损耗,而这恰恰是折叠技术本要解决的问题。
大量设计空间探索验证了这一经验:1.5 μm 的键合节距就可以实现不错的逻辑折叠效果;1 μm 效果更佳;720 nm 可以进一步放大收益。未来计划继续缩小键合节距至 480 nm,让混合键合焊盘能够对接下层金属走线,进一步拓宽逻辑折叠的设计自由度。
华为将混合键合视作晶圆级跨层器件工艺,而非封装工序。裸片‑晶圆键合属于芯片拾取放置的裸片处理工艺,脱胎于封装工厂,基础对准精度有限,即便经过多年优化,依旧停留在微米级别。而晶圆‑晶圆键合源自晶圆制造产线,光刻设备本身就可以实现几纳米级套刻精度。这种高精度是实现亚微米级键合的基础,但键合工艺还需要解决光刻设备不会遇到的一系列难题:应力控制、化学机械抛光平坦化、清洗、晶圆翘曲、边缘锥度、对准等,才能实现亚微米节距。
依托 40nm 工艺设备,麒麟 2026 实现了 1.5 μm 混合键合节距,拥有 5000 万个垂直互联通道,其中 10‑15% 用于传输信号。麒麟 2027 芯片已经实现 1 μm 节距,垂直互联通道突破 1 亿个;计划三年内达到 720 nm 顶层金属节距,实现 1:1 的匹配,垂直互联通道数量突破 2 亿。
搭建好垂直互联通路之后,就可以开展电路折叠。华为工程师分析麒麟 SoC 内部负载最重的模块:NPU、CPU、GPU、DSP,定位每个模块内部最长、速度最慢、功耗最高的水平走线。随后对每个模块重新设计,把电路拆分到两层硅片,把原本长距离水平走线,改造为跨裸片的短垂直跳转通路。
首款采用逻辑折叠的移动 SoC—— 麒麟 2026,单代就把晶体管密度从约 1.55 亿每平方毫米提升至 2.38 亿每平方毫米,涨幅 55%,相当于过去三代依靠几何缩小才能达成的提升。
这无疑是亮眼成果,但直觉会认为,功率密度理应同步上涨。
结果恰恰相反,功率密度下降了。
和平面前代芯片对比,在同等性能条件下,麒麟 2026 实测:NPU 功耗降低 66%,GPU 功耗降低 58%,CPU 性能大核功耗降低 41%。单位面积塞进了更多晶体管,但完成同等工作量时,芯片单位功耗反而更低,而非更高。
该现象需要解释,看上去仿佛违背质疑者口中的物理规律,但事实并非如此。这揭示了芯片功耗的真实去向 —— 和大多数人的固有认知并不相同。
二、两份功耗账单
智能手机日常工作负载中,芯片功耗分为两部分。第一种是静态漏电流:没有计算任务时也会产生的漏电功耗,占比很小。第二种是动态功耗,计算过程中产生,占总功耗约 90%。
数字电路的动态能耗主要来源于两部分:
- 开关损耗
晶体管栅极翻转,逻辑门充放电,实现比特 0‑1 状态切换。这是真正的计算工作本身。 - 信号传输损耗
长金属走线传输比特信号,走线反复充放电。导线本质就是分布式电容,信号传输距离越远,需要充放电的电容就越大,能耗随之上升。
动态功耗经典公式: \(P=\alpha \cdot C \cdot V^{2} \cdot f \tag{1}\) 式中电容 C,在先进工艺节点下,主要由互联走线电容主导,而非晶体管栅极电容。能量大量消耗在互连线,而非晶体管本身。
这就是大众直觉出错的根源:现代 SoC 模块内部,走线传输的能耗,往往高于逻辑门运算的能耗。处理器大部分功耗,不是用来做运算,而是用来搬运数据。
三、通勤类比理解芯片功耗
想象普通上班族每日的能量消耗。很多人会觉得大部分能量消耗在本职工作:开会、处理表格、思考。现实并非如此。大量上班族一天中能量消耗最大的环节是通勤:每天往返家和办公室。坐在工位办公的能量消耗反而更低,通勤才是大头。
芯片同理:逻辑门负责 “思考运算”,金属走线负责 “通勤搬运数据”。大型 AI 集群也是如此,超过 80% 能耗消耗在数据搬运,而非计算;智能手机 SoC 内部,也存在同样的失衡,只是程度稍轻。
理解功耗的本质之后,堆叠折叠带来的散热质疑就会被推翻。批评者默认晶体管堆叠变密,功率密度必然上涨,他们的关注点只在逻辑门,也就是 “工位工作”。但功耗的主导项是 “通勤搬运”。而逻辑折叠做的事情,就是把 “家搬到离办公室更近的地方”。
电路折叠为多层硅片,依靠亚微米节距的混合键合焊盘连接。原本需要横跨数百微米的长水平走线,现在只需要通过几微米距离的焊盘垂直跳转。实测显示,普通核心路径走线长度平均缩短 20%,部分关键路径缩短最高可达 70%。时钟网络是功耗最高的走线之一,时钟缓冲器数量直接削减过半。某一个处理模块,折叠后时钟走线缩短 28%,缓冲器数量从 43600 下降至 19000。
走线变短,对应的充放电电容随之降低,功耗公式中占主导地位的电容项直接下降。晶体管开关运算本身的能耗几乎不变,但数据搬运的开销被大幅削减。功率密度下降的根源就在这里:不是计算量变少,而是数据搬运变少。
四、麒麟 2026 各模块功耗实测
智能手机 SoC 热预算主要来自数据搬运量大的模块:做 AI 推理的 NPU、渲染像素的 GPU、信号处理 DSP。它们发热高的根源就是通信密集,需要在内存、缓存、运算单元之间搬运海量数据,功耗大头是数据搬运而非运算,而逻辑折叠恰好针对这部分开销优化。
为衡量逻辑折叠给各个模块带来的收益,我们做对照测试:把折叠后的芯片与平面前代麒麟 9030 Pro 做等性能对比:AI 算力、帧率、跑分保持一致。同等性能下,模块需要的工作速度更低,电压就可以下调,功耗收益进一步放大。同时芯片也可以全开性能跑满,因此每个模块有两组测试条件:和前代性能对齐、以及满血涡轮模式。
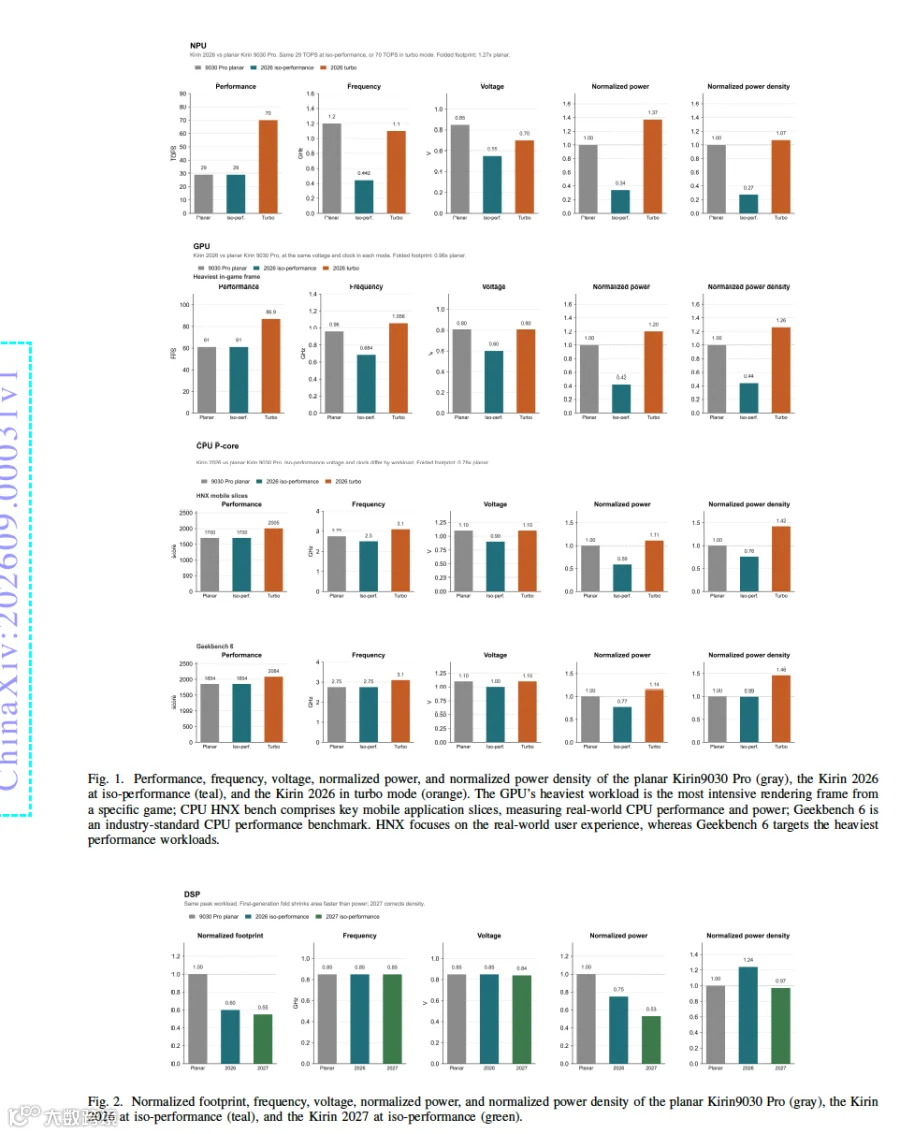
图 1 包含五组子图:性能、频率、电压、归一化功耗、归一化功率密度;三组柱状分别代表平面版麒麟 9030 Pro(灰色)、等性能模式的麒麟 2026(青绿色)、涡轮模式麒麟 2026(橙色)。归一化图中的虚线代表麒麟 9030 Pro 基准。折叠后的面积为两层堆叠等效投影面积,功率密度以此面积作为计算基准。
图 1:平面版麒麟 9030 Pro(灰色)、等性能模式麒麟 2026(青绿色)、涡轮模式麒麟 2026(橙色)的性能、频率、电压、归一化功耗、归一化功率密度。GPU 最高负载取自某游戏重度渲染帧;CPU HNX 移动基准选取手机真实应用场景片段,衡量真实场景 CPU 性能功耗;Geekbench 6 是行业通用 CPU 基准测试。HNX 偏向真实用户体验,Geekbench 6 偏向极限重载场景。
NPU 是堆叠技术最受质疑的模块,密度最高,传统上发热也最严重,但它获得的收益最大:维持 29 TOPS 算力不变,时钟频率下降 63%,电压从 0.85V 降至 0.55V;功耗下降 66%,功率密度惊人下降 73%。GPU 紧随其后:维持 61FPS 帧率和麒麟 9030 Pro 持平,电压降低 200 mV,功耗下降 58%。收益的大小和数据搬运强度正相关:模块并行度越高、数据搬运越密集,折叠带来收益就越大。
DSP 是特殊案例,也揭示重要规律:逻辑折叠可以让面积缩减幅度超过功耗下降幅度(见图 2)。第一代折叠(麒麟 2026)完成同等任务功耗下降 25%,但功率密度(每平方毫米功耗)上升 24%。真正决定散热的是功率密度。原因很直接:折叠把 DSP 占用面积缩减 40%,即便总功耗下降,单位面积功耗依旧上涨。第二代折叠麒麟 2027 已经完成流片测试,功耗下降 47%,功率密度相比平面原版也实现降低。由此可见,功率密度是设计出来的结果,不是堆叠带来的宿命。
CPU 性能大核也从折叠中大幅受益:HNX 基准跑分和前代持平,时钟频率降低 9%,供电电压下降 200 mV,功耗降低 41%。但在所有高热模块中,它的功率密度改善幅度最小。这不代表折叠失效,而是重要线索,后文展开。
当然,优化不只有省电。我们也将麒麟 2026 各个模块跑满,对比 9030 Pro 极限性能。涡轮模式下,折叠 NPU 算力达到 70TOPS,相比前代提升 141%;GPU 帧率提升 42%;CPU HNX 跑分提升 18%。该模式下它们的功率密度会高于平面前代芯片。
折叠技术给系统带来平面芯片不具备的调节能力:同一套硬件,可以低功耗省电运行,也可以极限压榨性能,视场景切换。
五、两套并行理论:电路层面 τ 缩放定律,软件层面阿姆达尔定律
走线缩短带来一部分功耗收益,但更大收益来自电压降低 —— 动态功耗和电压平方成正比。逻辑折叠把电路分为三类:
- 强串行电路
,需要极高频率与电压; - 高度可并行电路
,大量复制电路并行工作; - 串并混合电路
。
纯串行电路占比很少。现代 SoC 绝大多数晶体管属于第二类、第三类,NPU、GPU、DSP 就是典型,它们功耗高,正是因为架构宽、并行度高、数据吞吐巨大。CPU 性能大核是典型第一类:单线程整数执行无法并行,必须维持很高电压与频率。因此在 HNX 等性能测试下,折叠仅带来 9% 的频率下降,只是走线缩短带来的线性收益,无法获得电压平方级的巨大收益。
在 CPU 大核上落地逻辑折叠,需要精细设计、高级 EDA 工具链、漫长验证周期,属于系统性重构,不是简单改改就能实现。麒麟 2026 已经取得可观收益,但更大潜力还需要未来 3‑5 年持续激进创新。不过每一代都可以获得实实在在的累积提升。
幸运的是,架构上的瓶颈,不需要单纯靠硅片硬件解决。智能手机可以做深度软硬件协同设计。不必把所有重载任务全部压给一颗高性能大核;任务调度器和折叠芯片版图协同优化,软件层面把任务并行拆分,分发到多个高效小核执行。尽可能把大核需要承担的串行任务占比压到最低,把工作从第一类转化为第二类,就可以用上电压平方的功耗优化杠杆。
两套增益同时生效:折叠缩短走线;同时同样面积内多出大量晶体管,可以复制更多电路单元并行工作。拆分任务,每个单元工作频率降低,电压随之降低。走线缩短带来电容 C 的线性功耗下降;并行化带来 V² 平方级功耗下降。
折叠后的 NPU 就是绝佳例子:前代是 1 个大核 + 2 个能效核;折叠释放的晶体管资源,直接堆出 4 个大核。阵列规模更大,在 0.7V 电压下实现 70TOPS,前代芯片不到一半算力却需要 0.85V。更多硬件,更低工作电压,实现更高性能,完美印证功耗公式的平方效应。
这就是密度更高的芯片功耗反而更低的底层逻辑:需要高电压的串行计算占比被压到很小;芯片绝大部分电路都可以通过折叠拓宽并行规模,降频降压运行。
这套设计思路和吉恩・阿姆达尔的经典思想互为映照:程序串行部分决定并行加速的上限。阿姆达尔定律针对软件;逻辑折叠揭示了硬件世界的镜像规律:硅电路中串行部分占比有限,芯片大部分电路都可以用并行换取更低速度、更低能耗。二者如同双星,一个约束代码算法,一个约束电路延迟与能耗,共同构成系统‑技术协同优化(STCO)的理论基石。
六、设计层面消除热点
即便逻辑折叠带来功耗下降,依然有人会提出散热隐患:两层有源晶体管同时工作,底层产生的热量需要穿过上层硅片才能散出去,热量会发生聚集。
我们认为批评者找错了衡量指标。关键不是总发热量,而是热密度,更底层是晶体管结温,真正决定芯片速度、漏电流、可靠性的就是结温。芯片失效不是因为总瓦数超标,而是晶体管结温超过工作上限。一切热相关争论,最终都应该落脚到结温。
两套手段控制结温: 第一,折叠从源头降低热密度。同等性能条件下总功耗实实在在下降;功耗分摊到多层有源硅片,而不是全部挤在单层平面。实现更低的每立方毫米热功率,而热密度直接决定结温的高低。
第二,剩余热量做定向热管理。折叠压缩 NPU 等高发热模块的面积,留出空间让热量横向扩散,消除局部热点,再垂直传导到表面。两层之间会存在适度垂直温差,底层比上层略高几度;设计时就把高温模块布置在散热路径最优的位置,把温差作为设计参数纳入预算。真正的威胁不是平均温度,而是局部结温远高于周边的热点。依靠设计工具,把高温逻辑和低温逻辑在层与层之间交错排布,避免热点上下直接堆叠,以此获得热设计余量。
麒麟 2026 在实现时采取保守策略:逻辑折叠只选择性应用在收益最高的关键路径,结合热感知布局,而不是无脑把全部电路堆叠。通过源头降低热密度、热量横向摊开、预留垂直温差预算、规避局部热点,晶体管结温被控制在安全区间。
七、西西弗斯,但前路通向远方
我们不能宣称已经取得彻底胜利。τ 缩放是时间缩放定律,不是能量缩放定律。折叠芯片也可以跑的更快,同时功耗暴涨,这并不违背 τ 缩放原理,但这样手机电池半天就会耗尽。芯片低温运行,是我们主动把折叠带来的时间余量用来换取降压降功耗,这是配套设计取舍,不是该定律自带的免费结果。
折叠后的 NPU 可以用前代三分之一功耗完成同等任务;也可以性能暴涨 141%,功率密度随之拉高。物理上两种模式都成立;工程师选择低温低功耗的方案,并且每一代芯片都会坚持该取舍。
麒麟 2026 的 CPU 折叠方案相对保守,仅针对关键路径优化,但今年性能大核频率已经做到 3.1 GHz。未来 3‑5 年释放逻辑折叠全部潜力,需要全行业大力创新:拓展设计空间、继续缩小混合键合节距、下层金属层集成垂直互联、堆叠更多硅片层级等。按照路线图,麒麟 CPU 核心频率有希望突破 5 GHz,该路线具备技术可行性与经济可行性。
神话中西西弗斯被惩罚,不停把巨石推上山,巨石又滚落,周而复始。τ 缩放工程开发也有类似循环:完成芯片折叠,拿到时间余量,把余量转化为功耗收益;下一代迭代到来,又开启新一轮循环。折叠布线不是跳出循环的捷径,而是新一轮向上推动。和神话不同,这条路是有终点方向的:每一轮循环,芯片都算力更强、能耗更低,累积的进步就是半导体行业的发展。挑战永远不会彻底消失,这不是定律的缺陷,而是工程师的使命。不妨想象,工程师们乐在其中。
八、低温才是前进的方向
所有人最先拿出来反驳折叠技术的散热问题,本质上源于对芯片能耗去向的误解。质疑者盯着 “工位运算工作”,但物理现实中,数据搬运通勤才是能耗主体。逻辑折叠缩短 “通勤距离”,一举压低特征延迟 τ 与能耗 —— 因为距离同时决定时延与功耗。
τ 缩放未来的成败,全部取决于功耗。时间余量是工具,降低能耗才是最终目标。未来十年,评判 τ 缩放技术的标准,不是堆叠芯片能跑多快,而是运行时功耗能做到多低。
那枚本该被烧毁的 τ 芯片,实际运行温度更低;不是折叠带来的副作用,恰恰得益于折叠本身。τ(韬),它带来的改变,远比想象更加多元。
参考文献
[1] T. He, “A time scaling theory for multi‑layer electronic systems,” Sci. China Inf. Sci., vol. 69, no. 8, Aug. 2026. [2] G. E. Moore, “Cramming more components onto integrated circuits,” Electronics, vol. 38, no. 8, pp. 114‑117, Apr. 1965. [3] R. H. Dennard, F. H. Gaensslen, H.‑N. Yu, V. L. Rideout, E. Bassous, and A. R. LeBlanc, “Design of ion‑implanted MOSFET’s with very small physical dimensions,” IEEE J. Solid‑State Circuits, vol. 9, no. 5, pp. 133‑141, Oct. 1974. [4] H. S. P. Wong, “Beyond the conventional transistor,” IBM J. Res. Dev., vol. 46, no. 2.3, pp. 133‑168, Mar. 2002. [5] V. V. Zhirnov, R. K. Cavin, J. A. Hutchby, and G. I. Bourianoff, “Limits to binary logic switch scaling — a gedanken model,” Proc. IEEE, vol. 91, no. 11, pp. 1934‑1939, Nov. 2003. [6] G. E. Moore, “Lithography and the future of Moore’s law,” in Proc. SPIE 2438, Optical/Laser Microlithography VIII, May 1995, pp. 2‑17. [7] K. Flamm, Measuring Moore’s law: Evidence from price, cost, and quality indexes, in Measuring and Accounting for Innovation in the 21st Century. Chicago, IL, USA: Univ. of Chicago Press, 2019. [8] G. M. Amdahl, “Validity of the single processor approach to achieving large scale computing capabilities,” in Proc. AFIPS Spring Joint Comput. Conf., Atlantic City, NJ, USA, Apr. 1967, pp. 483‑485。
补充说明
-
专业术语尽量兼顾国内半导体行业习惯, τ保留符号,中文译名为韬;LogicFolding 统一译作逻辑折叠;hybrid bonding 译作混合键合。 -
公式、图表说明、参考文献完整保留;原文的比喻(通勤、西西弗斯神话)完整还原中文文学感。 -
iso‑performance 译为等性能 / 同等性能,芯片型号、工艺参数、电压频率数值全部忠实原文。