
每年九月,智能手机圈都会上演一轮"神仙打架"。但今年格外热闹——华为与小米选在同一天召开发布会,一个推出三折叠Mate XT2,一个带来中折叠旗舰小米18 Fold;紧接着苹果亮出iPhone 18 Pro系列以及首款折叠产品iPhone Duo。如果把OPPO、vivo等品牌也算上,光9月一个月,行业新品发布会就逼近10场,旗舰机型定价普遍跨过万元门槛,个别甚至摸到两万元。
为什么大家都在抢?"得赶在黄金周和双十一之前把产品推出去、卖起来,"一位曾在手机厂商负责战略研究的人士透露,"以前安卓阵营为了避免和iPhone正面碰撞,一般把新品安排在10月,但去年小米9月单独发了一款带背屏的产品,硬是提前一个月开卖,效果很好,今年所有人都学聪明了。"
不过,在这场终端价格战背后,更深层的变化正在芯片层面发生:手机厂商顶着内存涨价的压力,集体杀入了2nm制程的争夺,而且几乎所有人都不约而同地押注同一个方向——All in AI。
一、2nm产能卡位:苹果吃掉七成,安卓阵营只能争剩余份额
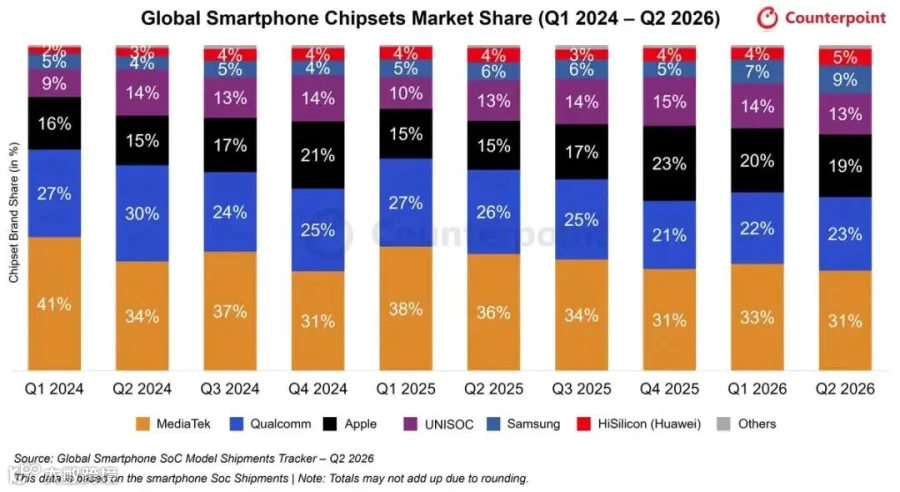
联发科其实在2025年就率先"造势"了——CEO蔡力行先在Computex上放出口风,随后9月正式对外宣布全球首个2nm SoC启动流片。但流片早不等于量产早,2nm手机芯片的真正商业化战役,是今年9月苹果A20 Pro亮相后才正式打响的。
从台积电今年的产能分配来看,苹果的"头号客户"地位在2nm节点上依然不可撼动。长期追踪台积电产能的蓉和半导体咨询CEO吴梓豪透露:"台积电今年2nm晶圆总产能大约10万片,苹果拿走了其中约7万片。"剩余的3万片要分给高通(约1万片)、联发科以及AMD等客户。
这意味着,尽管联发科全球手机芯片出货量第一,但其出货主力集中在中低端价位段,真正对2nm有需求的高端产品线,体量远不如苹果。 以天玑9600 Pro为例,按照5000片晶圆需求、134mm²左右的芯片面积和85%良率推算,单月出货量大概只有200万颗。相比之下,苹果仅A20 Pro一颗芯片的理论月需求就高达1300万颗,再加上M6芯片,合计需要约7万片晶圆——几乎吃满苹果拿到的全部配额。
不过值得注意的是,联发科也在联合谷歌设计2nm推理专用TPU,预计2027年底交付。这个项目一旦进入量产,联发科对2nm产能的需求可能显著攀升。
2nm还有一个绕不开的话题——贵。 高通在Q2业绩会上已预告从9月1日起涨价。晶圆代工成本的攀升叠加内存涨价,最终都会传导到终端售价上。消费者最直接的感受就是:手机又贵了。
但涨价背后也折射出存量竞争的现实。前金立手机副总裁俞雷指出:"整体大盘不好,销售额没怎么跌,跌的是出货台数。"在他看来,涨价的成因除了供应链价格上涨,也与国产替代和技术进步密切相关——屏幕、CIS、存储、射频、电源管理等领域逐步被国产供应链接管,让国产手机产品力跃升,最终把日系、韩系品牌打得溃不成军。
二、自研芯片的"另一条路":当制程被卡,先进封装来补位
高通、联发科走的是2nm通用方案,而苹果、华为、小米则走自研路线。苹果用多年实践证明了自研芯片的战略价值,华为和小米也在跟进。但与苹果不同的是,华为和小米的代工环境受限,自研之路障碍更多,也因此显得更加珍贵。
华为9月发布的Mate XT2三折叠搭载麒麟9050 Pro,采用了W2W(晶圆对晶圆)垂直堆叠工艺,把原本平铺的单层逻辑单元改成双层立体结构——通俗讲就是"在芯片里加装电梯"。小米也走W2W路线,推出了6nm工艺的玄戒O100。
两家的共性是:在工艺制程受限时,先进封装成为打开性能天花板的关键钥匙。但差异也很清晰——华为聚焦逻辑单元之间的垂直堆叠,主要突破的是物理制程微缩瓶颈;小米的W2W则侧重逻辑与存储单元的堆叠,针对的是"内存墙"导致的数据搬运效率问题。
小米目前在玄戒O3上仍停留在3nm,未能一步跨到2nm。这背后有多重制约因素,其中之一是GAA架构:2nm制程下,台积电和三星都切换至GAA架构,而与之配套的设计工具和代工资源受到严格管控。 "小米最多能用到3nm,"前述战略研究员表示。
从规模化角度看,现阶段即便小米能上2nm,也未必划算。苹果仅iPhone一个产品线,每年芯片需求量就在上亿颗级别;而玄戒O1出货量刚过百万颗,要真正产生规模效益,出货量可能需要冲到千万级。
但小米在3nm玄戒O3上做的探索,反而比简单粗暴地导入2nm更有技术含金量。 玄戒团队对底层最小逻辑单元Standard Cell进行了重构,从O1的480个扩展到O3的2400个;同时采用Channelless沟道消除技术,取消SoC中用于供电BUF单元预留的沟道,将BUF单元移至其他模块,实现了约5%的晶体管密度提升。
如果用一个角度来评价其价值:过去摩尔定律靠晶圆厂工艺迭代驱动,单位面积晶体管数量每18-24个月翻倍;如今制程演进放缓,"摩尔定律已死"的声音此起彼伏——但华为和小米用另一种方式,在制程受限的条件下让摩尔定律延续了生命力。这背后是中国芯片设计团队的韧性和创造力,这一点必须予以承认。
三、All in AI不是口号:SoC正从"独NPU模式"走向"全子系统异构算力网络"
无论苹果的2nm还是玄戒的3nm,今年手机SoC领域最突出的共识就是:AI不再是NPU一个人的事,CPU、GPU、ISP等所有核心IP都开始承担AI推理任务。SoC的架构正从"单一NPU包揽全部AI"向"全子系统异构AI算力网络"演进。
在这种新范式下,大模型的重负载优先交给NPU处理,而低延迟、碎片化的轻量AI任务则直接由CPU或GPU就近执行,目的是减少片上数据搬运的开销,同时提升整机能效比。
以小米玄戒O3为例,其CPU集成了两个矩阵计算引擎单元(采用SME2指令集),提供3.5TOPS算力处理轻量AI负载;GPU子系统中内置了8核心NX神经加速单元,总算力36TOPS,可在GPU内部实现图像渲染的AI超分和插帧。
苹果的路线则是CPU(AMX硬单元)+ GPU(内置神经网络加速器)+ 独立NPU的三级异构AI算力架构。联发科由于底层IP与玄戒O3同源,在今年手机SoC中走得最远——全计算子系统都嵌入了专用AI硬件单元,堪称全模块AI化的最激进实践者。
一位资深芯片设计专家指出:"从技术趋势看,GPU内嵌AI是确定的,CPU内嵌AI也是确定方向——具体方案上各家可以有所不同。"他认为,这种设计理念的本质是优化计算"成本":NPU执行任务需要计算核心进行调度传输,开销不小,如果简单计算能在核心内部就近完成,就能大幅削减跨模块传输的能耗浪费。
这种"就近计算"的思路,一方面提升效率,另一方面为手机厂商基于不同IP的AI特性探索差异化能力提供了硬件基础。"OPPO在主动智能方面有一些投入,有可能做出差异化来,"前述战略研究员补充道。
但需要清醒认识到的是:方向虽然确定,路线尚未统一,探索仍处于早期阶段。 "当前做得都还不太好,"前述芯片设计专家坦言,"但以后AI融合会越来越多,具体方案上是GPU内部内嵌AI,还是GPU加外部NPU做紧密协同,都有可能。"
说到底,All in AI声势浩大,行业也确实形成了共识,但最终能驱动消费者为创新额外买单的,不是参数和PPT,而是可靠、稳定、高频使用的真实场景和体验。 在这场芯片暗战中,硬件架构只是第一步,场景价值的落地才是决定胜负的关键。

关注抖音【靓哥聊创业】
抖音号|54707203975
保存二维码打开抖音扫一扫