

智猩猩AI整理
编辑:BugMaker
8 月 21 日,RadixArk 发布并开源 Miles v0.1。它当时就已经把 SGLang 多轮 Rollout、完全异步 RL、TITO、MoE 路由重放、Megatron-LM/FSDP 训练以及 P2P 权重同步接进同一套系统,瞄准的就是 Agentic RL 里最难处理的吞吐、训推一致性和超大模型权重更新。
而且 Miles 并不只停留在框架设计上。RadixArk 披露,Periodic Labs 已经用它在数千张 GPU 上训练万亿参数模型,双方优化后 Rollout 吞吐提升 3×,权重同步提升 10×,权重转换提升 30×。
到了 9 月,团队又发布完整技术报告 《Miles v0.1: Production-Level Post-Training》。这一次,8 月已经跑起来的这套 Post-Training Infra,被从 Rollout、训练到权重更新完整拆开了。

报告公开后,“月球大叔”也在 X 上转发了 RadixArk 的相关内容。
他提到,RL 本身技术栈很深,做好框架又需要很强的工程能力,而长期维护开源社区同样不容易,能同时把这几件事做好的一支团队并不常见。
这也是我们这次重新看 Miles 的原因。
Miles 的重点并不是再造一个新的 RL Objective。随着 Agent 轨迹越来越长,训练系统真正开始被 异步 Rollout、训推一致性、MoE 路由、显存以及大模型权重同步这些问题卡住。
于是 Miles 的很多设计,几乎都围绕一个目标展开:让 Agentic RL 在前沿模型规模上真正持续跑起来。
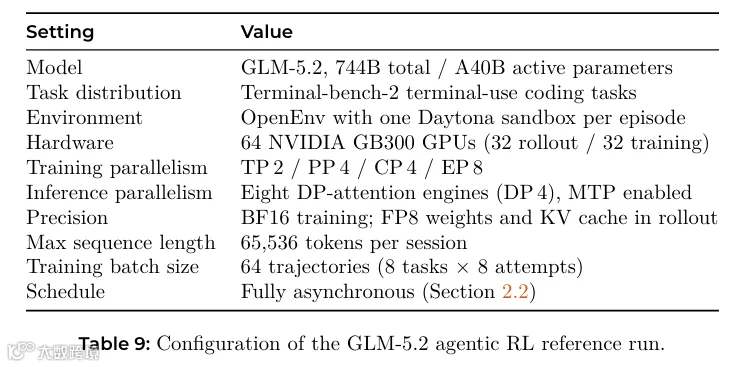
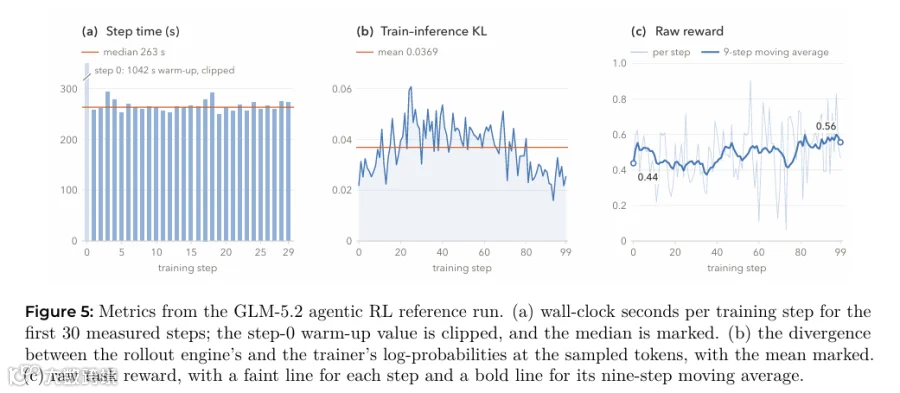
报告里最重的一组实验直接用了 64 张 NVIDIA GB300 跑 GLM-5.2 744B-A40B,其中32张负责 Rollout、32张负责训练,前30个测量 Step 的中位时间为 263 秒。
而在另一组权重同步测试中,Kimi K2 1T-A32B 的单次更新从 NCCL Broadcast 的 53.28 秒降到 P2P 的 7.23 秒,时间缩短 86.4%。
这份报告真正想讲清楚的,是 Agent 时代的大模型 Post-Training Infra 到底该怎么搭。
01
RL框架真正难的,是让Rollout和
训练一直转起来
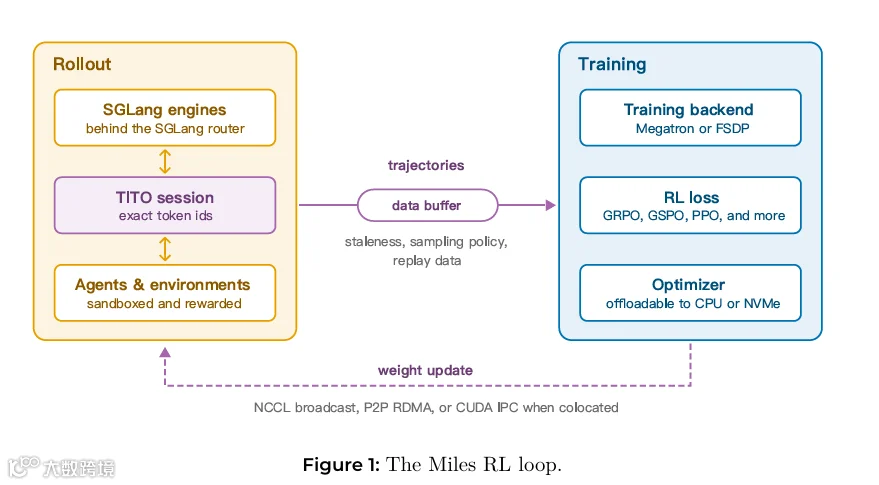
Miles 的整个 RL 循环其实只有三个核心阶段。
Rollout 负责生成轨迹,Training 根据轨迹更新策略,Weight Update 再把最新模型送回推理端。
简单写成三步很容易,真正到了 Agentic RL 就完全不同。一个任务可能包含几十轮工具调用,不同轨迹结束时间差异很大。同步训练时,最快完成的 GPU 只能等最慢的一条轨迹,Trainer 也只能等整个 Batch 收齐。
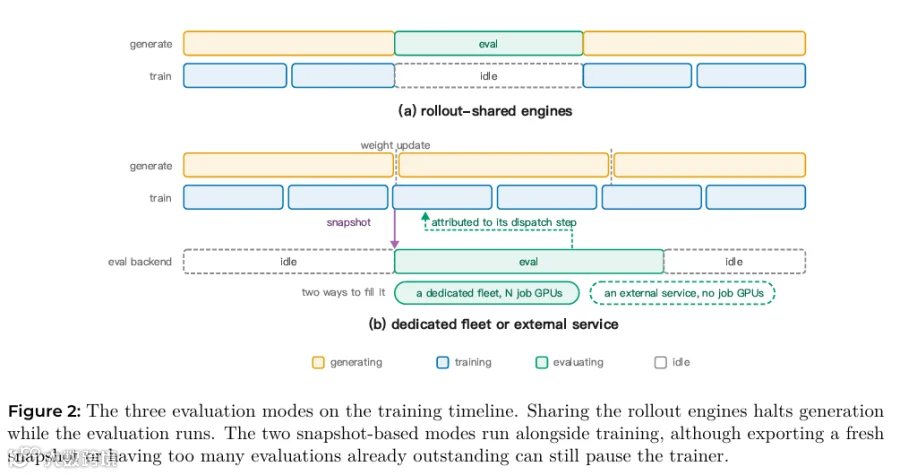
Miles 因此支持完全异步强化学习(Fully Asynchronous RL)。Rollout GPU 持续生成数据,Trainer 同时从数据缓冲区里取已经完成的轨迹训练,两边不再轮流等待。
这里还有一个很实际的问题。
多轮 Agent 每一轮都会继承前面的上下文。如果下一轮被路由到另一台 SGLang Engine,之前的 KV Cache 就利用不上了。Miles 因此为一个 Session 保持固定的路由亲和性,再把新 Session 优先交给当前负载较低的 Engine。
在后面的 GLM-5.2 实验中,Prefix Cache 命中率维持在 96%。
02
Token一样还不够,MoE连
走哪个专家都得对齐
异步跑得快只是第一层问题。
RL 训练更麻烦的是,生成这条轨迹的模型,和随后计算梯度的 Trainer,看到的可能根本不是同一条轨迹。
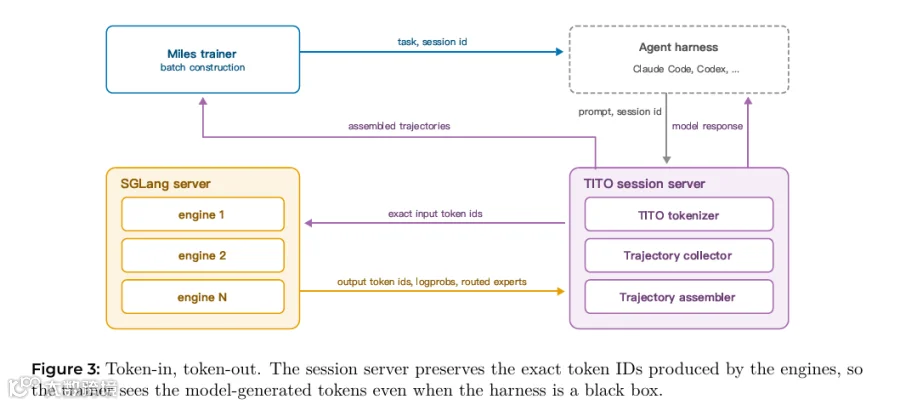
Agent 输出经过消息解析、工具调用和 Chat Template 后,再重新 Tokenize,一处细微变化就可能让训练端得到不同 Token。Miles 为此设计了 Token-In-Token-Out(TITO) Session Server。
简单来说,不再让 Agent Harness 自己重新拼 Token,而是直接保存 SGLang 真正生成过的 Token ID、Log Probability 和路由信息。
这样 Trainer 学到的,才是模型真实生成过的那条轨迹。
MoE 还会多一层麻烦。
即使 Token 完全相同,训练端和推理端数值存在细微差异,也可能让一个 Token 在 Rollout 时进入专家 {2,7},训练时却进入 {2,8}。
Miles 因此接入 Rollout Routing Replay(R3),把每个 Token 实际选择过的专家一起保存下来,训练时直接重放原来的路由,而不是重新计算。
这其实点出了 Miles 很重要的一条设计思路。先保证训练的对象真的是刚才生成的数据,再谈RL算法本身。
03
Kimi K2权重更新从53秒压到7秒,
差距出在系统链路
模型一旦来到数百B甚至1T参数,另一个非常现实的问题出现了。
每训练一步,都要把新权重送回 Rollout 集群。
传统 NCCL Broadcast 在大集群上会越来越重。论文测试中,GLM-5 744B-A40B 的一次 Broadcast 需要 58.30 秒,改用 Miles 的点对点权重传输(Peer-to-Peer,P2P)后只需要 8.48 秒,缩短85.5%。
Kimi K2 1T-A32B 更明显,53.28 秒降到7.23秒,缩短86.4%。

Miles 也把显存问题直接放进系统设计。
全参数训练里,FP32 Master Weight 和两个 Adam Moment 合计每个参数要占约 12 Bytes。对于特别大的模型,Miles 可以把 Optimizer State 按 Bucket 流式放到磁盘。
在 Qwen3-30B-A3B 上,这套机制让训练 Actor 的 Offload 时间从 24 秒降到5.2秒,Reload 从 8.9秒降到1.3秒。
但团队也明确给出了边界。P2P并不是任何场景都更快。单节点环境下,它在论文测试中反而可能比 Broadcast 慢最多约70%,所以 Miles 仍把 Broadcast 作为默认方案。
04
64张GB300,把744B Agentic RL
完整跑了一遍
最后真正检验系统的,不是单个 Microbenchmark。
RadixArk 用 Miles 对 GLM-5.2 744B-A40B 做了一次完整 Agentic RL 实验。
整个集群使用 64 张 NVIDIA GB300,其中 32 张负责 Rollout,32 张负责训练。任务来自 Terminal-bench-2,每个 Agent 在独立 Sandbox 中操作终端,单个 Session 最长支持 65,536 Token,整个系统采用完全异步调度。
结果里最直观的是速度。
前30个测量 Step 的中位训练时间为263秒。Rollout 和 Training 在两次权重更新之间持续并行,集群里通常同时有大约90到100个请求正在生成。
整个100步实验中,Train-Inference KL 均值为 0.0369。任务原始 Reward 的9步移动平均则从 0.438 上升到0.556。
不过论文没有把最后这个数字包装成“能力提升”。作者专门提醒,这只是一次100步、单一任务分布上的运行,无法排除不同Run之间的随机波动。
这也很符合 Miles 整篇报告的气质。
它没有试图再造一个新的 RL Objective,而是把大量真正会让大规模训练失败的工程问题放到一张图里解决。Token 要一致,MoE 路由要一致,Rollout 不能闲着,Trainer 不能被显存卡住,数百B乃至1T参数的权重还得足够快地送回推理集群。
因此 Miles 更准确的定位并不是“又一个 RL 框架”。
它更像是在把大模型 Post-Training 从一套实验代码,往可验证、可扩展、能长期运行的 AI Infra 推进。
END
关注+星标,获取AI前沿进展与开源一线动态