


新智元报道

2022年底,ChatGPT的横空出世点燃了AI时代的烽火,“ChatGPT时刻”成为智能起点的代名词。然而,在算法的瞩目之外,中国算力基础设施同样在默默发力——国产首个十万卡AI超集群曙光8000(登峰)正是其中的大国重器。

近日,央视大型纪录片《超级工程》回归,首次将中国算力基础设施推向台前,全面复盘了曙光8000从技术路线选择、关键技术攻关到工程交付与科研应用的全过程。
2021年底曙光8000立项时,AI尚处于“小模型时代”。受限于算力、数据规模与算法架构,模型多执行人脸识别等判别式任务,鲜有人预见到智能时代对“超级机器”的渴求。但中科曙光团队果断决策:耗时5年,部署10万张国产智能计算芯片,打造一台既能进行高精度科学计算,又能训练AI大模型的AI超集群。

超智融合:在无人区押中算力演进之路
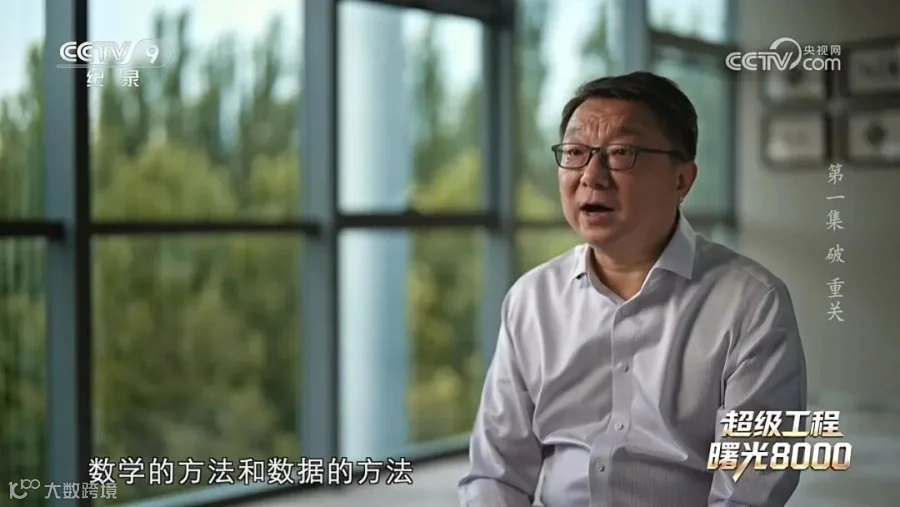
超集群的研制周期长,技术路线的选择关乎未来数年的市场需求。当时,传统高性能计算擅长高精度数学计算,而智能计算追求低精度高吞吐,两者往往需要跨平台调度。时任中科曙光总裁历军前瞻性地预判:未来“数学的方法和数据的方法同等重要”。
为此,中科曙光提出“超智融合”路线,经过与业界专家长达一年的反复论证,最终决定让高精度科学计算与低精度智能计算在同一套系统内运行,覆盖从FP64到INT8的多种计算精度。
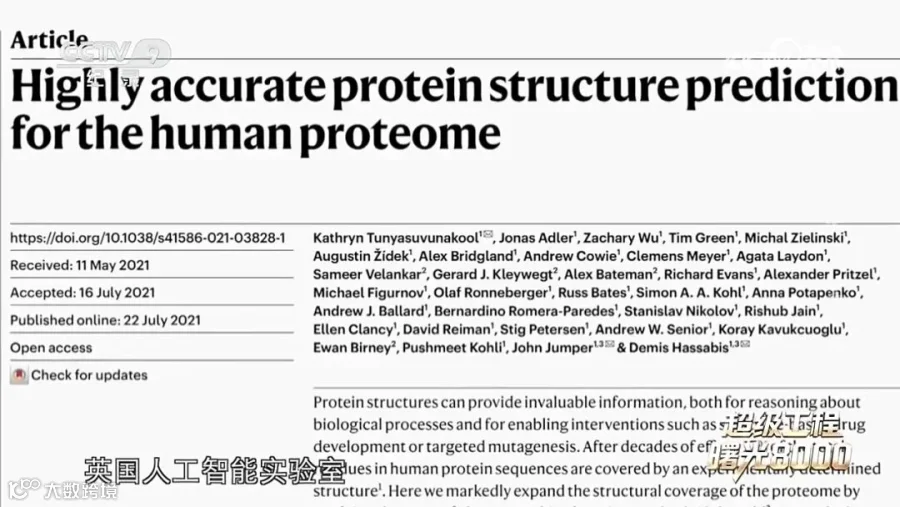
这一决策很快显现出独特的战略价值。随着大模型及AI for Science的爆发,未来的算力标准恰恰需要“算得准”与“算得快”兼得。凭借超智融合路线的精准押注,曙光8000将全精度计算纳入同一系统,一台机器既能模拟气候变化、探索生命密码,也能高效训练大模型。
十万卡规模:跨越全栈自研的极限工程
路线确定后,团队面对的是横跨60多个细分学科、800多道工业工序的超级工程。从6万卡跨越至10万卡,绝非简单的数量叠加。10万张芯片运行一小时产生的热量,约等于12吨标准煤燃烧的放热量;节点网络传输需达到800G/秒,数据读写时间要压至0.202毫秒。计算、网络、存储、供电、散热,任何一环的短板都会导致整机停摆。
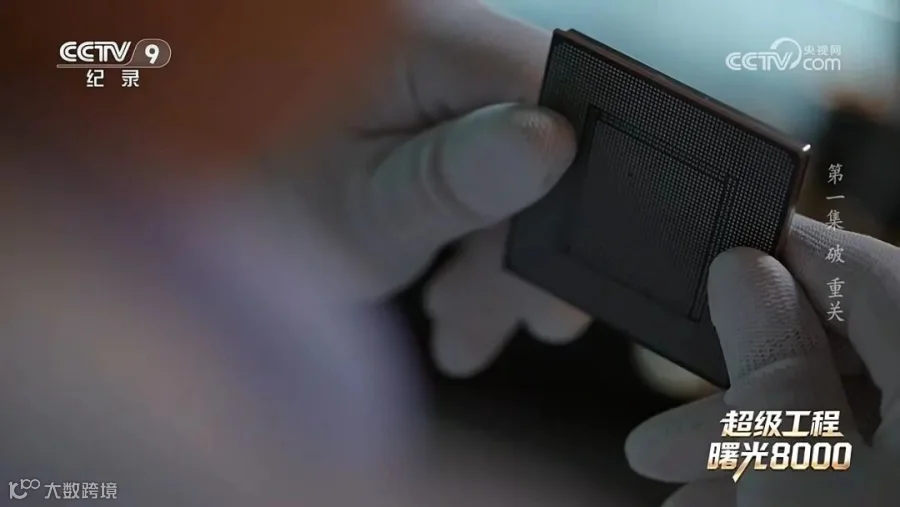
更棘手的是,部分关键环节在国内尚属空白。为实现8颗智算芯片的高速互联,团队必须自研高效的数据交换芯片。面对无现成答案的困境,团队从芯片、计算、存储到液冷散热逐个攻坚。

例如,网络团队在交换芯片中设计了“智能开关”,一旦链路故障,信号可在毫秒级自主切换至备用路径。最终,曙光8000实现了“芯片-计算-存储-网络-散热-应用-服务”全链路核心技术的全面国产化。
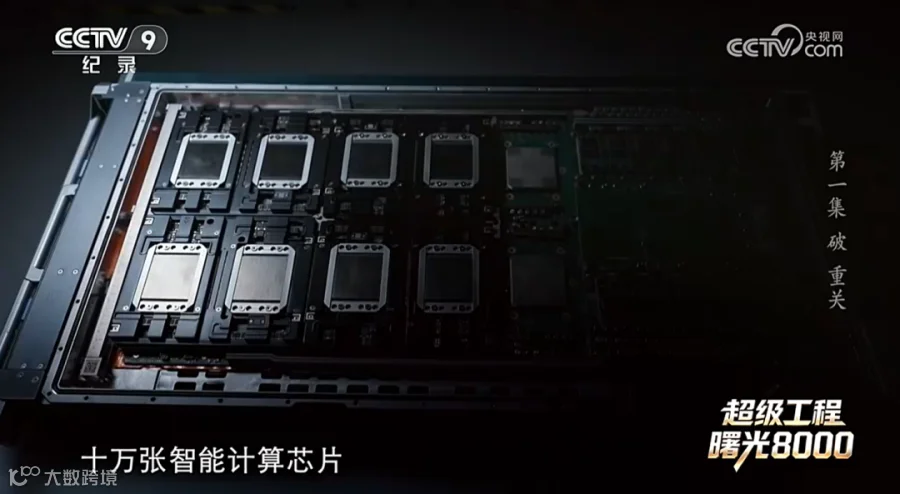
80多组高密度机柜,超过1万个计算节点,其真正的难度在于:一秒钟的设计运算量,相当于全球80亿人昼夜不停连续计算200年。如此庞大的系统,必须依靠全链路的无短板设计来保障长期稳定运行。


三十载初心:中国算力的自主崛起
巨额工程清单的背后,是中科曙光团队三十余年在高性能计算领域的深耕。20世纪80年代,国内曾因租用超级计算机而在严格监控下操作,这深深刺痛了以李国杰院士为代表的中国算力拓荒者。
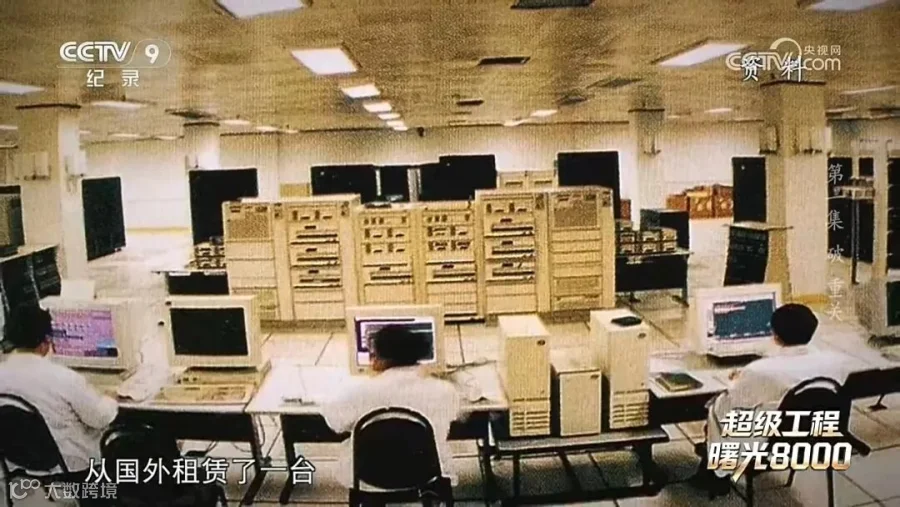
1991年,团队立下“人生能有几回搏”的誓言,研制出峰值运算速度达每秒6.4亿次的曙光一号,彻底改变了国内高性能计算受限的局面。
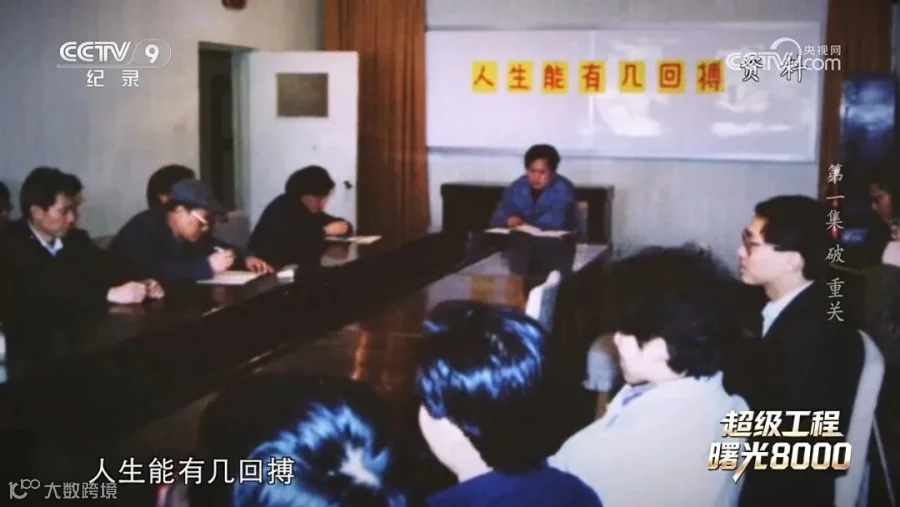
三十多年后,当年需要曙光一号运行一天的计算,如今普通手机不到一秒即可完成。但研发人员的脚步从未停歇。正如中科曙光现任董事长历军所言:“起步稍晚,就试着跑得更快一点。”三十年间,团队保持着一代接一代的接力攻坚。

到了曙光8000,多年的技术积累被全面激活。超智融合架构研发、十万卡网络存储协同、建筑供电联调等数千人数千个日夜的心血,最终在整机测试中迎来集中验证。

“好钢用在刀口上,用在真正解决国家最急需要解决的一些问题上,曙光,是个好钢。”比起超集群本身,中科曙光团队提前押注的战略眼光,以及将选择一寸寸落地的三十年坚持,才是该项目最核心、最难复制的壁垒。中国科技的每一次飞跃,答案都藏在一代代科技工作者用青春作出的选择与坚持之中。

关于曙光8000的故事还在继续。从技术攻关到整机落地,再到真正赋能千行百业的科研时刻,更多答案正在纪录片接下来的篇章中逐步揭晓。